개의 귀를 골랐는데 몸 전체가 선택된다면: AttnSeg의 공간 전달과 학습 목표
사진에서 “개의 왼쪽 귀”를 선택하고 싶은데 개 전체가 잡힌다. 이 상황에서 더 큰 분할기로 바꾸기 전에 확인할 것은 언어 모델이 이해한 선택 범위가 분할기까지 살아서 전달되는지다. AttnSeg 논문은 대상의 위치뿐 아니라 어느 크기의 영역을 뜻하는지도 전달하도록 인터페이스와 학습 목표를 함께 바꾼다. 다만 귀만 고르면 즉시 해결된다는 제품 사용법은 아니다. 개의 귀 사례는 저자들이 든 설명 예시이며, 이 글에서 실행한 편집 테스트가 아니다.
먼저 실무 판단을 요약하면 이렇다. 대상 자체를 잘못 찾았다면 언어·영상 해석을, 위치는 맞지만 전체 물체로 번졌다면 공간 전달과 범위 학습을, 범위는 맞지만 테두리가 거칠다면 경계 복원을 각각 의심한다. 세 증상을 같은 “마스크 품질 부족”으로 묶어 분할기만 강화하지 말자는 것이 이 연구를 읽는 유용한 출발점이다. 아래 진단표는 이 구분을 구체화한 편집 분석이다.
먼저 구분할 실패: 다른 물체, 잘못된 범위, 거친 경계
픽셀 분할은 이미지의 각 위치가 선택 대상인지 판단해 마스크를 만드는 작업이다. 자연어를 함께 쓰면 “무엇을 뜻하는가”와 “어느 픽셀까지 포함하는가”가 연결되어야 한다. 귀, 머리, 몸 전체는 같은 이미지에서 서로 포개지는 영역이지만 사용자의 의도는 다르다. 개 쪽을 가리킨다는 정보만으로는 셋 가운데 어느 범위를 골랐는지 충분히 전달되지 않을 수 있다.
논문이 문제 삼는 대표 구조에서는 시각·언어 모델(VLM)이 이미지와 문장을 처리하고, 특수 토큰 [SEG]의 마지막 은닉 상태를 하나의 벡터로 분할기에 넘긴다. 분할기는 이미지를 받지만 원래 지시 문장을 직접 보지 않는다. 따라서 선택의 언어적 뜻은 그 벡터를 통과해야 한다. 저자들은 공간 좌표가 명시되지 않은 이 전달 방식이 특히 물체 부분처럼 세밀한 범위를 지정할 때 병목이 될 수 있다고 설명한다. 벡터가 어떤 정보도 담을 수 없다는 보편적 정리가 아니라, 조사한 구조와 실험에서 검토한 가설로 읽어야 한다. 원문 §3.1
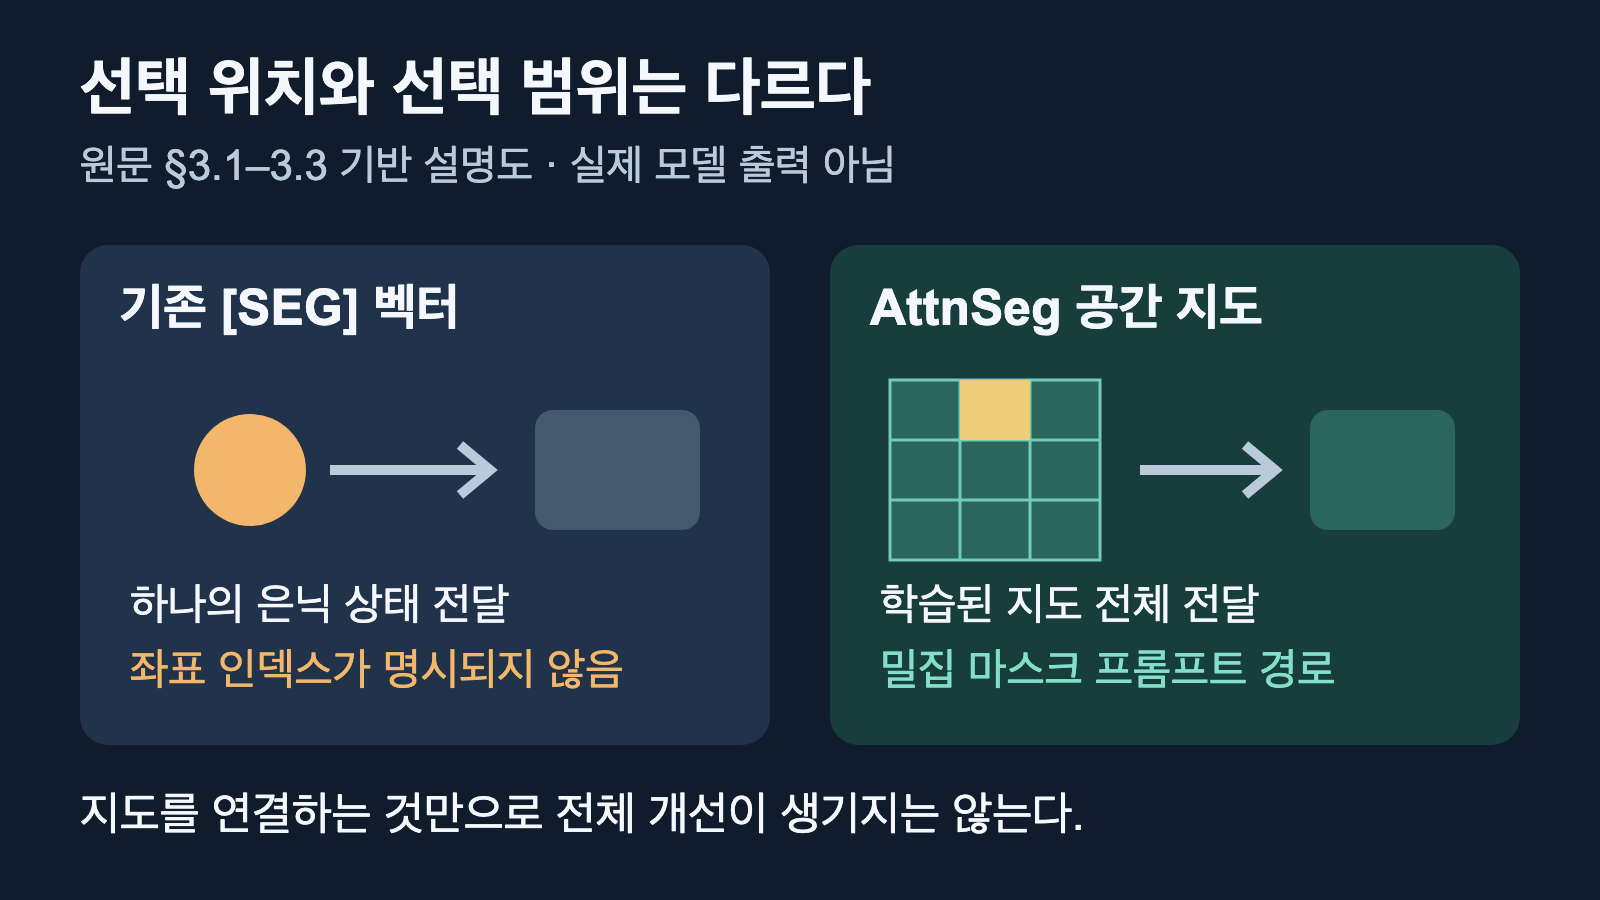
위치와 범위 전달의 설계 차이. 원문 §3.1–3.3 기반 원본 설명도이며 실제 모델 출력이 아니다. 출처: arxiv.org/html/2610.18729v1.
위 그림은 논문의 전달 원리를 새로 그린 설명도다. 실제 모델의 어텐션이나 결과 마스크를 캡처한 화면이 아니다. 좌표가 있는 신호를 보존한다는 설계 차이를 보여주며, 도식의 색이나 칸 수에 측정 의미는 없다.
AttnSeg는 히트맵을 보여주는 데서 끝나지 않는다
AttnSeg가 사용하는 것은 [SEG] 토큰이 이미지 패치들에 보내는 어텐션이다. 이미지 패치는 그림을 격자로 나눈 작은 영역으로 생각하면 된다. 각 레이어와 헤드의 어텐션은 이 격자 위에 위치별 값을 남긴다. 저자들은 이 지도들을 단순 평균하지 않고, 학습한 양수·음수 가중치로 결합한다. 중요한 신호를 더하고, 방해되는 신호를 빼는 방식이다. 결합된 지도는 기존 단일 은닉 벡터를 대신해 분할기의 밀집 마스크 프롬프트 경로로 들어간다.
여기서 밀집이라는 말은 지도 전체를 전달한다는 뜻이다. 가장 밝은 점 몇 개만 뽑거나 임계값으로 잘라 이진 마스크로 바꾸는 방식이 아니다. 부록 C에 따르면 결합 지도는 정규화·크기 조정·로짓 변환을 거쳐 프롬프트 인코더에 전달된다. “원시 어텐션을 그대로 연결한다”는 설명도 정확하지 않다. 학습된 결합과 입력 변환이 포함된다. 원문 §3.3 및 부록 C
학습도 두 부분으로 분리한다. 앞 단계에서는 VLM과 지도 결합 가중치가 대상의 위치와 범위를 배우고, 분할기는 참여하지 않는다. 다음 단계에서는 VLM과 결합 가중치를 함께 고정하고 분할기만 그 지도를 읽어 경계를 다듬는다. VLM만 고정하고 결합 가중치를 계속 바꾸면 공간 지도가 고정되지 않는다는 부록의 주의도 중요하다. 그래서 이 방법은 학습 없는 프롬프트 요령이나 설명용 히트맵 시각화가 아니라, 학습 목표와 전달 경로를 함께 설계한 시스템이다.
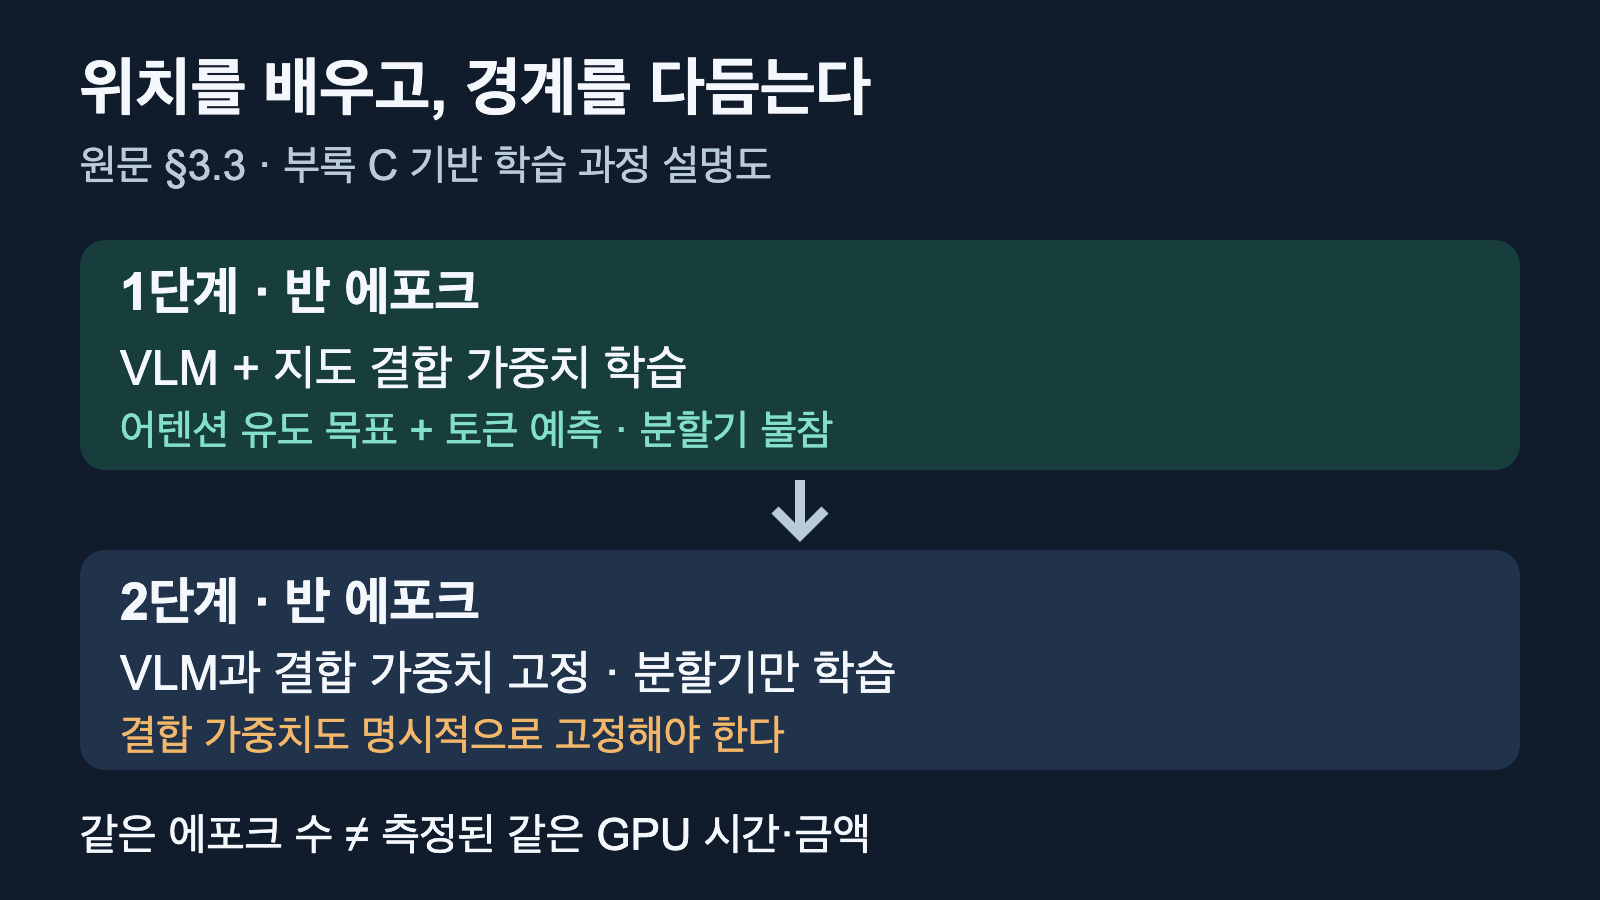
각 반 에포크의 학습 분리. 부록 C처럼 결합 가중치도 고정하며 같은 에포크는 같은 GPU 비용의 증거가 아니다. 출처: arxiv.org/html/2610.18729v1.
숫자는 두 기준을 섞지 않아야 한다
가장 먼저 볼 비교는 같은 데이터 혼합과 같은 에포크 예산으로 추가 학습한 기준 모델이다. 원문 표 3의 Sa2VA-InternVL2.5-4B에서 기존 인터페이스로 한 에포크 학습한 모델은 ReasonSeg 59.92, GS-Eval 62.55 gIoU다. AttnSeg는 각각 64.11과 72.11을 보고한다. 차이는 4.19점과 9.56점이다. 이것을 성공률이 그만큼 올랐다고 쓰면 안 된다. gIoU는 질의별 마스크의 교집합/합집합 비율을 구하고 질의마다 같은 무게로 평균한 지표다. 원문의 표기 척도에서 나온 점수 차이다.
| 표 3의 누적 조건 | ReasonSeg gIoU | GS-Eval gIoU | 읽어야 할 차이 |
|---|---|---|---|
| 기존 인터페이스 추가 학습 | 59.92 | 62.55 | 동일 데이터·에포크 비교의 기준 |
| 여기에 어텐션 인터페이스 추가 | 60.18 | 63.64 | 지도 경로만 추가했을 때의 변화 |
| 여기에 어텐션 유도 목표 추가, AttnSeg | 64.11 | 72.11 | 최종 방법 |
인터페이스 추가 단계의 차이는 ReasonSeg 0.26점, GS-Eval 1.09점이다. 그 다음 어텐션 유도 목표를 추가한 누적 단계의 차이는 3.93점과 8.47점이다. 즉 전체 개선을 “벡터를 지도로 바꾸니 좋아졌다” 하나로 설명할 수 없다. 이 표는 누적 제거·추가 실험의 관측이며, 모든 구성 요소의 독립적인 인과 효과를 완전히 분해한 실험으로 확대해서도 안 된다. 원문 §4.3 표 3
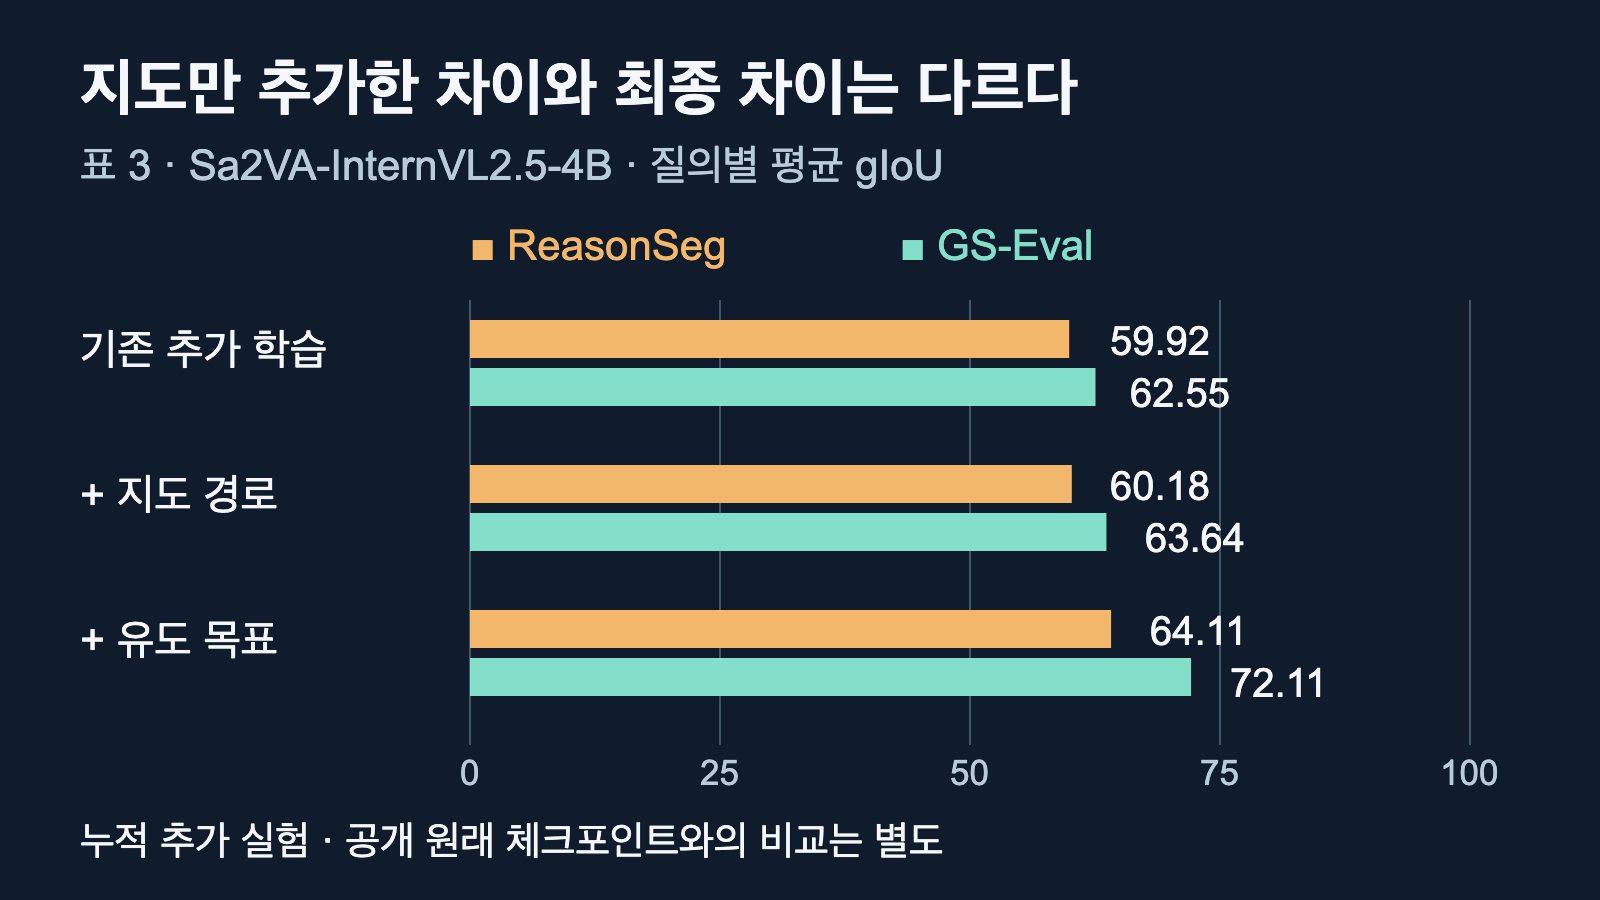
Sa2VA-InternVL2.5-4B 누적 추가 실험의 보고값. 0–100 영점 축이며 공개 원래 체크포인트 비교나 편집 성공률이 아니다. 출처: arxiv.org/html/2610.18729v1.
다른 비교도 있다. 표 1에서는 공개된 원래 체크포인트를 기준으로 GS-Eval의 물체 부분 점수가 17.80에서 35.29로, 하늘·잔디 같은 stuff 영역 점수가 90.80에서 91.20으로 바뀐다. 세부 부분에서 변화가 크고 넓은 영역에서는 작다는 패턴이다. 그러나 이 기준 모델은 앞의 동일 예산 추가 학습 모델이 아니다. 물체 부분의 큰 차이를 동일 예산 비교의 개선량처럼 인용하면 두 실험을 섞게 된다. 또한 최종 물체 부분 점수 자체가 완벽한 선택을 뜻하지 않는다. 원문 §4.2 표 1
표본을 읽는 한계도 남는다. 보존한 설정·표·부록에서는 이 글이 사용할 정확한 평가 질의 수와 반복 학습 시드 수를 확정하지 못했다. 원문은 동일 시드를 쓴다고 설명하지만, 여기서 별도의 다중 시드 재현이나 독립 검증을 수행한 것은 아니다. 질의별 평균 점수를 원시 성공 건수로 환산하거나 실제 편집 작업의 신뢰구간으로 바꾸지 않는다. 두 백본은 크기뿐 아니라 세대도 다르므로 모델 크기를 키운 인과 효과를 결론내리지 않는다.
독자가 적용할 수 있는 진단표
위치가 맞는데 범위가 틀리면, 경계 정밀도와 선택 범위를 같은 실패로 묶지 않는다. 아래 순서는 기존 시스템에서 확인할 증거를 정리한 것이지, AttnSeg 코드를 설치해 같은 결과를 얻었다는 기록이 아니다. 가능하면 자신의 데이터에서 “전체 물체”와 “그 물체의 부분”을 짝으로 요청하고 전달 신호와 최종 마스크를 따로 확인한다. 이 짝 비교는 이 글의 제안이며 논문의 새 벤치마크 결과가 아니다.
| 관찰한 증상 | 먼저 남길 증거 | 검토할 설계 | 성급히 내리면 안 되는 결론 |
|---|---|---|---|
| 귀 대신 다른 개가 선택됨 | 입력 문장·이미지와 대상 위치의 해석 | VLM의 지시 해석과 대상 구분 | 분할기를 키우면 뜻도 자동으로 교정된다 |
| 개는 맞지만 귀 대신 몸 전체가 선택됨 | 귀 요청과 전체 개 요청의 전달 신호·마스크 | 부분 범위가 전달되는지, 범위를 직접 학습하는지 | 어텐션 지도만 연결하면 모든 개선이 생긴다 |
| 귀 범위는 맞지만 경계가 거침 | 전달 지도와 최종 경계의 차이 | 경계 복원과 분할기 쪽 처리 | 언어 이해가 실패했다 |
| 하늘 등 큰 영역만 잘 됨 | 부분·단일 물체·넓은 영역별 평가 | 전체 평균에 가려진 세부 선택 오류 | 전체 평균이 좋으므로 부분 편집도 안전하다 |
이 진단 순서는 논문에 근거한 편집 분석이며, 실제 편집 제품에서 효과를 측정한 해결 절차가 아니다. 특히 어텐션이 뾰족해 보인다는 이유만으로 지시를 올바르게 이해했다고 판단하지 말아야 한다. 저자들도 자신 있게 잘못된 대상을 고른 경우, 더 선명한 지도가 오히려 분할기의 교정을 어렵게 할 수 있다고 윤리 진술에서 경고한다. 자동 선택을 곧바로 파괴적인 삭제·변경에 연결하지 않고 사용자의 의도와 마스크를 확인할 이유다. 이 마지막 운영 권고는 연구 결과를 바탕으로 한 편집 판단이다.
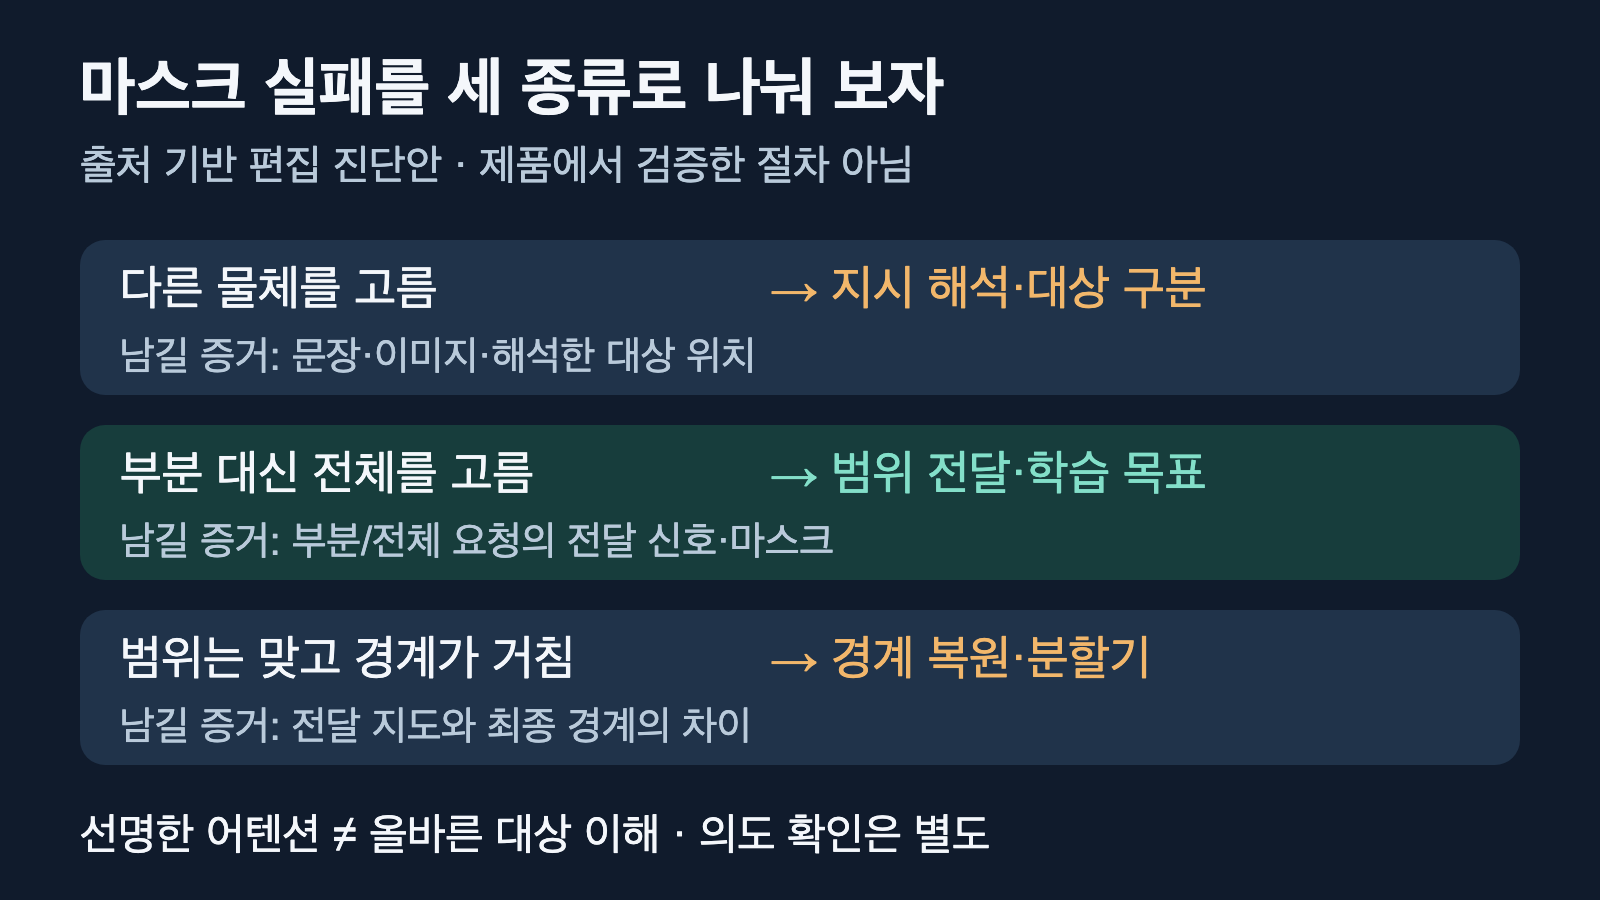
논문을 바탕으로 작성한 편집 진단안. 실제 제품에서 검증한 절차가 아니며 선명한 어텐션만으로 지시 이해를 보장하지 않는다. 출처: arxiv.org/html/2610.18729v1.
비용·공개 상태·권한: 당장 설치할 도구는 아니다
두 학습 단계는 각각 같은 혼합 데이터의 반 에포크를 사용한다. 따라서 합친 에포크 수가 기준 추가 학습과 같다는 설명은 가능하다. 하지만 같은 에포크는 같은 GPU 시간이나 같은 금액의 증거가 아니다. 어텐션을 읽기 위해 융합 커널 옆에서 [SEG] 행을 다시 계산하고, 레이어마다 추가 행렬 곱이 생긴다. 부록 F는 이 추가 계산이 시퀀스 길이에 선형이라고 설명한다. 여기서 종단간 지연이 줄었다거나 비용이 없다는 결론은 나오지 않는다. 도입을 검토하는 팀은 자신의 입력 길이·대상 수·학습 환경에서 메모리와 시간을 별도로 측정해야 한다. 원문 §4.1 및 부록 F
공개 상태도 구분해야 한다. 2026년 10월 14일 보존한 저자 프로젝트 페이지에서는 Paper soon과 Code soon 버튼이 실제 다운로드 대신 #를 가리켰다. 반면 초록은 코드와 모델이 제공된다고 표현한다. 이 글에서는 그 문구를 설치 가능 확인으로 사용하지 않는다. 조사한 페이지에서 구현·가중치 다운로드를 확인하지 못했다는 범위까지가 결론이며, 어디에도 저장소가 없다는 증명은 아니다. 원문을 읽어 설계를 검토하는 단계와, 설치하여 성능을 재현하는 단계가 아직 분리되어 있다. 저자 프로젝트
가중치나 구현을 내려받을 수 있을 때도 논문 접근 권한과 제품 사용 허가는 별개다. 실제 코드·모델·기반 체크포인트·데이터의 각각의 이용 조건을 확인해야 하며, 이 글이 상업 이용을 승인하는 것은 아니다. 본문 그림은 타사 논문 그림이나 실제 사용자 사진을 복사하지 않고, 전달 원리·학습 분리·공개 표의 수치·진단 순서를 별도 레이아웃으로 작성했다. 연구 점수는 출처의 보고값이지 이 글의 실행 결과가 아니다.
결론: 더 큰 분할기보다 전달과 목표를 먼저 질문하자
AttnSeg의 핵심은 “언어 모델은 어디를 보았는가”를 화면에 보여주는 것이 아니라, 그 공간 신호를 분할기가 받는 입력으로 삼고 원하는 범위를 직접 학습시키는 데 있다. 같은 예산의 추가 학습 기준과 비교해도 개선이 보고되지만, 지도 경로만으로 얻는 차이는 훨씬 작다. 전달 표현과 학습 목표를 분리해 점검해야 하는 이유다.
이 자료는 arXiv v1 프리프린트이며, 검토한 출처에서 동료심사 채택을 독립 확인하지 않았다. 평가는 조사한 백본과 이미지 분할 벤치마크의 범위다. 일반 GUI 클릭, 삼차원 질의응답, 실제 사용자 편집 성공률로 옮겨 읽지 않는다. 관련 링크는 같은 문제를 직접 다루는 검증된 기존 글이 확인되지 않아 억지로 붙이지 않았다. 남길 질문은 구체적이다. 내 시스템은 귀와 몸을 구분할 공간 범위를 넘기고 있는가, 그리고 그 범위를 학습 목표가 직접 요구하는가?
출처와 확인 범위
- Segment Where You Look: Attention as the Interface Between Language Models and Segmenters, arXiv:2610.18729v1 — 2026년 10월 13일 v1. 방법은 §3, 비교는 §4 표 1·3, 구현·비용 한계는 부록 C·D·F를 읽었다.
- 버전 고정 원문 본문 — 질의별 평균 gIoU, 누적 추가 실험, 학습 분리와 추가 계산의 근거.
- 저자 프로젝트 페이지 — 2026년 10월 14일 보존본에서 링크 공개 상태를 확인했다. 이후 공개 상태는 달라질 수 있다.
확인 범위: 원문·프로젝트 보존 증거 검토와 출처 기반 편집 분석. 독립 모델 실행, 벤치마크 재현, 사용자 편집 실험은 수행하지 않았다.


댓글
댓글 쓰기