EmbeddingGemma 2 로컬 검색: 인코더·벡터 차원·정밀도·공유 입력 예산을 나눠 설정하기
로컬 문서 검색이 느리거나 메모리가 부족할 때, 임베딩 차원부터 줄이는 것이 항상 정답은 아니다. 모델을 메모리에 올리는 비용, 코퍼스 벡터를 저장하는 비용, 추론 중 숫자의 표현 범위, 한 입력에 담을 수 있는 자료량은 서로 다른 문제다. EmbeddingGemma 2는 이 네 축을 따로 조정할 수 있어 유용하지만, 서로를 대신하는 옵션으로 이해하면 실패 원인을 놓치기 쉽다.
Google의 새 모델은 텍스트와 코드, 이미지, 영상, 오디오를 같은 임베딩 공간에 넣는다. 검색 결과를 직접 작성하는 생성 모델이 아니라, 자료 사이의 의미적 관계를 검색·분류·군집화에 활용하도록 벡터로 표현하는 모델이다. 이 글의 목표는 출시 소식을 옮기는 데 있지 않다. 개인 문서나 미디어 검색을 구현하는 독자가 어느 설정을 먼저 바꾸고 어떤 비교를 남길지 결정할 수 있도록, 공식 모델 카드의 설정을 배포 단계별로 나눠 본다.
이 글은 공식 자료에 근거한 설정 분석이며, 모델 추론이나 한국어 검색 품질을 독립 재현한 결과가 아니다. 아래 수치는 고정된 공식 모델 카드의 보고값 또는 그 값에 대한 산술이다. 실제 기기 메모리와 검색 지연, 사내 문서의 적중률을 측정한 값으로 읽어서는 안 된다.
1. 인코더 생략은 모델 로딩의 문제다
공식 카드의 전체 모델 규모는 740M 파라미터다. 텍스트 부분 270M에 비전 인코더 170M과 오디오 인코더 300M이 더해진다. 따라서 ‘270M 경량 모델’이라는 설명을 전체 멀티모달 구성이 그 크기라는 뜻으로 읽으면 안 된다. 필요한 입력 종류에 따라 로드할 구성요소가 달라진다는 뜻이다.
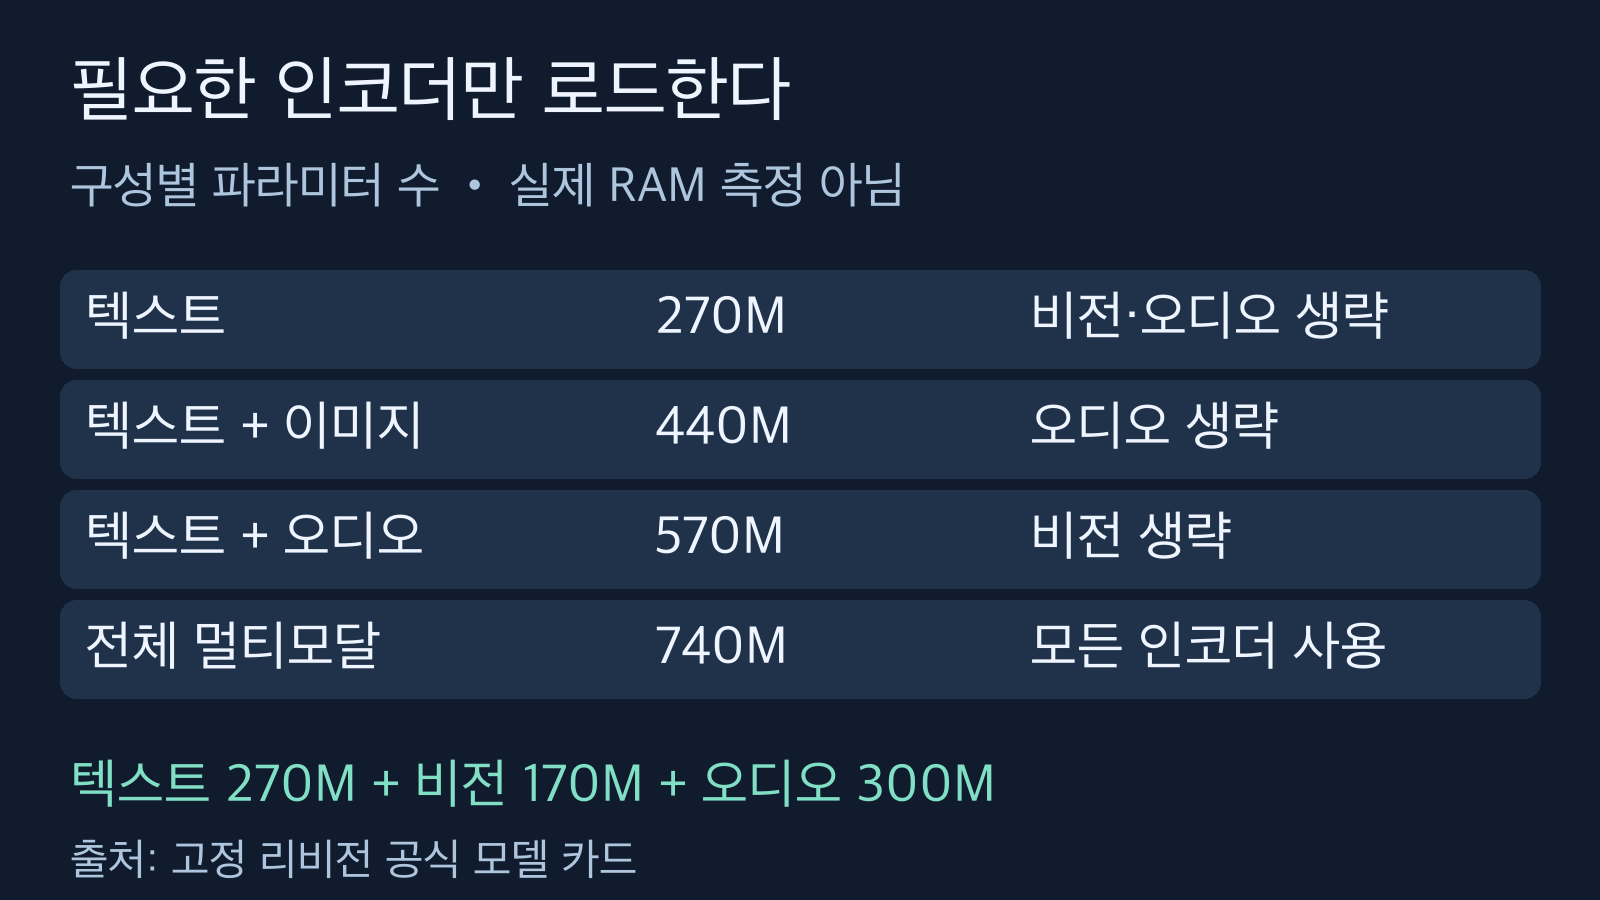
인코더 생략은 로딩할 기능을 고르는 설정이다. 파라미터 수는 RAM 실측치가 아니다. 출처: huggingface.co/google/embeddinggemma-2/raw/914f7f89142e33e77833254d9c9b90c3cef7303b/README.md.
SentenceTransformers 기준으로 텍스트 전용은 config_kwargs={"vision_config": None, "audio_config": None}, 텍스트와 이미지는 {"audio_config": None}, 텍스트와 오디오는 {"vision_config": None}가 공식 안내다. 두 미디어 인코더를 모두 쓰는 구성은 생략 설정을 넣지 않는다. 이 구문은 모델 카드가 제시한 라이브러리별 방법이지, MLX나 모든 런타임에 같은 키를 넣으라는 보편 규칙이 아니다.
사진 검색이 필요한데 비전 인코더를 끄는 것은 메모리 최적화가 아니라 요구 기능을 제거하는 선택이다. 반대로 코드 저장소만 색인한다면 사용하지 않는 미디어 인코더를 그대로 올릴 이유부터 검토할 수 있다. 파라미터 수는 구성 비교용이며, 그대로 기기의 RAM 사용량으로 바꾸지 않는다. 가중치 표현, 실행 버퍼와 배치 크기가 별도로 관여하기 때문이다. 출시문에 나온 특정 휴대전화의 양자화 메모리 관찰값도 다른 기기의 보장값으로 가져오지 않았다.
2. 벡터 차원은 저장량과 검색 품질의 문제다
네이티브 출력은 768차원이다. MRL을 이용하면 앞쪽 512, 256, 128차원을 유지해 벡터를 줄일 수 있다. 같은 자료형과 벡터 개수라면 256차원의 원소 수는 768차원의 3분의 1, 128차원은 6분의 1이다. 이는 벡터 원소 자체의 비율이다. 메타데이터·인덱스 연결 구조·저장소 오버헤드까지 포함한 데이터베이스 전체가 같은 비율로 줄어든다는 보장은 아니다. 또한 출력 차원을 줄인다고 모델의 모든 인코더 가중치가 함께 작아지는 것도 아니다.
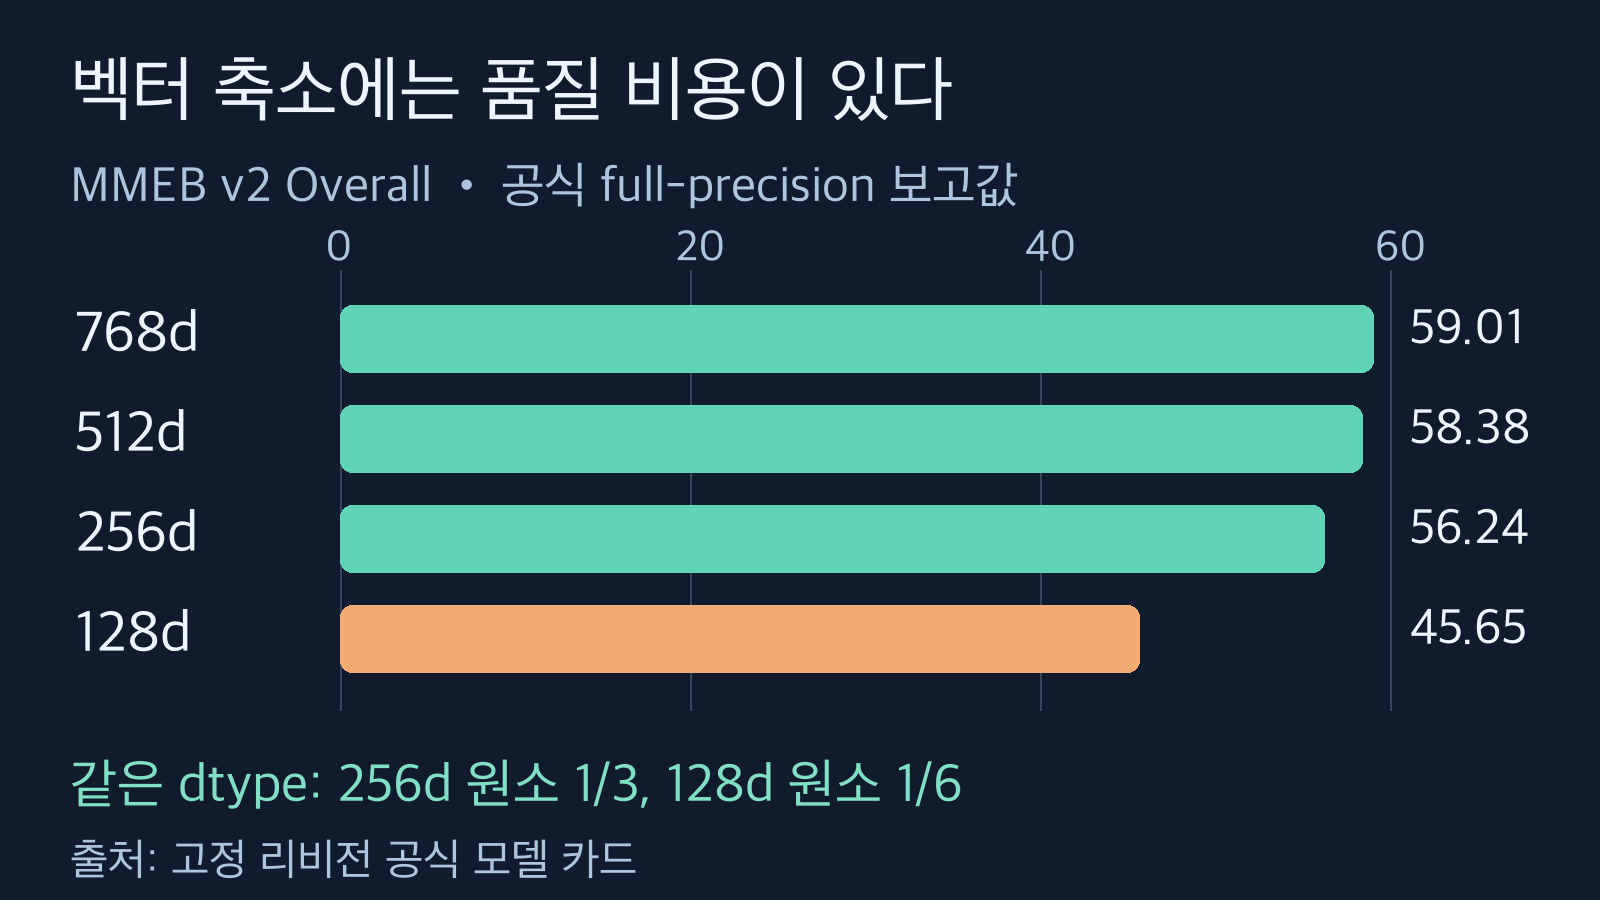
공식 집계 점수를 0 기준 같은 축으로 표시했다. 128차원의 멀티모달 저하를 저장 원소 절감과 함께 읽어야 한다. 출처: huggingface.co/google/embeddinggemma-2/raw/914f7f89142e33e77833254d9c9b90c3cef7303b/README.md.
공식 full-precision 체크포인트의 MMEB v2 Overall 보고값은 768차원 59.01, 512차원 58.38, 256차원 56.24, 128차원 45.65다. 768에서 256으로 줄였을 때 표시값 차이는 2.77점, 128로 줄였을 때는 13.36점이다. 이것은 집계 점수 차이이지 ‘검색 정확도가 13.36% 떨어졌다’는 뜻이 아니다. 카드의 광범위한 ‘최대 6배 절감’ 문구보다, 차원별 표와 128차원에서 멀티모달 품질이 크게 저하된다는 구체적 주의를 우선 읽는 편이 안전하다.
텍스트 전용이라도 가장 작은 차원을 곧바로 운영 기본값으로 삼지는 말자. 한국어 질의, 짧은 코드 이름, 비슷한 사진처럼 실제 검색에서 헷갈리는 자료를 고정해 차원별 순위를 비교하는 것이 좋다. 이는 이 글의 검증 제안이며, 해당 자료로 성능 실험을 완료했다는 주장이 아니다. 공식 다국어 지원 역시 모든 언어에서 동일한 품질을 보장하지 않는다.
3. 차원을 바꾸면 질의와 코퍼스를 함께 맞춘다
벡터의 앞부분을 잘랐다고 단위 길이가 유지되는 것은 아니다. 모델 카드는 잘린 벡터를 코사인 유사도에 쓰기 전에 L2 정규화하라고 명시한다. 또한 질의 벡터와 문서 벡터는 같은 차원이어야 한다. 기존 코퍼스는 768차원인데 새 질의만 256차원으로 만드는 식의 전환은 유효한 비교가 아니다.
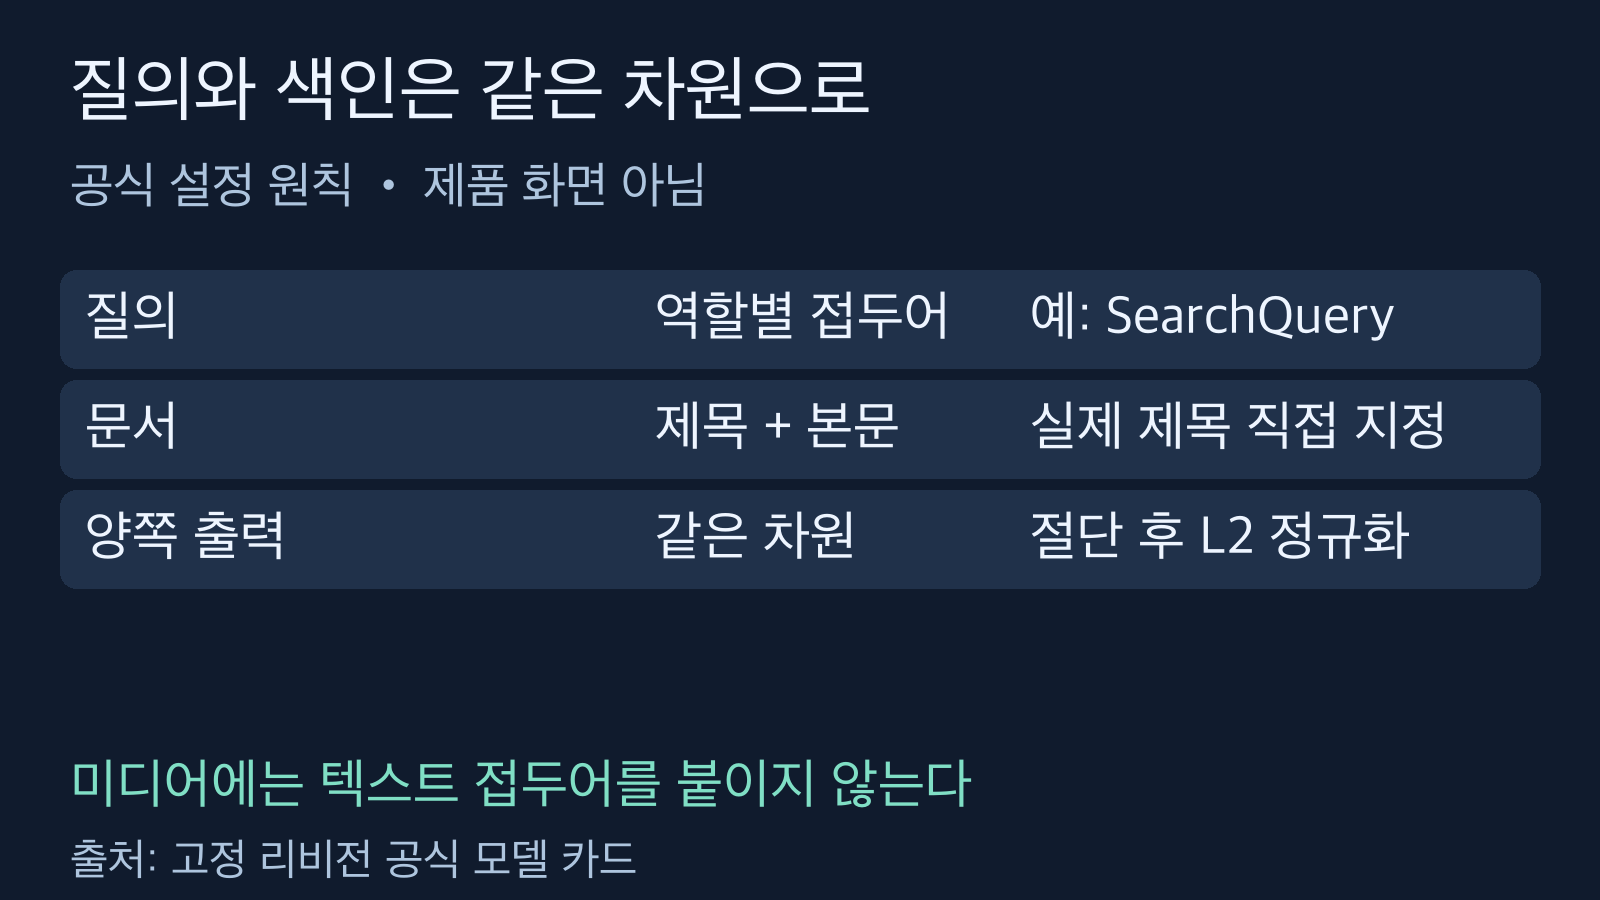
접두어의 역할은 다르지만 검색에 비교할 출력 차원은 같아야 한다. 절단 뒤에는 정규화한다. 출처: huggingface.co/google/embeddinggemma-2/raw/914f7f89142e33e77833254d9c9b90c3cef7303b/README.md.
카드는 model.encode()의 truncate_dim과 normalize_embeddings=True 사용을 안내한다. 실제 구현에서는 색인 생성과 질의 생성 양쪽에 같은 차원 정책을 적용한다. 기존 벡터를 축소해 새 색인으로 전환한다면 저장 벡터의 정규화 상태도 확인하고, 이전 색인을 보존한 채 고정 질의의 결과를 비교한 뒤 전환하는 것이 유용하다. 이 이관 절차는 저자의 운영 제안이지 공식 벤치마크가 측정한 이관 성능은 아니다.
텍스트 검색의 입력 형식도 따로 맞춰야 한다. 공식 카드에서 일반 검색 질의는 task: search result | query: {query}, 코드 검색은 task: code retrieval | query: {query} 형식이다. 문서 쪽은 title: {title} | text: {content}다. 질의와 문서가 역할이 다른 비대칭 작업이므로 무조건 같은 접두어를 붙이지 않는다. 반대로 분류·유사도처럼 대칭 작업은 해당 작업의 같은 접두어를 적용한다.
특히 prompt_name="Document"는 제목 없는 title: none을 붙인다는 안내가 있다. 실제 제목을 사용할 문서는 제목과 본문을 직접 형식화해야 한다. 자동 문서 프롬프트와 수동 제목을 중복 적용하지 않았는지도 점검하자. 접두어는 텍스트용이며 이미지·영상·오디오 자체에는 붙이지 않는다. 검색 점수가 이상할 때 차원만 바꾸기 전에 입력 형식부터 살펴볼 이유다.
4. 추론 정밀도는 조용한 실패를 막는 문제다
공식 권장 추론 자료형은 bfloat16 또는 float32다. float16은 사용하지 말라고 명시한다. 활성값의 범위가 float16의 동적 범위를 넘어서 NaN이 나오거나, 오류를 던지지 않은 채 임베딩 품질이 나빠질 수 있다는 설명이다. ‘에러 없이 벡터를 받았다’는 사실만으로 정상 출력을 확인했다고 보기 어려운 이유다.
네이티브 bfloat16 지원 하드웨어에서는 bfloat16을 권장하고, 그렇지 않은 환경은 float32를 사용하라는 것이 카드의 기준이다. 추론 자료형을 고르는 문제와 벡터 데이터베이스의 저장 자료형을 고르는 문제는 구분해야 한다. 이 글의 차원 절감 비교도 같은 저장 자료형을 유지한다는 조건에서만 성립한다. 출력에 유한값이 있는지, 차원과 벡터 길이가 기대와 같은지를 검사하는 것은 좋은 시작이지만 검색 의미 품질까지 입증하지는 않는다.
5. 입력 예산은 모달리티마다 따로 생기지 않는다
모든 입력은 하나의 8,192토큰 예산을 공유한다. 카드의 기본 비용은 이미지당 280토큰, 영상 프레임당 140토큰, 오디오 1초당 25토큰이다. 텍스트는 부분단어 토큰 기준이므로 한국어 글자 수를 곧바로 토큰 수로 취급하면 안 된다.
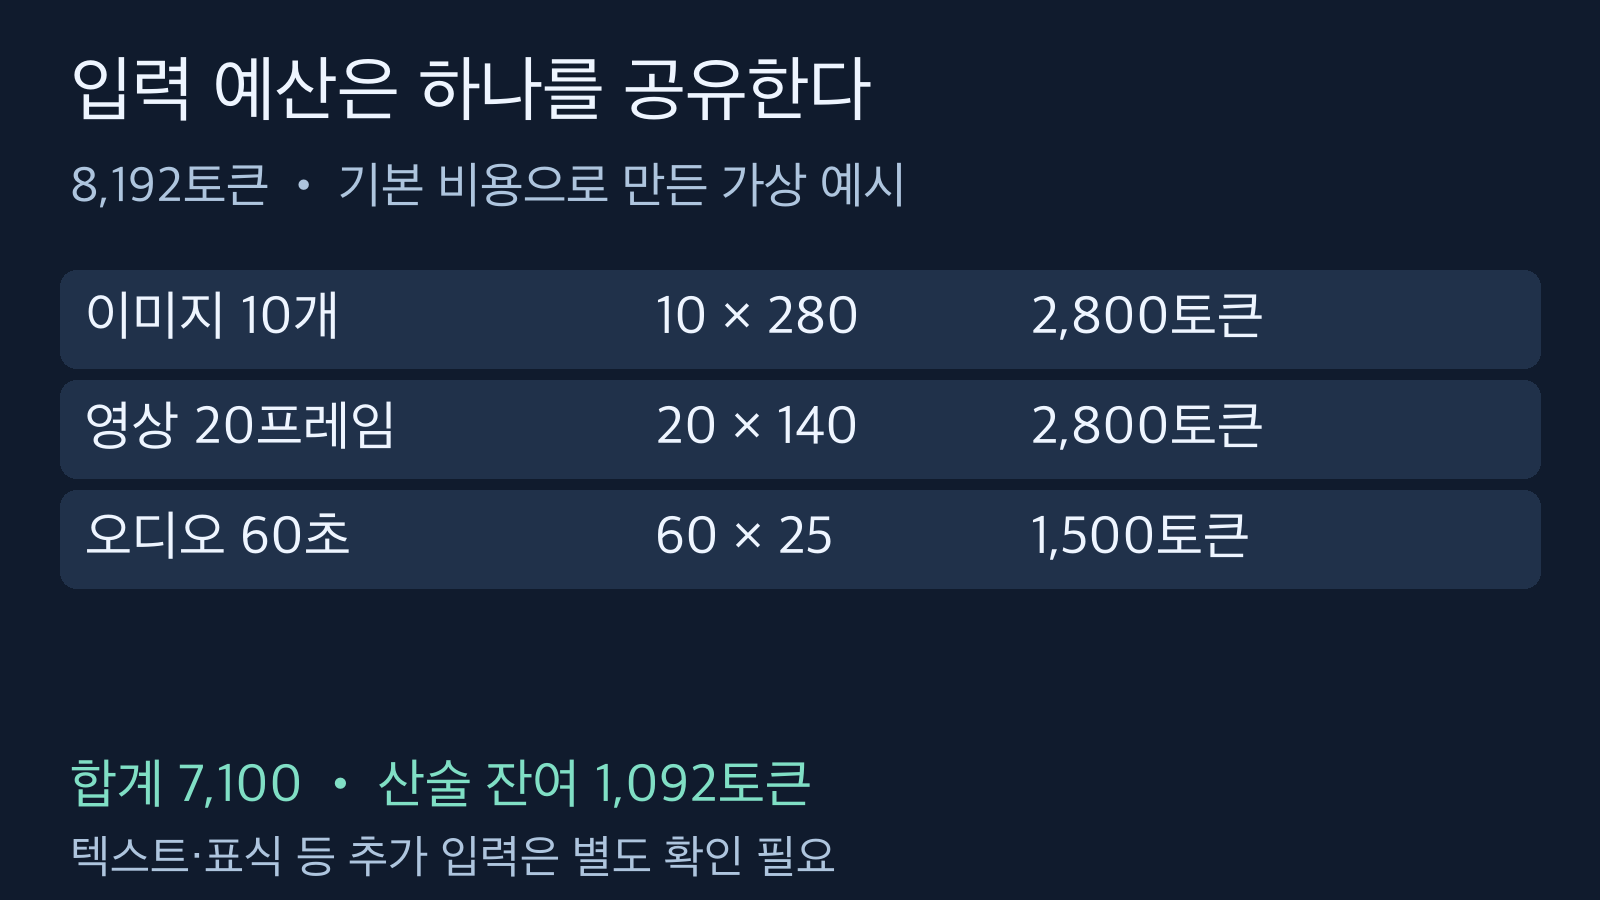
공식 기본 비용을 적용한 가상 입력이다. 산술 잔여는 실제 토크나이저 검증이나 안전한 최대 입력량이 아니다. 출처: huggingface.co/google/embeddinggemma-2/raw/914f7f89142e33e77833254d9c9b90c3cef7303b/README.md.
공식 표의 약 29개 이미지, 약 58개 영상 프레임, 약 327초 오디오는 각각 다른 자료와 텍스트가 없는 단일 모달리티 상한의 근사값이다. 세 용량을 한 입력에 동시에 담을 수 있다는 뜻이 아니다. 기본 영상 샘플링은 초당 한 프레임이며 변경 가능하므로, 프레임 수를 영상 길이와 언제나 같다고 말해서도 안 된다. 오디오 입력은 모노 16kHz 안내를 따른다. 비전 토큰 예산 설정을 바꾸면 위 기본 비용도 달라진다.
예산을 설명하기 위한 가상 입력으로 이미지 10개, 영상 20프레임, 오디오 60초를 잡으면 기본 비용은 각각 2,800, 2,800, 1,500토큰이다. 합계 7,100토큰을 제외한 산술 잔여는 1,092토큰이다. 이는 모델 실행이나 실제 토크나이저 측정이 아니라 카드의 기본 비용에 대한 계산이다. 텍스트와 관련 입력 표식 등 나머지 입력이 잔여 안에 드는지는 실제 인코딩에서 별도로 확인해야 하며, 끝까지 채워도 안전하다는 보장은 아니다. 긴 자료는 의미를 유지하는 구간으로 나누고 각 구간의 색인 단위를 명시하는 접근을 검토할 수 있다.
6. 증상에서 설정으로: 배포 결정표
아래 표는 공식 설정을 실제 문제에 연결한 저자의 분석이다. 성능 개선을 이미 검증한 처방이나 기기별 최적값 목록이 아니다. 모델을 올리는 순간 메모리가 부족하다면 출력 차원보다 불필요한 인코더를 먼저 확인한다.
| 관찰한 문제 | 먼저 점검할 설정 | 바꾸지 말아야 할 해석 | 비교할 근거 |
|---|---|---|---|
| 텍스트만 쓰는데 모델 로딩부터 부담 | 미사용 비전·오디오 인코더 생략 | 270M을 전체 멀티모달 크기로 설명하지 않기 | 필요한 기능을 유지한 상태의 실제 로딩 메모리 |
| 색인 저장량이 부담 | 같은 자료형에서 768→256 후보 비교 | 원소 절감을 DB 전체·모델 RAM 절감으로 확대하지 않기 | 고정 질의의 순위와 실제 색인 크기 |
| 차원 전환 뒤 점수가 이상 | 양쪽 차원과 절단 후 L2 정규화 | 그럴듯한 점수를 정상 품질의 증거로 삼지 않기 | 벡터 형태·길이 검사와 검색 결과 |
| 오류 없이 NaN 또는 품질 저하 | float16 사용 여부, bf16 지원 여부 | 단순한 자료형 이름 변경을 전 기기 지원으로 간주하지 않기 | 유한값 검사와 동일 입력의 결과 비교 |
| 미디어를 섞으면 입력 한도 초과 | 공유 예산과 기본 토큰 비용 | 단일 모달리티 최대량을 동시에 더하지 않기 | 실제 입력 토큰 수와 구간 분할 |
| 코드 질의의 관련성이 낮음 | CodeRetrieval 역할과 문서 제목 형식 | 공식 MTEB 점수를 내 저장소의 정확도로 바꾸지 않기 | 실제 코드 검색 질의와 정답 파일 목록 |
공식 MTEB code v1의 Mean(Task), NDCG@10은 이전 모델 68.76에서 새 모델 78.68로 보고되어 표시값 기준 9.92점 차이다. 모든 코드 검색에서 그만큼 좋아졌다는 뜻도, 우리 저장소에서 측정한 적중률도 아니다. 검토한 카드에는 이 집계의 과제·샘플 수가 제시되지 않아 분모를 만들어 넣지 않았다.
운영 기록에는 모델 리비전, 활성 인코더, 추론 자료형, 출력 차원, 정규화 여부, 텍스트 프롬프트 역할, 입력 예산 정책을 각각 남기는 편이 좋다. 이렇게 하면 품질 저하가 보일 때 ‘경량화했다’는 한 문장 대신 어떤 축을 바꿨는지 되짚을 수 있다. 로컬에서 처리한다는 설계 역시 애플리케이션의 로그·네트워크·권한까지 자동으로 안전하게 만든다는 보장은 아니다.
근거와 읽는 범위
- Google 공식 출시문: 모델의 목적과 모듈 구성 설명.
- 고정 리비전 모델 카드: 구성별 규모, 차원별 평가표, 정밀도, 접두어, 공유 입력 한도.
그림은 위 카드의 사실과 계산을 설명하기 위해 직접 제작한 도식이며 제품 화면이나 독립 성능 측정 결과가 아니다. 모델 카드의 Apache 2.0 선언과 공개 가중치 목록을 확인한 수집 근거는 보존했지만, 여기서 가중치를 다운로드하거나 실행하지는 않았다. 내부 관련 글 링크는 이번 글의 네 설정 축을 직접 설명하는 검증된 URL을 별도로 확보하지 않아 넣지 않았다. 수집 단계에서 검토한 FastE·임베딩 버전 이관·검색 엔진 라우팅의 인접 주제와도 구별한다. 이번 글의 중심은 하나의 고정 모델을 배포할 때 조정하는 표현 생성·저장·수치·입력의 경계다.


댓글
댓글 쓰기