ITBench-AA의 47%를 읽는 법: 장애 원인 누락과 과잉 진단을 나눠 보자
장애 알림이 프런트엔드에서 울렸다고 해서 프런트엔드가 원인인 것은 아닙니다. 반대로 원인을 하나 찾았다고 해서 조사를 끝내도 되는 것도 아닙니다. 여러 독립 원인이 겹쳤다면 하나만 맞힌 보고서는 여전히 불완전합니다. Kubernetes 장애 대응 에이전트를 평가할 때는 이 두 실수를 함께 다뤄야 합니다.
Artificial Analysis와 IBM이 2026년 5월 27일 공개한 ITBench-AA 소개는 바로 이 지점에서 읽을 가치가 있습니다. 발표 당시 Claude Opus 4.7의 점수는 47%, GPT-5.5는 46%, Qwen3.7 Max는 42%였습니다. 하지만 47%를 “장애의 47%를 복구했다”로 읽으면 평가 대상부터 달라집니다. 이 글은 발표 시점의 방법과 공개 데이터 증거를 해설합니다. 현재 순위 조회나 모델 실행의 독립 재현은 하지 않았습니다.
1. 평가 대상은 복구 작업이 아니라 원인 엔터티 목록이다
ITBench-AA SRE는 장애 스냅샷을 읽고 최소한의 독립 원인 Kubernetes 엔터티를 식별하는 과제입니다. 입력에는 알림, 이벤트, 트레이스, 메트릭, 로그, 애플리케이션 토폴로지가 포함됩니다. 에이전트는 고정된 Stirrup 하네스에서 샌드박스 파일 시스템을 셸로 조사하고, 원인이라고 판단한 Pod·Service·Deployment 등의 목록을 제출합니다.
발표에는 실시간 시스템 진단을 연상시키는 표현도 있지만, 방법론과 공개 데이터 README가 설명하는 실제 평가 입력은 오프라인 스냅샷입니다. 따라서 점수는 실서비스 변경 권한, 자동 복구 성공, 재발 방지, 운영 안전성을 입증하지 않습니다. 조사에 사용한 명령 수와 원인을 정확하게 제출하는 능력도 별도입니다.
전체 시나리오는 59개로 공개 40개와 비공개 평가용 19개로 나뉩니다. 과제당 세 번 반복하고 최대 100턴을 허용합니다. 발표의 평균 점수는 59개 시나리오에 대한 반복별 값을 합쳐 집계한 것으로, 반복 실행을 서로 다른 장애 사례로 세어서는 안 됩니다. 공개 파일에서 읽을 수 있는 40개만으로 비공개 결과까지 독립 검증했다고 말할 수도 없습니다.
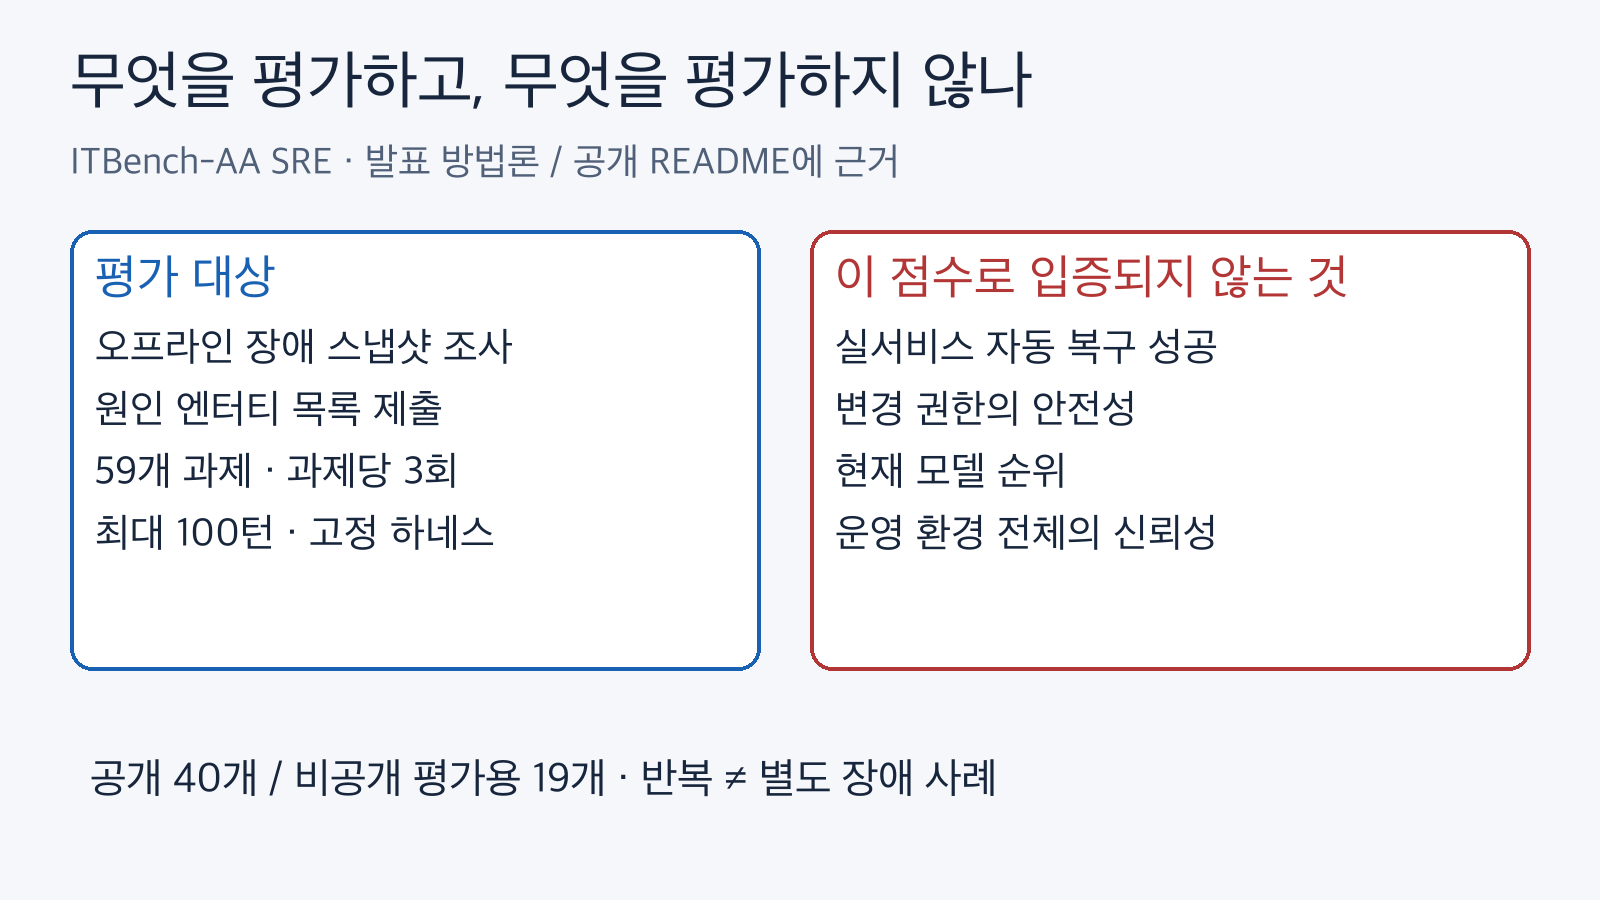
평가 입력은 오프라인 장애 스냅샷이다. 진단 점수는 실제 복구와 변경 안전성의 증거가 아니다. 출처: huggingface.co/blog/ibm-research/itbench-aa.
2. 원인을 모두 찾은 뒤에야 정밀도가 점수가 된다
원문의 채점은 average precision at full recall입니다. 여기서 표현만 보고 흔히 쓰는 순위 기반 평균 정밀도 지표라고 생각하지 않는 편이 좋습니다. 글에 적힌 규칙은 더 직접적입니다. 정답 원인을 하나라도 빠뜨리면 그 반복의 점수는 0입니다. 모든 정답을 포함했다면 제출 목록 중 실제 원인이 차지하는 비중, TP / (TP + FP)가 점수가 됩니다.
가상의 정답이 A와 B 두 엔터티라고 해 봅시다. A만 제출하면 맞힌 것이 있어도 원인 누락 때문에 0입니다. A와 B만 제출하면 온전한 점수를 얻습니다. A·B에 무관한 C까지 넣으면 누락은 없지만 정밀도가 떨어집니다. A·B·C·D를 함께 넣으면 원인을 모두 찾고도 점수는 더 낮아집니다. 아래 그림은 발표 결과가 아닌 규칙 설명용 합성 예시입니다.
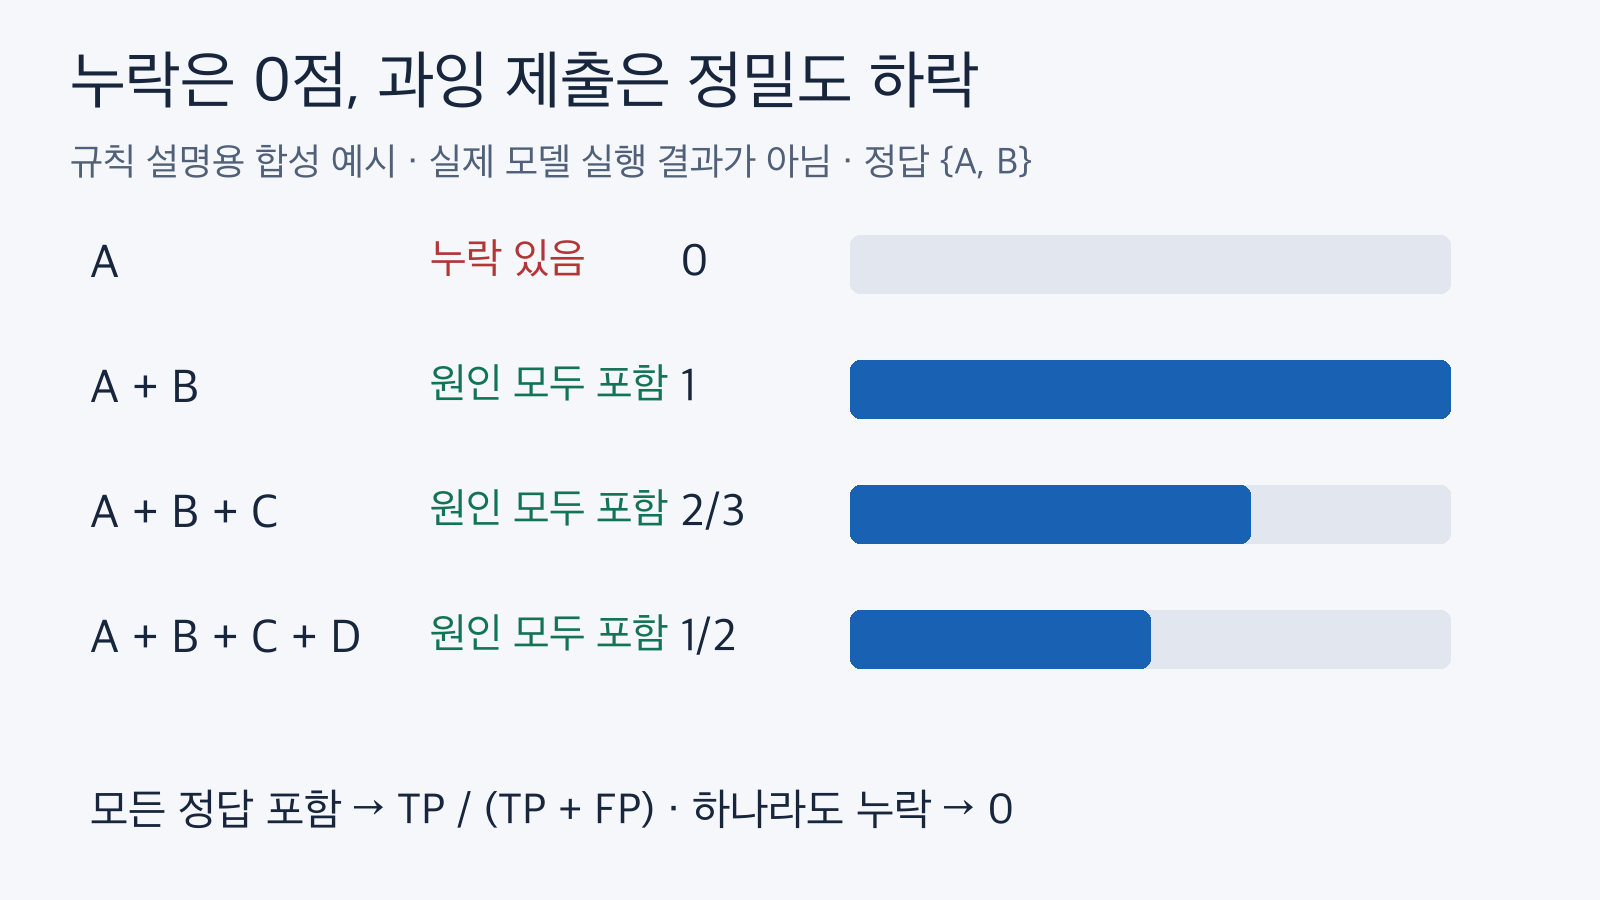
합성 예시: 정답 두 개를 모두 포함해야 정밀도가 점수가 된다. 막대는 실제 모델 결과가 아니다. 출처: huggingface.co/blog/ibm-research/itbench-aa.
이 때문에 발표의 47%는 이진 성공률과 다릅니다. 모든 원인을 찾았지만 불필요한 엔터티를 함께 낸 실행에도 부분 점수가 생길 수 있습니다. 반대로 맞은 후보가 일부 있어도 누락이 있으면 0점입니다. 반올림된 평균에서 “정확히 몇 건을 해결했다”를 역산하면 안 됩니다. 어떤 오답이었는지 알려면 반복별 제출 집합과 정답 집합이 필요합니다.
3. 알림이 발생한 곳과 원인이 시작된 곳을 구분한다
공개 데이터의 첫 시나리오에는 load-generator-pod-1이 원인으로 표시돼 있습니다. 반면 오류율과 지연 알림은 frontend-proxy-service-1에 연결됩니다. YAML 전파 관계는 load-generator Pod에서 요청이 증가하고, 관련 Service를 거쳐 frontend-proxy Service에 과부하가 나타나는 흐름을 설명합니다.
이 사례에서 프런트엔드의 오류율을 관찰하는 일은 유효한 조사입니다. 하지만 관찰 대상이라는 이유만으로 프런트엔드를 독립 원인으로 제출하면 다른 판단이 됩니다. 또한 경로 가운데 Service가 있다고 해서 그 Service가 정답 엔터티라는 뜻도 아닙니다. 공개 YAML의 그룹, 엔터티 종류, 별칭을 함께 읽어야 식별 단위가 어긋나지 않습니다.
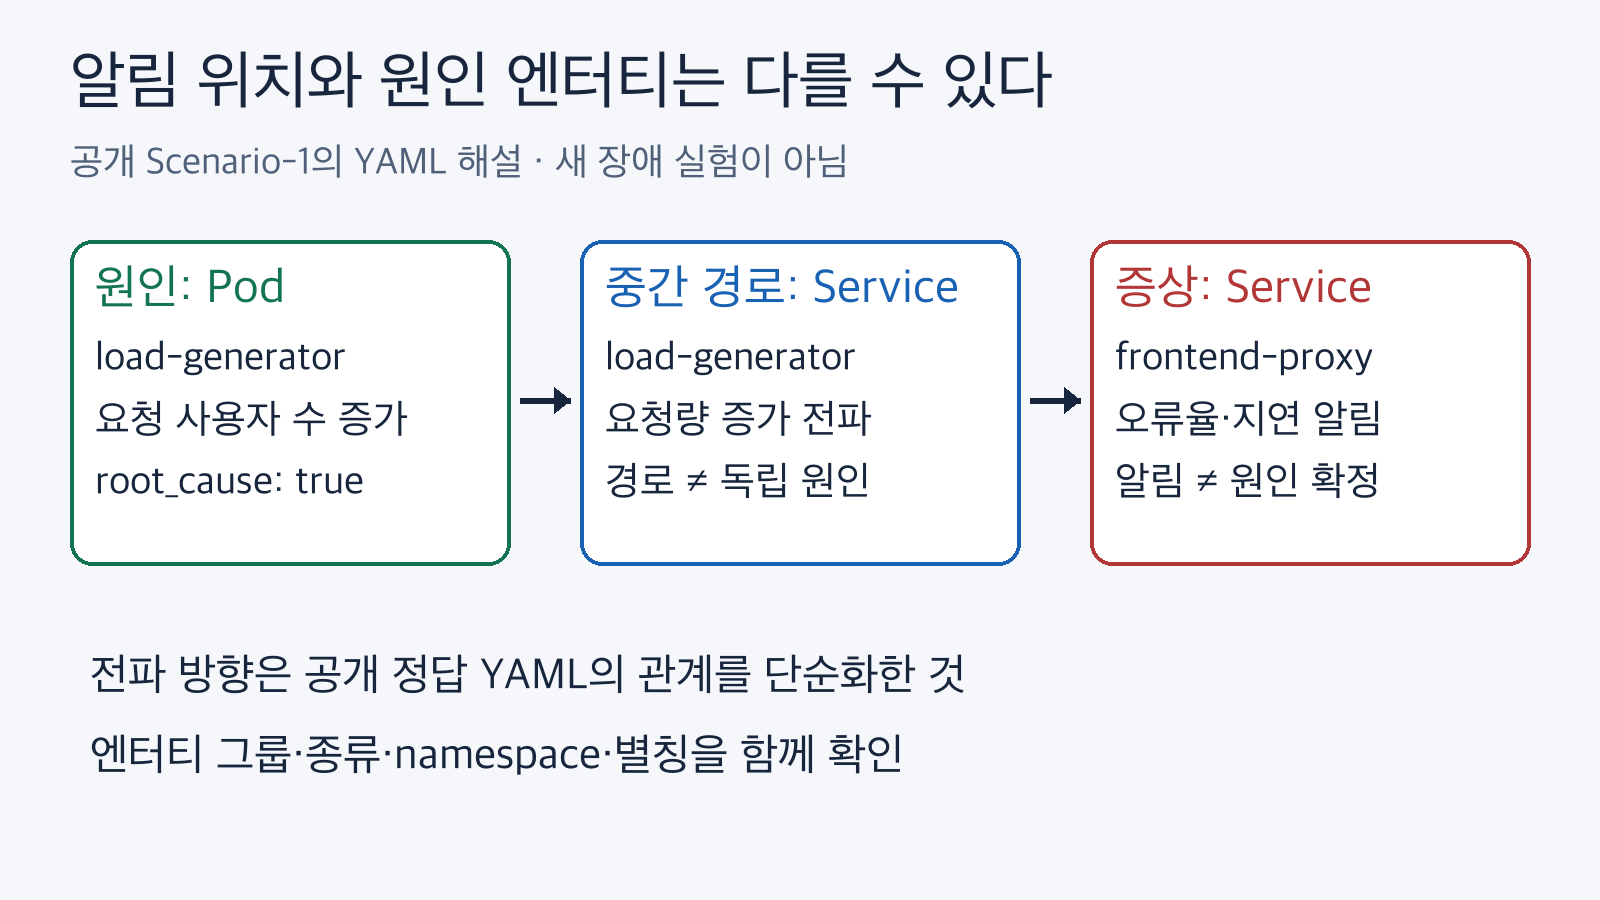
공개 Scenario-1 YAML의 전파 관계를 단순화했다. 알림 엔터티와 원인 엔터티는 다를 수 있다. 출처: huggingface.co/datasets/ArtificialAnalysis/ITBench-AA/resolve/76df38a82288f75ba9e41dc8c515033332497473/sre/data.jsonl.
그림의 화살표는 공개 첫 시나리오 YAML에 기록된 전파 관계를 단순화한 것입니다. 실제 클러스터의 패킷이나 로그를 새로 측정한 것이 아닙니다. 공개 정답을 읽어 만든 해설이므로, 에이전트가 정답을 보지 않고 이 원인을 찾아냈다는 실험 증거로 사용해서도 안 됩니다. 정답 열은 평가용이고 운영 에이전트의 입력과 섞이면 평가 누출이 됩니다.
4. 오래 조사한 모델이 낮은 점수를 받은 관찰은 인과 실험이 아니다
발표에서 GPT-5.5 xhigh는 평균 31턴과 46%, Gemini 3.1 Pro Preview는 평균 83턴과 30%로 보고됐습니다. 원문은 긴 조사에서 장애 주입을 일으킨 상위 메커니즘이나 동시에 나타난 증상을 원인 목록에 더 넣는 양상이 오탐으로 이어진다고 설명합니다.
여기서 가져올 수 있는 교훈은 “관련된 것을 많이 찾을수록 최종 답이 좋아지는 것은 아니다”입니다. 가져올 수 없는 결론은 “턴 수를 줄이면 정확도가 오른다”입니다. 모델도 다르고 추론 설정도 다릅니다. 같은 모델에 같은 과제를 주고 조사 예산만 바꾼 통제 실험이 아니므로, 31턴을 최적 예산으로 정하거나 83턴을 실패 기준으로 정할 근거가 없습니다.
오히려 조사 로그는 풍부하게 유지하되 제출 집합은 별도로 검토하는 설계가 이 채점 규칙과 더 직접적으로 연결됩니다. 조사 중 발견한 가설을 지우라는 뜻이 아닙니다. 발견한 것, 아직 의심하는 것, 원인으로 확정해 제출하는 것을 같은 목록에 섞지 말자는 것입니다.
5. 팀에서 써 볼 제출 판단표
조사 후보와 최종 원인 목록을 분리하고, 각 원인에 근거와 배제한 대안을 연결한다. 다음 표는 벤치마크의 공식 제출 스키마가 아니라, 운영팀이 에이전트 보고서를 검토할 때 적용할 수 있는 편집자의 판단 도구입니다.
| 발견한 내용 | 먼저 확인할 근거 | 최종 제출에서의 취급 |
|---|---|---|
| 오류·지연 알림이 있는 엔터티 | 알림 시각, 요청 경로, 상류 변화와의 연결 | 증상 후보로 보존하고 독립 원인 여부를 추가 확인 |
| 장애를 설명하는 구성 변경 | 변경 대상의 정확한 namespace·kind·이름, 장애 시점과 전파 관계 | 근거가 연결된 원인 후보로 검토 |
| 장애 주입 도구나 상위 제어기 | 평가가 원인으로 정의하는 단위, 직접 장애 엔터티와의 관계 | 관련 메커니즘과 제출 원인 엔터티를 혼동하지 않음 |
| 동시에 발견한 별도 경고 | 같은 장애를 설명하는지, 별도 원인이 필요한지 | 연관성만으로 최종 집합에 추가하지 않음 |
| 아직 설명되지 않은 증상 경로 | 현재 원인 집합이 그 경로도 설명하는지 | 누락 가능성을 남기고 추가 조사 또는 사람 검토로 넘김 |
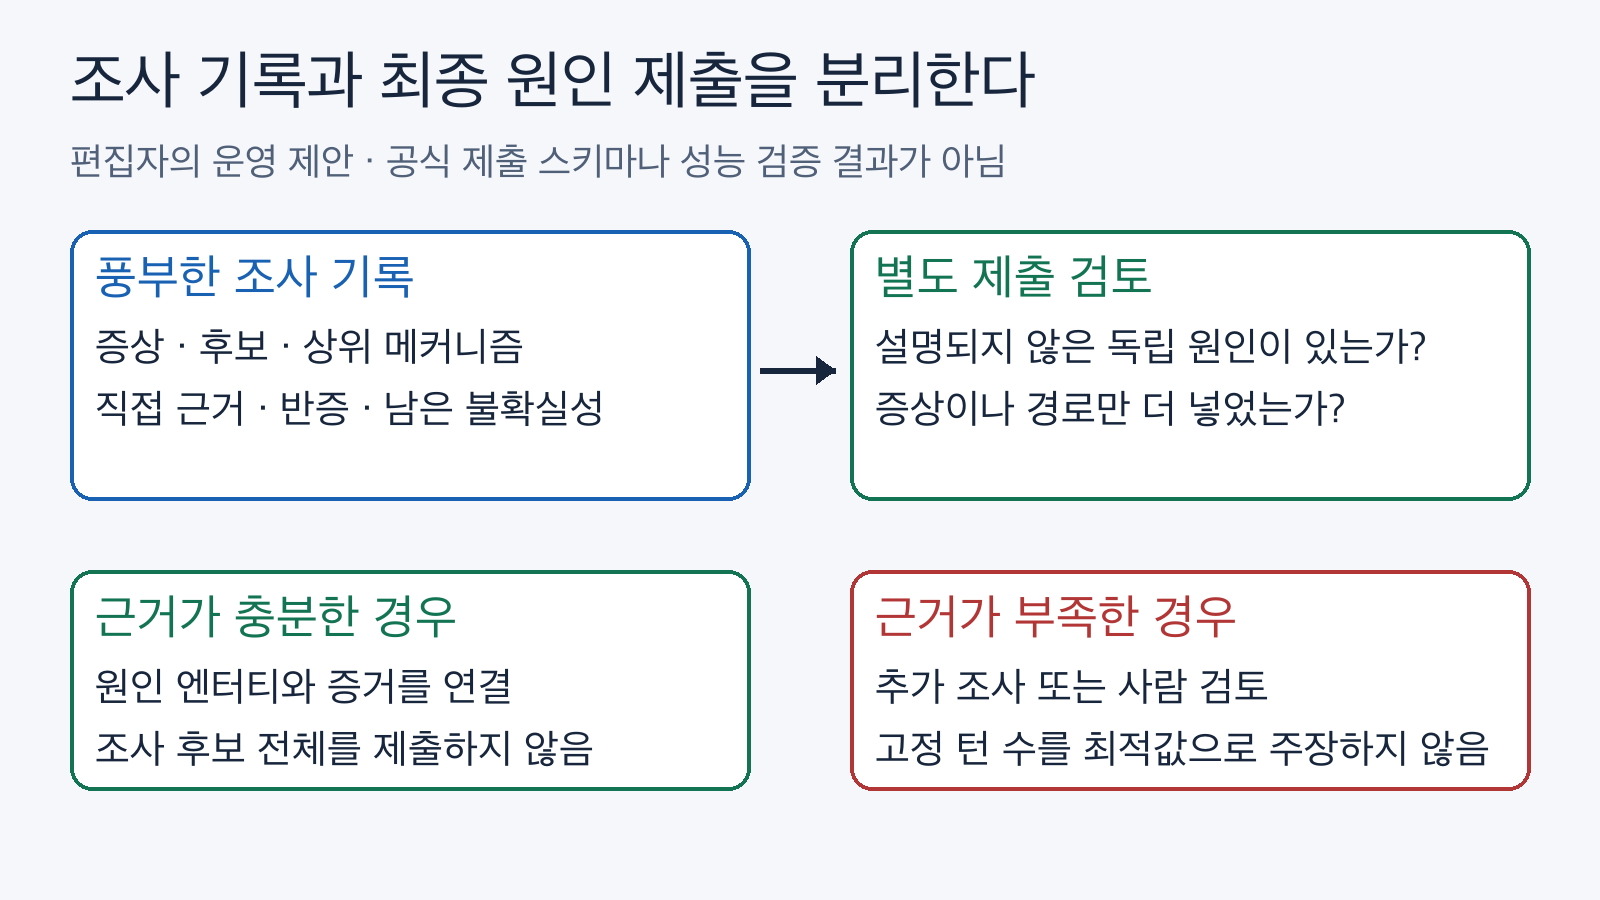
편집자의 운영 제안: 풍부한 조사 기록을 유지하되 제출 목록의 누락과 과잉을 별도로 검토한다. 출처: huggingface.co/blog/ibm-research/itbench-aa.
실제 적용 순서는 다음과 같습니다. 먼저 장애 창과 영향을 받은 경로를 좁힙니다. 다음으로 후보별 직접 근거와 전파 관계를 기록합니다. 마지막 제출 전에는 두 질문을 따로 묻습니다. “설명하지 못한 독립 원인이 남아 있는가?”와 “제출하려는 엔터티 가운데 증상·중간 경로·메커니즘만 있는가?”입니다. 첫 질문은 누락을, 두 번째 질문은 과잉 제출을 줄이려는 검사입니다.
중단 조건은 특정 턴 수가 아니라 근거 상태로 두는 편이 낫습니다. 주요 경로가 여전히 설명되지 않거나 엔터티 식별이 모호하면, 원인을 더 크게 추측해 제출하기보다 남은 불확실성을 명시하고 사람에게 넘길 수 있습니다. 이것은 운영 제안이며 ITBench-AA 점수를 높였다는 검증 결과가 아닙니다. 벤치마크가 요구하는 제출 형식과 운영 보고서의 보류·신뢰도 표현도 분리해서 구현해야 합니다.
6. 무엇을 믿고 무엇을 보류할 것인가
이 글은 기존 수집물의 해시를 대조한 뒤 원문 방법론과 공개 README, 커밋이 고정된 JSONL을 다시 검토했습니다. 공개 파일의 행 수와 첫 시나리오의 원인·알림·전파 필드를 로컬에서 확인했습니다. 모델을 실행하거나 19개 비공개 시나리오 및 전체 모델 궤적을 재평가하지는 않았습니다. 따라서 출시 당시 수치의 인용과 공개 정답 구조의 검토를 독립 성능 재현과 혼동하면 안 됩니다.
이 글의 제출 판단표는 편집자의 운영 제안이며, 모델 성능 개선이나 실제 장애 복구를 검증한 결과가 아니다. 운영 도입 전에는 진단 권한과 변경 권한을 분리하고, 자체 장애 사례에서 누락과 과잉 제출을 따로 검토해야 합니다. 이 글의 초점은 어느 모델이 지금 가장 좋은가가 아니라, 에이전트가 내놓은 원인 목록의 의미를 팀이 일관되게 판단할 수 있는가입니다.
관련 내부 글은 이 패키지에서 추가하지 않았습니다. 기존 중복 검토에 등장한 글들은 다른 평가 단위나 제품 상태 문제를 다루며, 현재 원인 엔터티 채점의 직접 참고자료로 확인된 공개 링크가 없어 억지로 연결하지 않았습니다.
출처와 검토 범위
- IBM·Artificial Analysis 발표: ITBench-AA — 2026년 5월 27일 발표의 Key findings, SRE overview, Methodology details, Highlights. 수치는 당시 발표값입니다.
- 공개 데이터 README — 공개 40개·비공개 제외 범위 및 필드 정의. 링크는 가변 경로이며 이 글은 기존 해시 고정 수집 증거를 사용했습니다.
- 커밋 고정 공개 시나리오 JSONL — 첫 시나리오의 YAML 구조 검토. 공개 정답 해설이며 실제 장애 재현이 아닙니다.


댓글
댓글 쓰기