대화를 지우지 않고 KV만 줄이려면: AKV가 캐시 작업 이력을 기록하는 이유
도구를 오래 사용하는 에이전트는 검색 결과와 실행 로그를 계속 쌓는다. 비용을 줄이려고 앞부분을 요약하면 원래 기록이 달라지고, 뒤에 남겨 둔 문맥의 KV 상태를 다시 계산해야 할 수 있다. 반대로 기록을 그대로 두면 다음 토큰이 참조하는 캐시도 커진다. 자체 호스팅 팀이라면 이 둘을 꼭 함께 줄여야 하는지부터 물어볼 만하다.
AKV의 답은 텍스트 이력과 어텐션에 참여하는 KV를 분리하는 것이다. 다만 이것은 대화 기록을 보존하면서 원래와 똑같이 추론한다는 약속이 아니다. BCP 앞 100개 과제에서 도구 응답 KV 제거에 위치 재배치를 더한 저자 실험은 통과율이 55.0%에서 62.0%로 높아졌지만, 과제당 API 환산 비용도 7.1센트에서 10.9센트로 늘었다. 정확도와 비용을 함께 봐야 하는 이유다. 논문 Table 3
이 글은 2026년 10월 20일 UTC, 한국 시각 10월 21일에 제출된 「Cache Engineering for Agents」 arXiv v1과 저자 구현의 고정 커밋을 읽고 정리했다. 심사 통과 논문이라고 소개하지 않으며, AI를 활용해 작성·편집한 공개 자료 기반 해설이다. 제품 사용 후기나 독립 성능 재현은 아니다.
1. 기록 보존과 현재 참조 가능성은 다르다
논문에서 logical trajectory는 프롬프트·모델 응답·도구 결과가 이어진 전체 텍스트 이력이다. active cache는 이후 어텐션이 실제로 참조할 수 있는 KV 상태다. AKV는 앞의 텍스트를 수정하지 않은 채 뒤의 참여 범위를 바꾼다. 여기서 active는 알고리즘상 참여 여부이지, GPU 메모리에 물리적으로 남아 있는지와 같은 말이 아니다. 다른 요청이 공유하는 캐시는 한 요청이 제외했다고 곧바로 물리 삭제할 수 없다. §§3.1, 4.2.2
세 연산을 구분하면 오해가 줄어든다. append는 현재 활성 캐시를 참고해 새 토큰의 KV를 만든다. drop은 선택한 KV를 이후 어텐션에서 제외하되, 남은 상태와 그 위치 인덱스는 그대로 둔다. repos는 남은 key의 위치 인코딩을 재배치하고 다음 토큰의 위치도 조정한다. 이때 value는 바꾸지 않는다. 따라서 drop만 한다고 위치 범위까지 자동으로 짧아지는 것은 아니다. §3.3
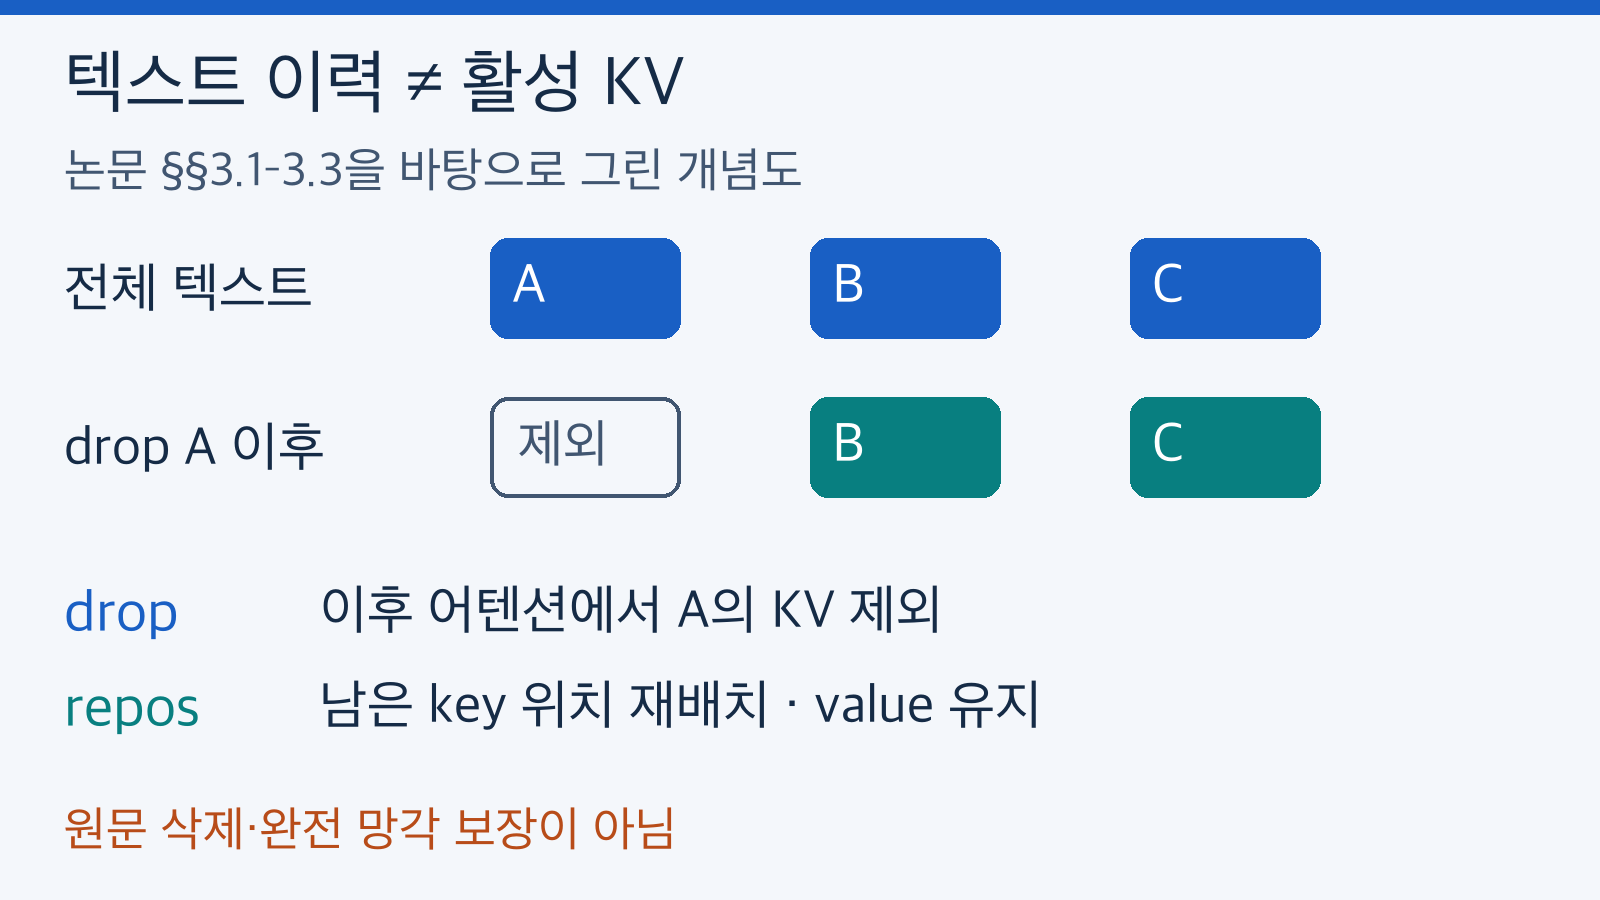
전체 이력과 이후 어텐션 참여는 다르다. drop은 선택 KV를 제외하고 repos는 남은 key 위치를 재배치한다. 원문 삭제·완전 망각 보장이 아니다. 출처: arxiv.org/html/2610.28577v1.
오래된 도구 응답을 제외해도 그 내용을 참고해 이미 계산한 추론 KV에는 영향이 남을 수 있다. 전체 기록을 보존한다는 사실도, 제외한 원문을 다음 계산이 직접 읽을 수 있다는 뜻은 아니다. 이 설계는 민감정보 완전 삭제나 완전한 망각을 보장하는 기능으로 써서는 안 된다. 남긴 추론이 계속 늘면 활성 캐시도 계속 커질 수 있다. 메모리 사용량이 무한히 고정된다는 설명 역시 틀리다.
2. B와 C가 남았다고 같은 캐시는 아니다
여기서 서버 구현이 어려워진다. A와 B를 읽은 뒤 C를 계산하고 A를 제외하는 경로를 생각해 보자. C를 만들 때는 A와 B 모두 보였다. 같은 A와 B를 먼저 읽되 A를 제외한 다음 C를 계산하면, 최종적으로 B와 C가 남는 것은 같아도 C가 만들어진 조건은 다르다. 두 번째 경로의 B에는 앞서 A를 본 영향이 여전히 들어 있을 수 있다.
아예 B에서 시작해 C를 붙이는 세 번째 경로는 또 다르다. 첫 두 경로의 B는 A를 참고했지만 세 번째 B는 그렇지 않기 때문이다. 논문 Figure 5는 세 경로의 남은 토큰이 같아도 KV 상태가 달라진다는 반례다. 세 경로는 설명용 구성이지, 장애가 세 번 발생했다거나 오류율을 측정했다는 뜻이 아니다. Figure 5 및 §3.4
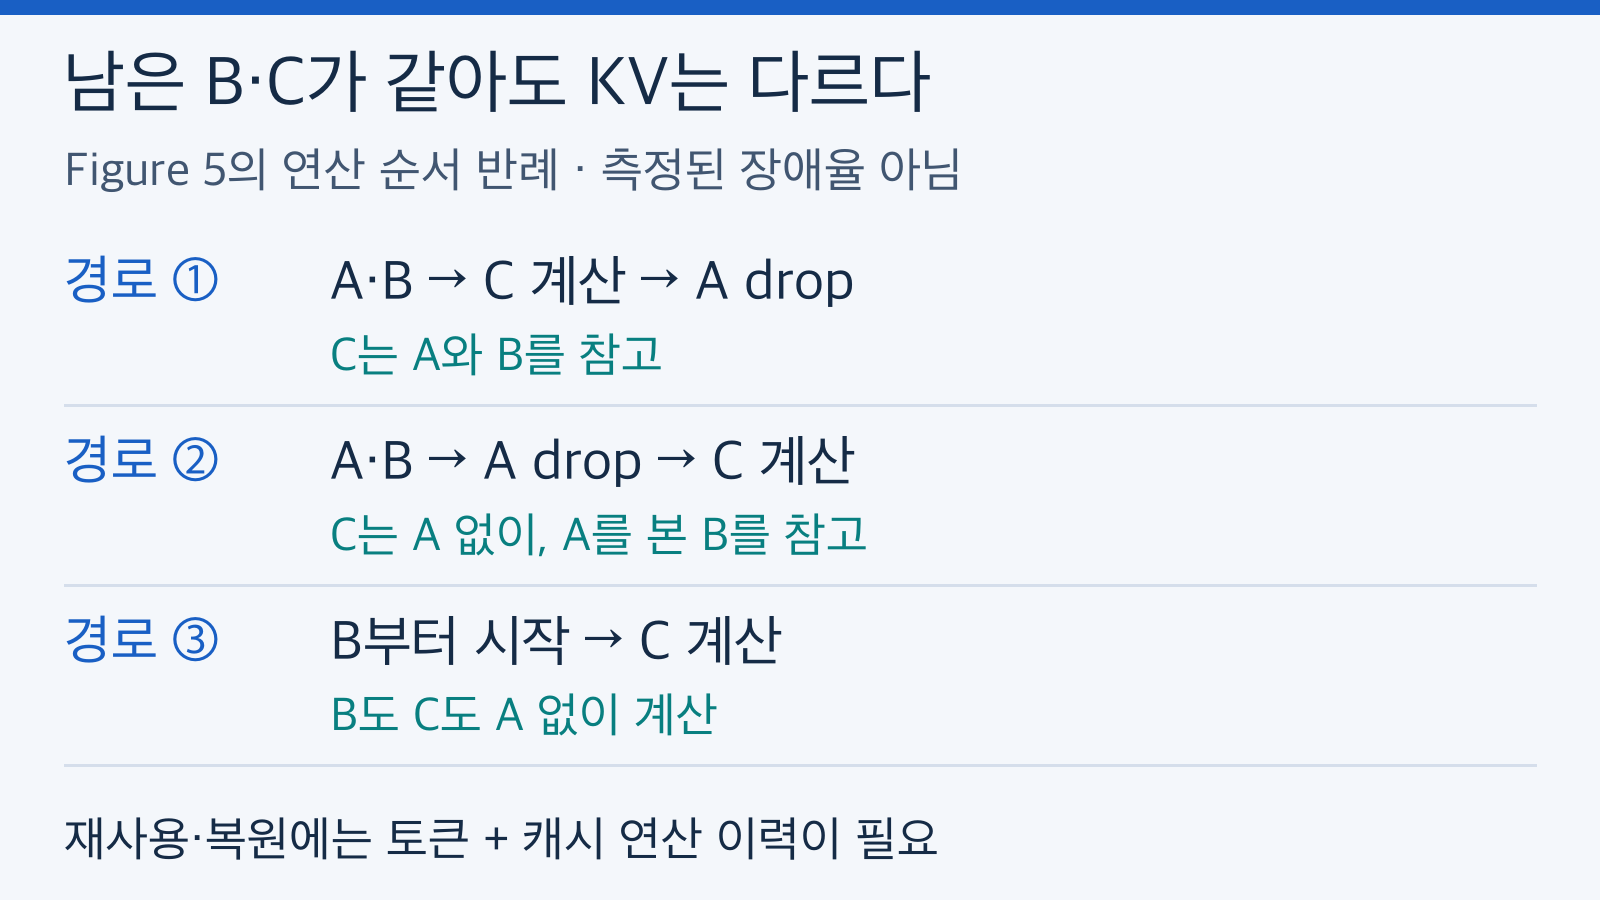
Figure 5의 세 연산 경로를 다시 그렸다. 같은 B·C가 남아도 계산 시 보인 KV가 달라 상태가 다르다. 측정된 장애율이 아니다. 출처: arxiv.org/html/2610.28577v1.
그래서 메시지 텍스트만으로 캐시를 공유하면 충분하지 않다. AKV는 토큰과 캐시 연산의 이력을 함께 구분하는 확장 radix tree, drop을 고려한 회수, 사라진 상태를 복원하는 segment-batch attention을 제안한다. 메모리 압력으로 상태가 사라졌다가 복원되어도 과거에 어떤 어텐션을 거쳤는지 재현해야 한다. 이는 모든 전체 문맥 계산과 동등해진다는 뜻이 아니며, 유한 정밀도에서 재계산과 비트 단위 일치까지 주장해서도 안 된다. §4.2, Appendix A.1.2
3. 통과율이 올라도 비용이 함께 오를 수 있다
아래는 저자 Table 3 중 같은 GPT-OSS-120B의 tool-drop 설정에서 repos 유무를 비교한 값이다. 각 벤치마크의 앞 100개 과제라는 범위를 유지했다. BCP는 웹 탐색형 평가인 BrowseComp-Plus이고, SWE는 소프트웨어 수정 과제인 SWE-bench Verified다.
| 범위·지표 | tool-drop, repos 없음 | tool-drop + repos | 해석 |
|---|---|---|---|
| BCP 통과율 | 55.0% | 62.0% | 7.0퍼센트포인트 상승 |
| BCP 과제당 API 환산 비용 | 7.1 미국 센트 | 10.9 미국 센트 | 더 정확하지만 더 저렴하지는 않음 |
| SWE 통과율 | 41.0% | 41.0% | 이 비교에서는 상승하지 않음 |
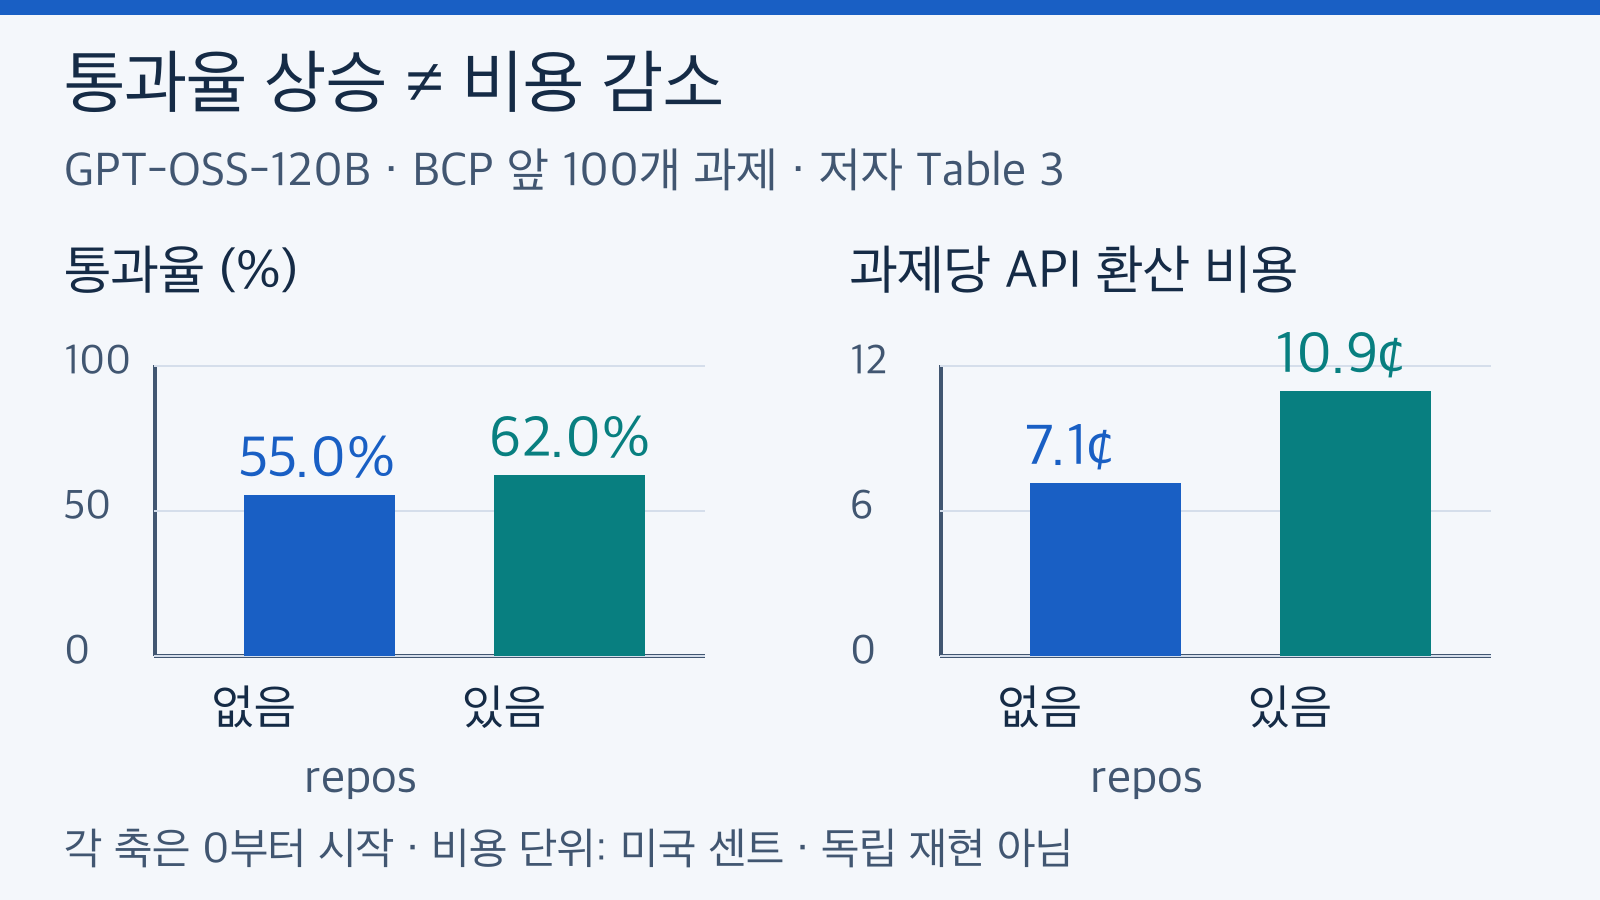
GPT-OSS-120B, BCP 앞 100개 과제의 Table 3 비교. repos를 더하면 통과율과 비용이 모두 오른다. 비용은 API 환산 추정이며 두 축은 각각 0부터 시작한다. 출처: arxiv.org/html/2610.28577v1.
7퍼센트포인트는 상대 개선율 7%와 다르다. 이 비교는 요약 기반 Standard에서 AKV 전체로 바꾼 종합 효과도 아니다. 표시된 비율만 보고 정확히 몇 번 성공했다고 역산하지 않았다. 확인한 Table 3에는 반복 횟수나 신뢰구간이 명시되지 않아 통계적 유의성도 덧붙이지 않았다.
API 환산 비용은 논문 Appendix A.3의 고정 토큰 가격으로 계산한 추정치다. 에이전트 생성과 문맥 요약 호출을 포함하고 repos는 캐시 적중 요금으로 환산한다. 실제 공급자 청구서, GPU 임대료, 검색·평가를 포함한 전체 운영비가 아니다. 전체 평균 절감률을 내 서비스의 예산표에 바로 옮기는 것보다, 실패·재시도와 유지할 도구 결과를 함께 평가하는 편이 타당하다. Table 3와 Appendix A.3
4. 요청 필드를 추가하기 전에 백엔드부터 확인한다
공개 구현은 AKV 호환 SGLang 서버를 전제로 한다. OpenAI 호환 API 형태라는 표현은 일반 호스팅 API가 임의의 KV 제어 필드를 지원한다는 뜻이 아니다. 저자 README의 고정 커밋에서는 최상위 drop_message와 reposition을 사용한다. 논문 Figure 6의 설명용 cache.drop 문법과 그대로 섞지 않는 것이 중요하다.
예컨대 고정 README의 요청 예시에는 다음 두 필드가 있다. 아래는 요청 전체도, 이 글에서 실행한 코드도 아닌 문법 해설이다.
{"drop_message": {"4": [2]}, "reposition": [4]}
메시지 인덱스는 0부터 시작한다. 메시지 4를 처리한 뒤 메시지 2의 KV를 제외하고, 이어 남은 위치를 재배치한다는 뜻이다. 요청의 messages에는 메시지 2를 포함한 전체 이력을 계속 보내야 한다. 메시지 자체를 지우거나 원래 인덱스를 다시 매기면 같은 연산 설명이 아니다. 같은 경계에서 둘 다 수행하면 drop이 먼저다. 고정 README: Apply an AKV CachePolicy
또한 확인한 문서는 Python 3.12, Rust/Cargo, 시작 시 커널 컴파일을 위한 C++20 컴파일러와 쓰기 가능한 캐시를 요구한다. Drop/Repos의 페이지 크기는 1만 지원하며, Context 요청에는 speculative decoding, LoRA, HiCache, 외부·세션 캐시, PP/CP/DCP, beam search 제외가 있다. 이 목록은 고정 커밋 시점 기준이지 미래 버전까지 영구히 불가능하다는 뜻은 아니다. 논문의 GPU 8장 실험 구성을 모든 설치의 최소 요구사항으로 오해하지 않아야 한다. 시스템 README
5. 우리 팀은 언제 도입을 검토할까
도입의 첫 질문은 얼마나 많이 지울지가 아니라, 같은 메시지에 서로 다른 캐시 작업 이력을 붙였을 때 서버가 상태를 구분하고 복원할 수 있는가다. 아래 결정표와 검증 순서는 논문·고정 커밋 문서에서 도출한 편집상 제안이며, AKV를 설치하거나 벤치마크를 독립 재현한 결과가 아니다.
| 현재 조건 | 먼저 확인할 증거 | 지금의 판단 |
|---|---|---|
| 일반 호스팅 API만 사용한다 | 공급자가 해당 연산과 복원 의미를 실제 지원하는가 | 임의 필드 추가만으로 도입했다고 판단하지 않는다 |
| 자체 서버와 하네스를 함께 제어한다 | 지원 모델·기능 조합, 전체 메시지와 누적 연산 이력 직렬화 | 별도 시험 환경에서 검토할 후보가 된다 |
| 서버가 텍스트 prefix만으로 상태를 공유한다 | 같은 메시지·다른 drop 시점의 상태 구분 | 캐시 작업 이력 지원부터 확인한다 |
| 캐시 퇴거 후 복원이 발생한다 | 차가운 상태·따뜻한 상태에서 연산 이력 재현, 요청 간 격리 | 복원 경로 관측 없이 정상 동작을 가정하지 않는다 |
| 민감정보 삭제 보장이 목적이다 | 원문·공유 캐시·파생 상태별 삭제 정책 | drop을 삭제 정책의 대체재로 쓰지 않는다 |
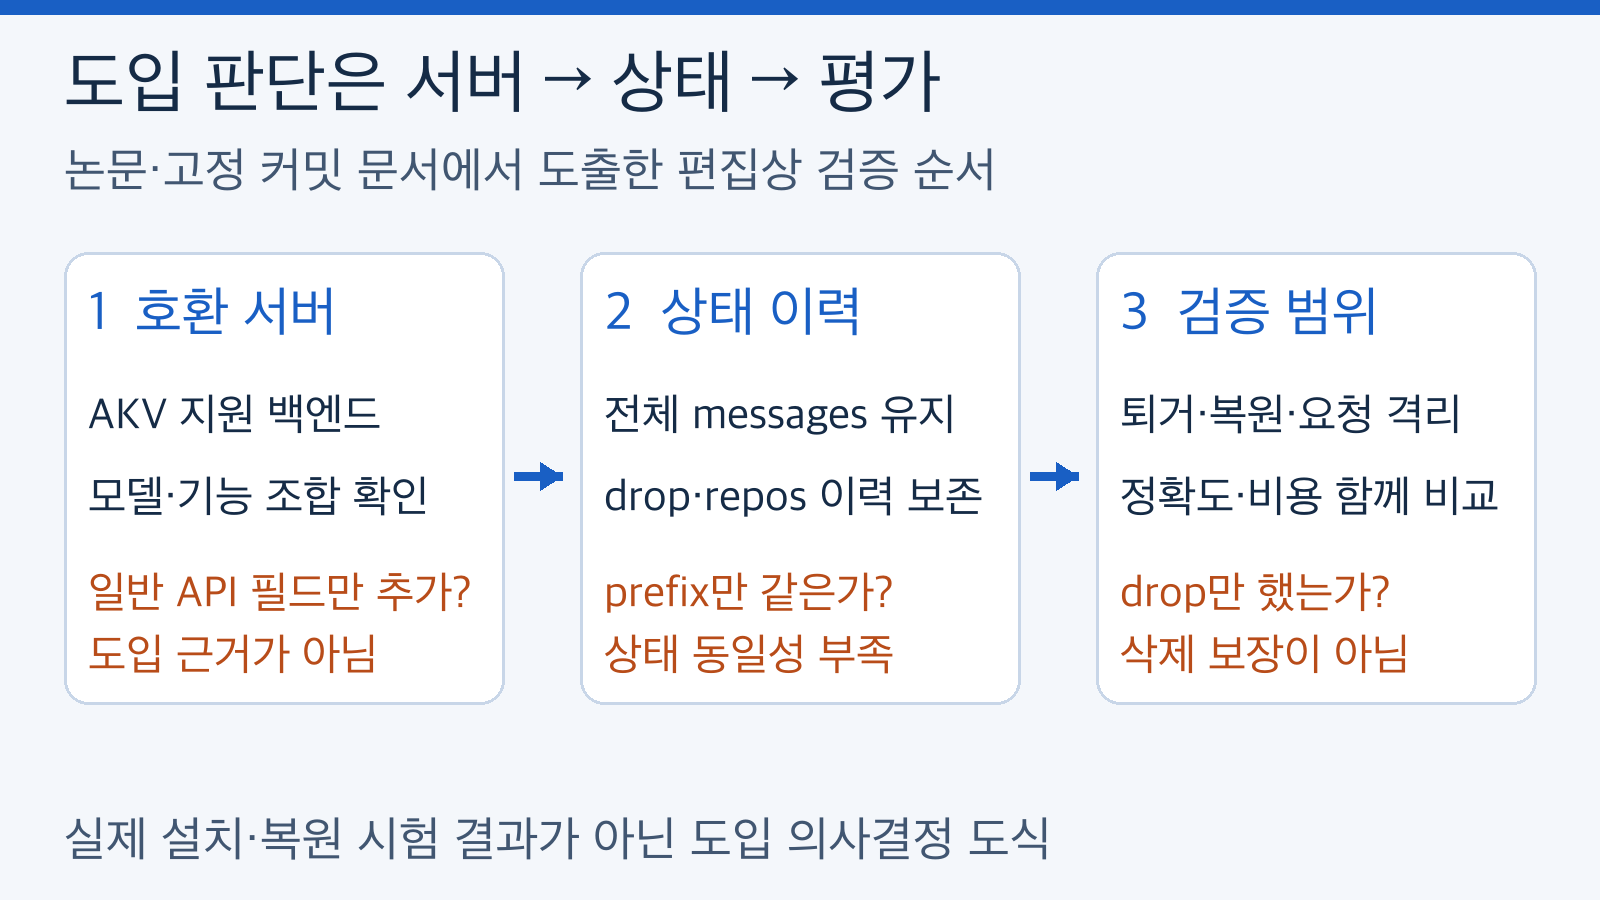
일반 API 필드 추가, 같은 prefix, drop 실행만으로는 각각 호환성·상태 동일성·정보 삭제를 입증하지 못한다. 편집상 검증 설계이며 시험 결과가 아니다. 출처: github.com/thu-nics/AKV/blob/c567a429a058f1abce3b2879e69978b09e0fda4c/akv/system/README.md.
시험을 설계한다면 전체 기록, 연산 이력, 요청 식별자와 실제 사용량을 함께 남기는 것이 출발점이다. 같은 메시지에서 drop 시점만 다른 경로를 만들어 상태가 잘못 합쳐지지 않는지 확인하고, 물리 캐시가 없는 복원 경로와 공유 prefix를 가진 다른 요청도 따로 확인할 수 있다. 이는 이 글이 제안하는 검증 설계이며, 아직 실행한 시험이나 운영 장애 사례가 아니다.
성능도 동일한 부하 조건을 별도로 잡아야 한다. 논문 Table 2의 대표 peak 비교는 Standard 동시성 12와 AKV 동시성 14로, 부하가 같지 않다. 문맥이 가장 긴 SWE 과제 80개를 고른 재생 실험이며 각 정책은 자기 궤적을 재생하고 도구를 실제 재실행하지 않았다. 높은 동시성의 측정 종료 방식에도 차이가 있다. 이를 보편적 지연시간 보장이나 운영 SLA로 옮길 근거는 없다. Table 2 및 Appendix A.1.3–A.1.4
6. 핵심은 더 작은 기록이 아니라 구분 가능한 상태다
AKV가 던지는 실무 질문은 기록을 몇 토큰으로 줄일지가 아니다. 원문을 유지하면서 현재 어텐션에서 무엇을 제외하고, 남은 상태가 어떤 경로로 만들어졌는지를 서버가 보존할 수 있는지가 핵심이다. 도구 응답을 버리는 시점과 위치 재배치는 서로 다른 선택이며, 정확도·비용·복원 정확성을 함께 검토해야 한다.
자체 호스팅을 운영하지 않는 팀에는 당장 켤 수 있는 설정이라기보다 추론 인프라를 평가하는 기준에 가깝다. 서버를 바꿀 수 있는 팀도 먼저 호환성과 상태 복원을 입증해야 한다. 텍스트가 같다는 사실보다, 그 상태에 이른 연산 이력이 같다는 사실이 중요해지는 설계다.
참고 자료와 읽는 목적
- arXiv v1 논문: 제출 이력과 논문 식별. 한국 시각 제출일과 수집일은 2026년 10월 21일이다.
- 논문 본문: §§3–4의 연산 의미·상태 관리, Table 3의 정확도/비용, Appendix의 평가 범위 확인.
- 저자 저장소 고정 README: 실제 요청 필드와 전체 메시지 유지 규칙 확인.
- 같은 커밋의 시스템 문서: 환경·지원 조합·제외 기능 확인.


댓글
댓글 쓰기