사진·음성 업무에 어떤 LFM3를 고를까: 생성 모델과 typed decision 분기 구분하기
송장 사진을 받아 금액과 날짜를 채우는 업무를 생각해 보자. 담당자가 원하는 것은 그럴듯한 설명문이 아니라, 어느 위치에서 읽었는지와 해당 필드가 없을 때의 누락 표시다. 반면 사진을 보여 주면서 “이 부분이 왜 이상한가요?”라고 말하고 음성 설명을 듣는 업무는 입력도, 필요한 출력도 다르다. 두 상황은 모두 멀티모달이지만 같은 모델 선택 문제가 아니다. 이 예시는 업무를 구분하기 위한 가상 상황이며 실제 송장을 처리한 사례가 아니다.
핵심은 두 축이다. 먼저 텍스트·사진·영상·음성 중 무엇이 들어오는지 정하고, 다음으로 자유로운 설명이나 음성이 필요한지, 정해진 형식의 판정과 추출이 필요한지 나눈다. 사진에서 정해진 필드와 누락 여부를 받으려면 d1-2B를 후보로, 사진에 음성으로 묻고 음성 답변을 받으려면 LFM3-Omni-2B를 후보로 나눈다.
하나의 백본은 하나의 만능 체크포인트가 아니다
Liquid AI는 2026년 10월 27일 LFM3를 발표했다. 공식 발표가 설명하는 첫 모델군은 공통 LFM3-1.7B-Base에서 갈라진 약 2B급 여섯 모델이다. 텍스트·시각·음성·옴니 네 갈래와 시각 및 옴니에서 파생된 두 decision 모델로 구성된다. 여기서 공통 기반은 학습 계보를 뜻한다. 텍스트 체크포인트 하나를 내려받으면 사진과 음성을 모두 처리한다는 뜻으로 읽으면 안 된다. 공식 발표의 모델군 설명이 이 구분의 근거다.
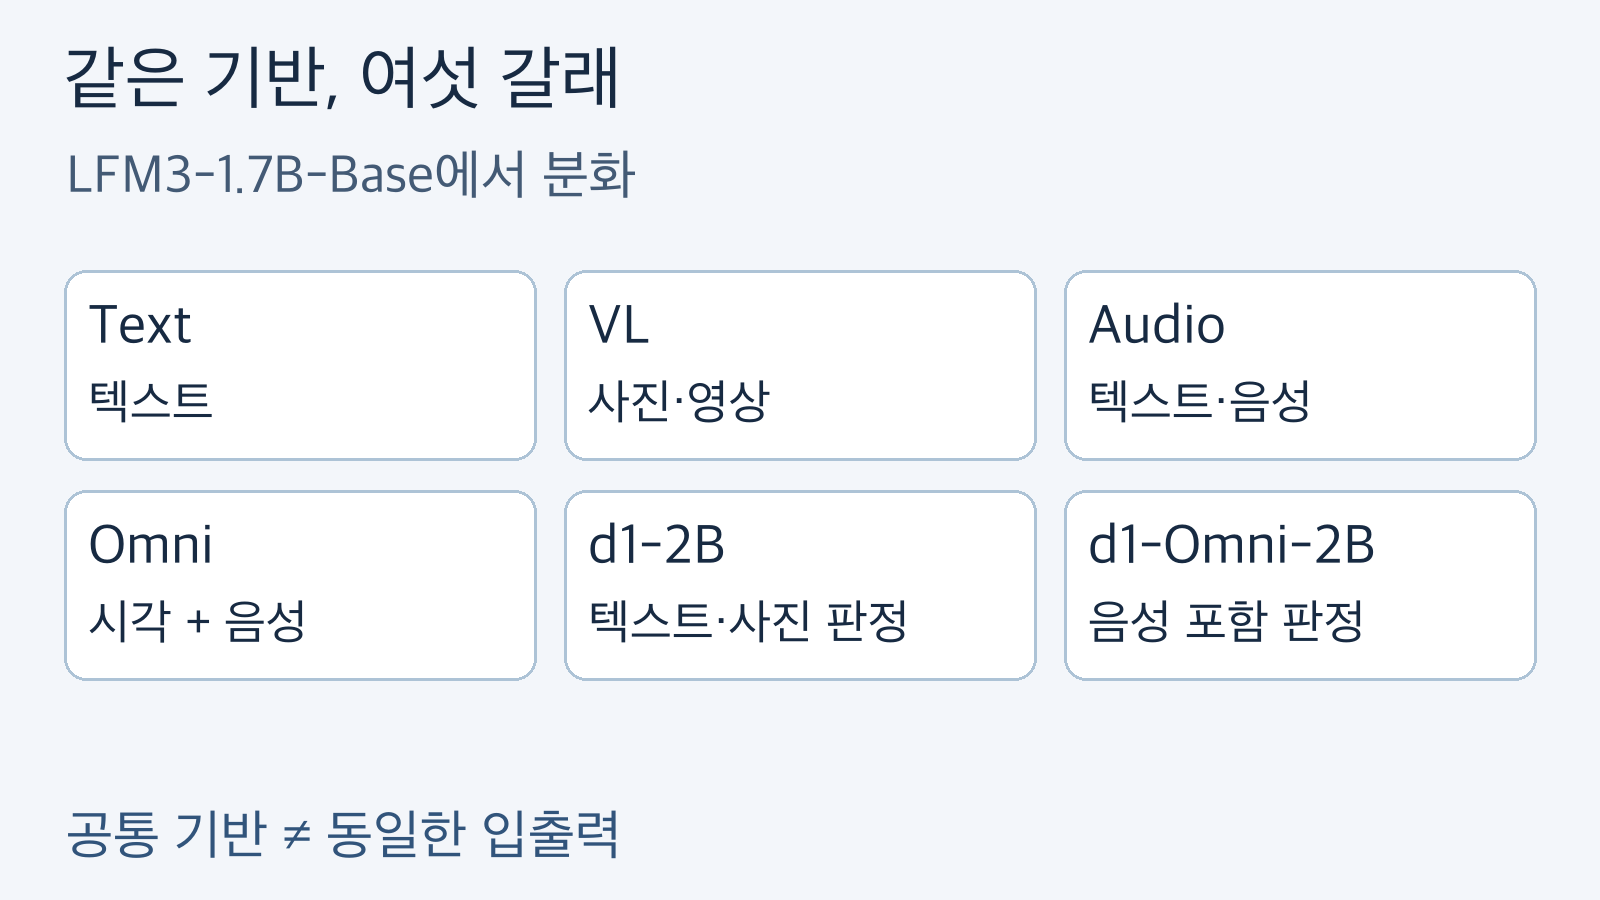
공식 발표를 재구성한 모델군 안내다. 공통 기반은 하나의 만능 입출력 체크포인트를 뜻하지 않는다. 출처: www.liquid.ai/blog/lfm3.
사진에서 긴 해설을 만들 때와 사진에서 날짜 하나를 읽을 때는 같은 입력을 쓰더라도 출력 계약이 달라진다. 따라서 모델 이름의 크기 숫자만 비교하기보다 앱이 소비할 결과 형태부터 적는 편이 실용적이다. 아래 표의 후보는 공식 입출력 설명을 업무에 연결한 편집상 판단이다. 실제 서비스 적합성이 확인됐다는 뜻은 아니다.
입력과 결과를 함께 적는 선택표
| 들어오는 자료 | 앱이 필요한 결과 | 먼저 검토할 후보 | 잘못 넓히면 생기는 오해 |
|---|---|---|---|
| 텍스트 질문·문서 | 텍스트 답변·도구 호출 | LFM3-1.7B | 사진 파일도 직접 이해할 것이라고 가정 |
| 사진·영상과 질문 | 시각 자료에 대한 설명 | LFM3-VL-2B | 음성 입출력까지 같은 경로라고 가정 |
| 텍스트 또는 음성 | 텍스트·음성 응답 | LFM3-Audio-2B | 사진과 소리의 결합 질문도 처리한다고 가정 |
| 사진·영상과 음성 맥락 | 텍스트·음성 응답, 멀티모달 도구 호출 | LFM3-Omni-2B | 도구 호출 생성이 실행 권한까지 준다고 가정 |
| 텍스트·사진 | 필드·위치·범위·복수 선택 판정 | d1-2B | 자유 답변을 생성하는 모델과 동일하게 취급 |
| 음성을 포함한 자료 | 구조화된 판정과 추출 | d1-Omni-2B | 음성 입력 지원을 음성 답변 생성 보장으로 확대 |
표에서 마지막 두 행은 생성형 설명 대신 typed decision이 필요한 경우다. d1-2B는 VL에서, d1-Omni-2B는 Omni에서 파생됐으며 후자는 음성도 입력받는다. 음성 대화가 목적이라면 Audio·Omni의 출력 설명을 봐야지, 이름에 Omni가 들어간 모든 체크포인트를 같은 대화 모델로 보면 안 된다.
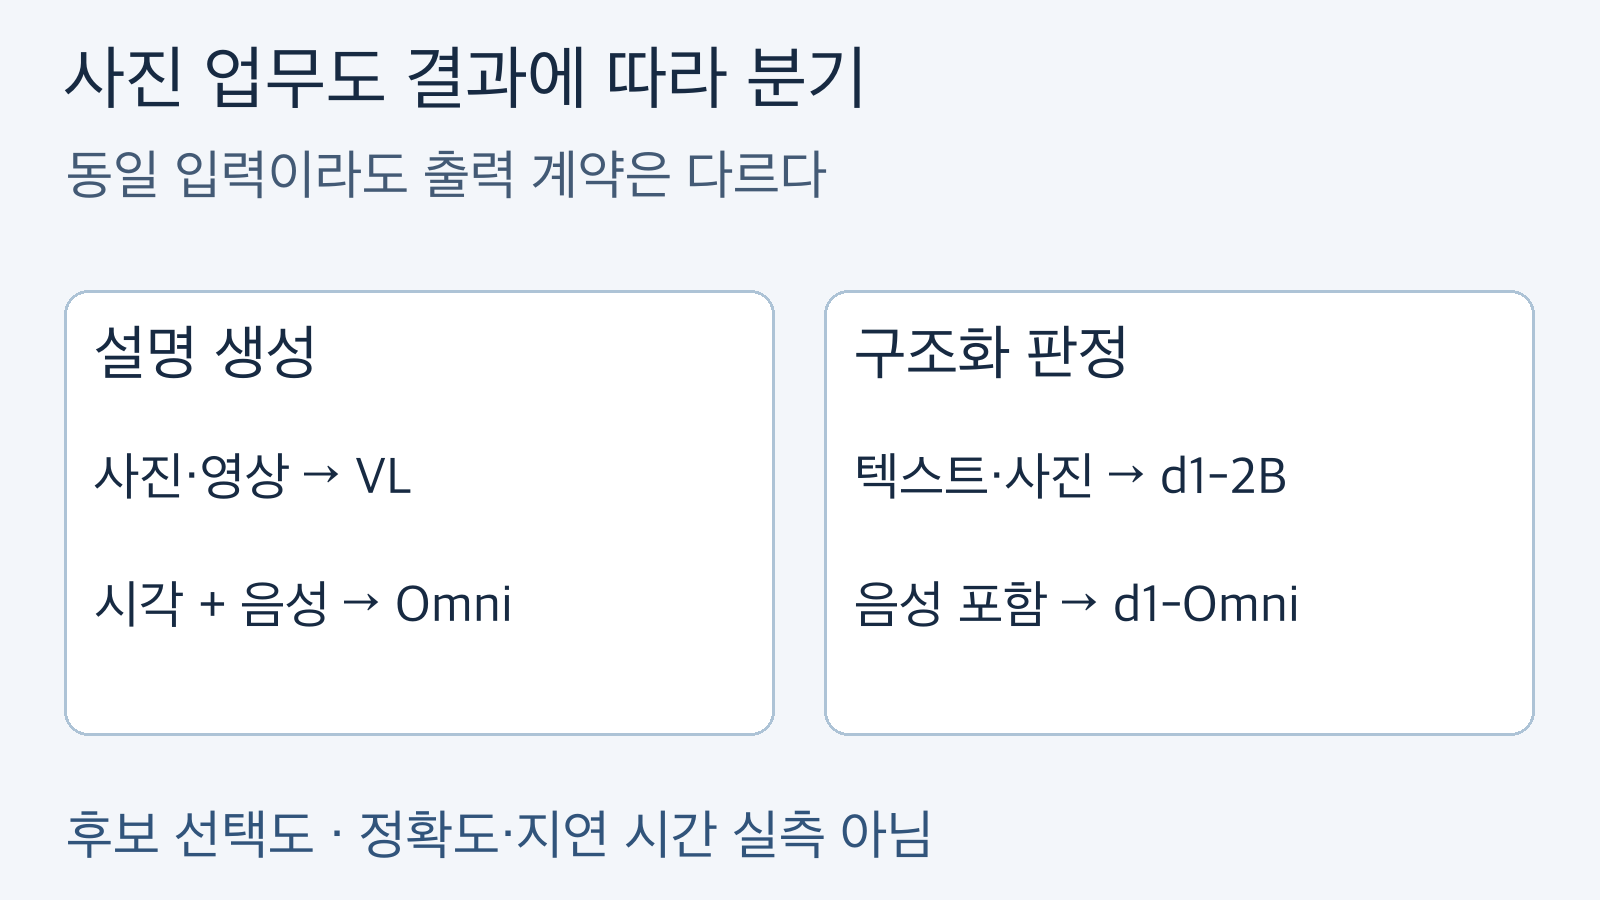
입력과 출력 계약을 함께 고르는 편집상 판단도다. 모델 실행이나 정확도·지연 시간 측정 결과가 아니다. 출처: www.liquid.ai/blog/lfm3.
사진에 대한 음성 질문도 다시 나뉜다. “보이는 고장을 설명해 달라”는 설명 생성 요구와 “반품 대상인지 판정해 달라”는 업무 규칙 판정 요구는 다르다. 후자의 경우 질문 목록과 결과 필드가 무엇인지 먼저 정해 놓아야 typed 출력의 장점이 실제 앱 경계와 연결된다. 모든 업무에 더 많은 모달리티를 넣는 것이 자동으로 이익이라는 결론은 여기서 나오지 않는다.
typed answer를 송장 업무에 대입하면
공식 발표는 기존 yes/no·선택지·점수 외에 Point, Read, Estimate, Pick을 설명한다. 다음은 이를 업무 설계 언어로 바꾼 것이다. 제품 API 응답을 재현한 코드나 실측 결과는 아니다.
| 출력 종류 | 공식 설명의 범위 | 송장·검수 업무의 가상 질문 | 앱이 별도로 확인할 것 |
|---|---|---|---|
| Point | 대상의 박스, 여러 대상과 개수 | 금액이 인쇄된 부분은 어디인가? | 좌표 기준과 원본 이미지 대응 |
| Read | 텍스트·수·날짜, 원문 구간, not found | 청구 날짜가 있는가? 있다면 어느 구간인가? | 날짜 형식, 원문 일치, 누락 처리 |
| Estimate | 수치와 가능 범위 | 특정 수치 추정이 필요한가? | 추정치와 문서에 적힌 값의 구분 |
| Pick | 해당하는 여러 선택지와 각각의 확률 | 사전에 정한 검토 사유 중 무엇이 해당하는가? | 선택지 정의와 후속 검토 기준 |
여기서 가장 중요한 반례는 “필드가 없음”이다. 날짜가 보이지 않는 송장에 오늘 날짜를 대신 채우는 것은 추출이 아니라 새 정보를 만들어 넣는 일이다. Read의 not found는 이 둘을 분리할 수 있는 출력 설계 요소다. 다만 모델이 언제나 누락을 정확하게 찾는다는 보장은 아니다. 스캔 품질이 낮거나 날짜가 여러 곳에 있는 샘플을 따로 넣어 판정해야 한다.
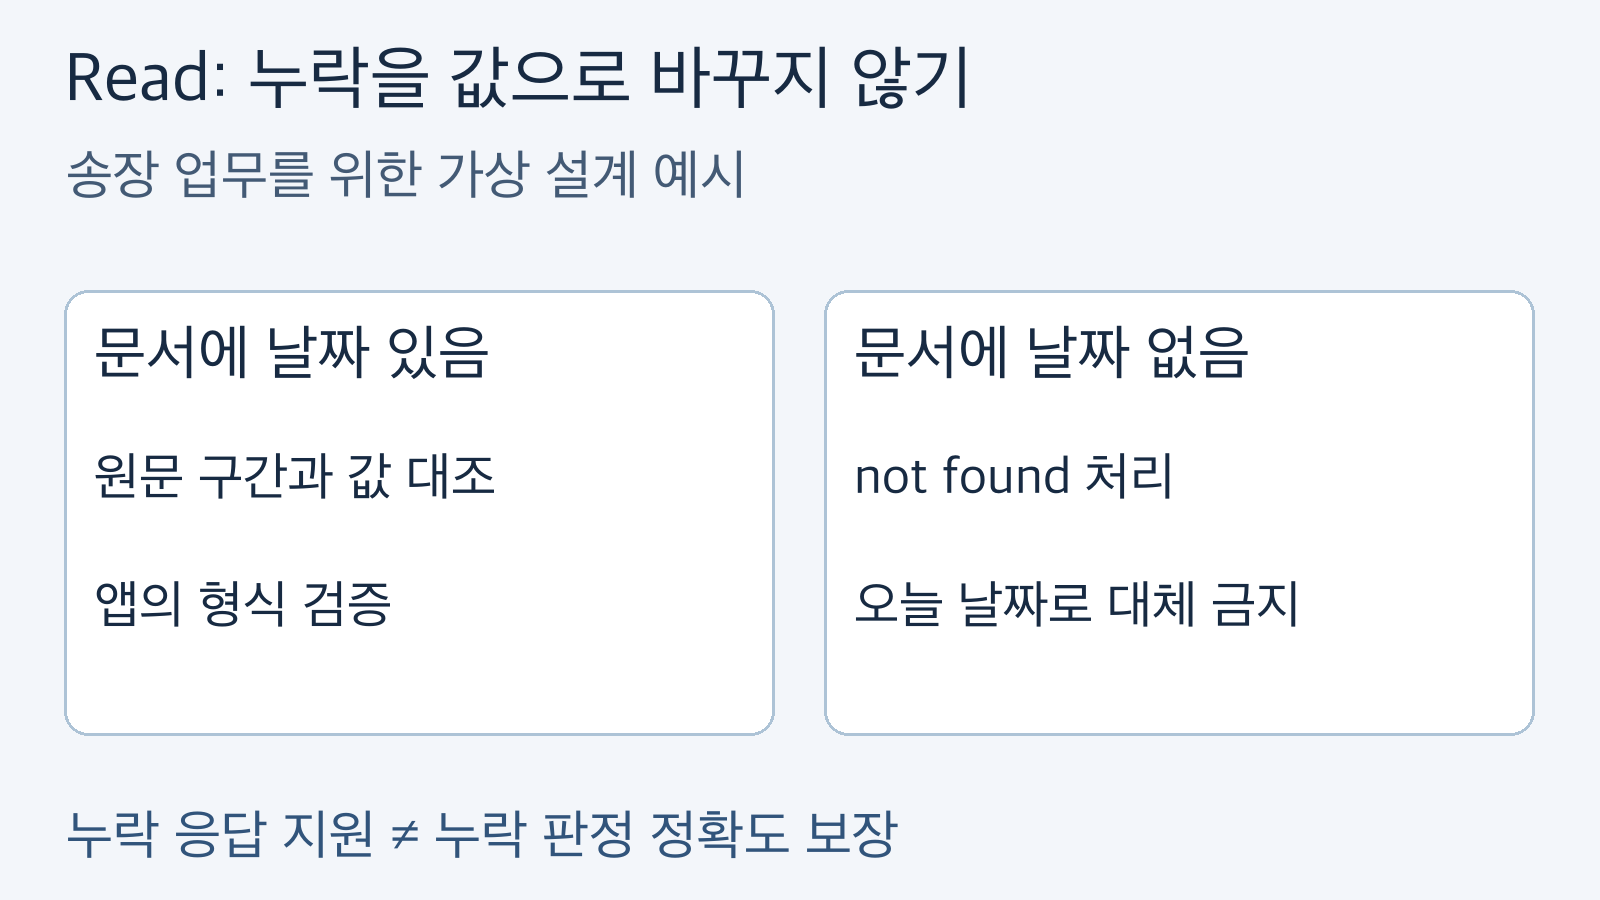
Read의 누락 응답을 활용한 가상 업무 설계다. 날짜를 임의로 채우지 않으며 누락 판정 정확도를 보장하지 않는다. 출처: www.liquid.ai/blog/lfm3.
발표는 여러 질문을 같은 입력에 한 번의 forward pass로 처리하고 각 결과에 보정된 확률을 준다고 설명한다. 이것은 공급자의 기능 설명이지, 내 송장 데이터에서 확률이 검증됐다는 뜻은 아니다. 확률이 높다는 이유로 결제나 회계 등록을 바로 허용하는 규칙도 이 글에서 제안하지 않는다. 실제 앱에서는 원문 구간과 값이 대응하는지, 누락 응답이 허용되는지, 잘못된 확신을 어떻게 검토 대기로 보낼지 따로 설계해야 한다.
예컨대 날짜 필드에 값이 없으면 빈 문자열로 강제 변환하지 않고 “누락으로 검토” 상태를 유지하는 정책을 만들 수 있다. 금액이 추정 범위로 나왔다면 확정 금액 필드와 분리해 저장하는 방식도 생각할 수 있다. 이들은 typed 출력을 활용하는 편집상 설계 예시이며, 모델의 실제 응답 형식이나 공식 SDK 필드명으로 제시하는 것이 아니다. 자동 등록에 필요한 판단 기준은 업무 데이터와 실패 비용을 놓고 별도로 결정해야 한다.
텍스트 사양을 다른 갈래에 옮기지 않기
텍스트 모델 카드는 LFM3-1.7B를 텍스트 전용 후학습 모델로 명시한다. 파라미터는 1.73B, 문맥은 입력과 출력을 합쳐 256K 토큰이며, 언어 목록에 한국어가 들어 있다. 한국어를 나열했다는 사실은 한국어 송장이나 음성 대화의 업무 성공률을 측정했다는 뜻이 아니다. 특히 텍스트 카드의 언어 목록만 보고 다른 Audio 체크포인트의 한국어 음성 품질까지 판단할 수 없다.
4비트 정밀도에서 약 1GB라는 설명 역시 텍스트 모델의 공급자 안내다. 실제 프로세스 최대 메모리나 긴 문맥의 캐시까지 포함한 보장치가 아니며, 시각·음성 인코더가 붙은 모든 모델의 요구량으로 확장할 수 없다. 모델 크기가 작다는 이유로 저장 공간·메모리·지연 시간의 별도 확인을 생략하면 선택표를 제대로 만들고도 배포 단계에서 막힐 수 있다.
카드는 지식 중심 업무에는 검색이나 검색 증강을 쓰도록 안내하고, 작은 크기 때문에 agentic coding과 복잡한 다단계 추론에는 권장하지 않는다고 적는다. 따라서 이 모델군을 소개하면서 복잡한 코딩 에이전트 전체를 대체한다고 결론내리는 것은 범위를 벗어난다. 이 글의 비교 기준은 순위표가 아니라 입력과 출력의 적합성이다.
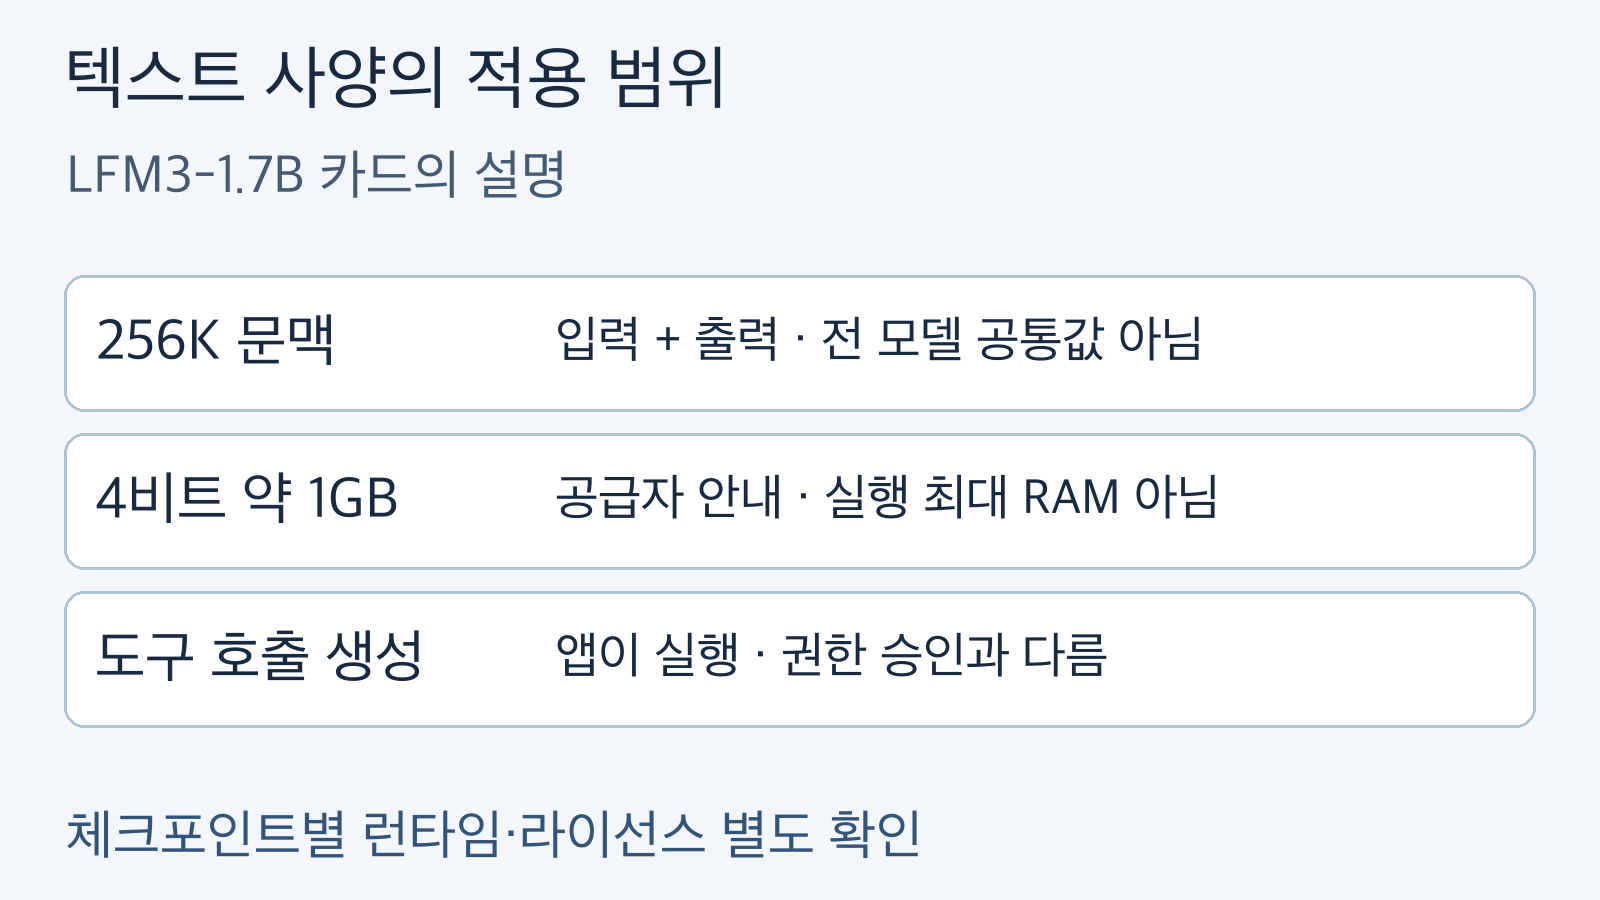
256K와 약 1GB는 텍스트 모델 범위다. 모든 변형의 실행 메모리나 앱의 도구 실행 권한을 보장하지 않는다. 출처: huggingface.co/LiquidAI/LFM3-1.7B/raw/main/README.md.
선택 뒤에는 실행 경계와 조건을 확인한다
텍스트 카드의 Transformers 예시는 trust_remote_code=True를 사용한다. 이 글에서는 저장소 코드나 모델 가중치를 내려받아 실행하지 않았다. 도입할 때는 코드 검토와 격리 실행이 별도 단계라는 점을 남겨 두는 것이 맞다. 도구 호출 역시 모델이 생성한 호출을 애플리케이션이 해석하고 실행하는 구조다. deferred tool search의 검색 도구는 하네스가 구현한다. 모델이 도구를 고를 수 있다는 설명을 계정 권한이나 외부 작업 승인으로 바꾸면 안 된다.
텍스트 체크포인트에 연결된 LFM Open License v1.0에는 상업적 사용 제한과 재배포 조건이 있다. 매출 기준 정의와 상업 이용 조항의 경계 표현은 별도 해석이 필요하므로 여기서는 특정 경계 기업의 이용 자격을 단정하지 않는다. 다른 VL·Audio·Omni·d1 체크포인트의 배포 권한까지 이 텍스트 라이선스 확인으로 대신하지도 않는다. 선택한 변형의 라이선스와 사용 조건을 실제 도입 시점에 다시 읽어야 한다.
내부 관련 글은 이번 패키지에서 별도 검증하지 않아 링크를 억지로 추가하지 않았다. 이전 LFM2.5의 메모리 비교를 이번 모델의 성능 증거로 가져오지 않고, 이번에 고정한 공식 발표·텍스트 카드·라이선스에 한정해 판단했다.
결론: 더 많은 입력보다 필요한 결과부터
송장 필드가 필요하면 입력 지원 여부에 더해 Read의 원문 구간과 누락 처리가 업무 경계에 맞는지 본다. 사진과 음성을 함께 이해하고 대답하는 것이 목적이면 Omni의 입출력 설명을 검토한다. 음성 입력으로 구조화된 업무 판정을 원하면 d1-Omni라는 다른 분기로 좁혀진다. 공통 백본을 안다는 것보다, 같은 자료에서 설명을 생성할 것인지 정해진 결과를 얻을 것인지 구분하는 일이 선택에 더 직접적이다.
이 글은 공식 문서를 바탕으로 만든 선택 안내이며, 모델 실행·한국어 음성 품질·송장 정확도·지연 시간을 측정한 결과가 아니다. 본문의 선택표와 가상 송장 예시는 독자의 후보 선정을 돕는 원본 분석이고, 실제 배포 성공이나 자동 처리 권한을 확인한 기록은 아니다.
근거와 확인 범위
- Liquid AI LFM3 발표: 모델군, Vision·Audio·Omni 입출력, Decision의 파생 관계와 typed answers. 발표일은 2026년 10월 27일이며 이 글은 10월 28일 수집한 고정 본문을 검토했다.
- LFM3-1.7B 공식 모델 카드: 텍스트 전용 사양, 한국어 목록, 메모리 안내, 비권장 업무, 도구 실행 주체.
- 해당 텍스트 체크포인트 라이선스: 조건부 이용과 재배포 조항. 다른 변형의 라이선스나 법률 자문을 대신하지 않는다.


댓글
댓글 쓰기