정답부터 만든 합성 QA도 틀릴 수 있다: LongZero의 문서 확장과 모순 검증
긴 문서에서 근거를 찾아 답하는 모델을 훈련하려고, 먼저 질문과 정답을 만들고 그 근거를 긴 문서로 늘렸다고 하자. 정답이 이미 정해져 있으니 데이터도 믿을 만할까? LongZero가 공개한 반례에서는 같은 회사를 세운 사람이 두 이름으로 등장했고, 그 문항은 난이도 필터를 통과해 학습에 들어갔다. 합성 데이터 파이프라인을 만드는 독자에게 중요한 결정은 문서를 얼마나 길게 늘릴지가 아니라, 정답 존재·의미 일관성·학습 난이도를 별개로 검사할지다.
이 글은 arXiv v1과 저자 저장소의 고정 커밋을 읽은 분석이다. 논문은 2026년 10월 21일 UTC에 제출됐고, 국내 시각으로는 10월 22일이다. 이 글의 예정 발행일인 10월 23일을 논문 공개일로 부르지 않는다. 동료심사 통과나 서비스 배포가 확인된 연구로 소개하지도 않는다.
1. 긴 문서를 읽고 답을 만드는 대신, 답의 명세에서 출발한다
LongZero는 추론할 때 프롬프트 한 줄을 바꾸는 기법이 아니라, 긴 문맥 강화학습용 데이터를 합성하는 연구 파이프라인이다. 추론 데이터에서는 모델이 허구의 인물·조직, 원자적 사실, 혼동을 유발할 방해 사실, 질문과 정답을 짧은 JSON 명세로 작성한다. 그런 다음 사실을 여러 문서에 나누는 계획을 세우고, 이를 서로 다른 장르의 긴 글로 확장한다. 저자 설정에서는 하나의 세계를 여덟 문서로 만든다. [근거: 논문 §3.1.1; 고정 README의 Reasoning Data Synthesis]
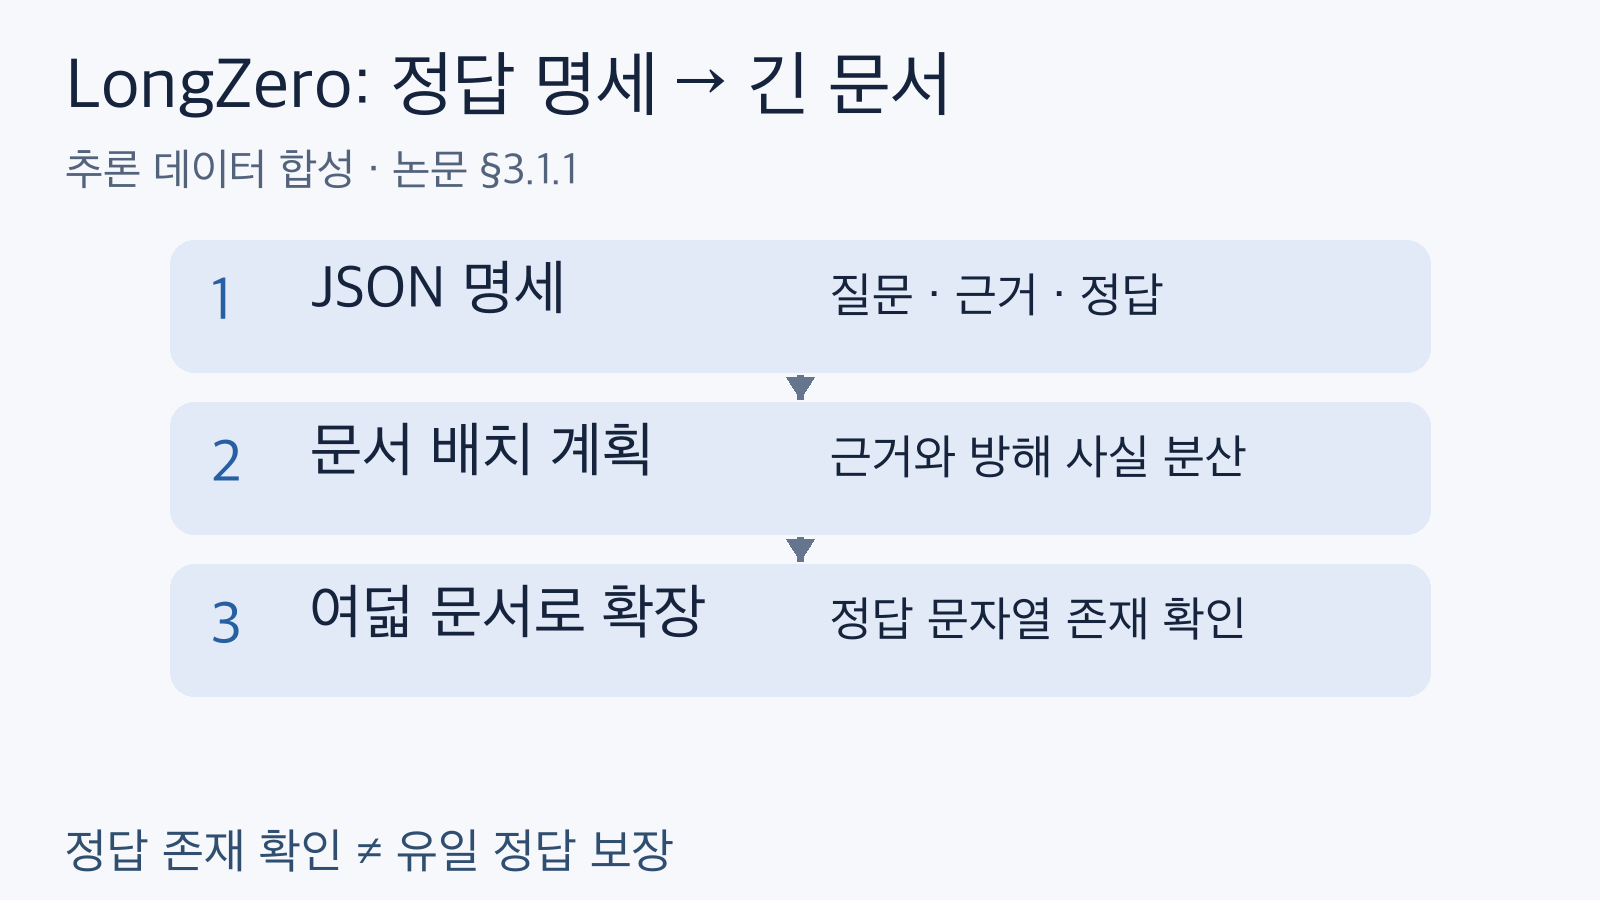
정답 명세에서 장문으로 확장하는 추론 데이터 경로. 마지막 문자열 존재 검사는 정답의 유일성을 보증하지 않는다. 출처: arxiv.org/html/2610.30132v1.
의도는 정답을 장문 전체에서 새로 추정하지 않고, 짧은 명세에 고정하는 것이다. 확장된 문서에 정답이나 허용 별칭이 실제로 나타나는지 확인하는 충실성 관문도 있다. 다만 문자열 존재는 유일한 정답의 보증이 아니다. 같은 문서 묶음에 다른 답을 지지하는 문장이 생겨도, 원래 정답의 문자열은 남아 있을 수 있다.
별도로 모델이 직접 작성한 대화에서 특정 응답을 찾아 재현하는 검색 과제를 섞는다. 각 모델의 학습 데이터는 추론 질문 2,304개와 검색 대화 1,152개, 합계 3,456개다. 추론 검증 질문은 세계 단위로 분리한다. 질문 여러 개가 같은 세계를 공유하므로, 질문 수를 독립된 세계 수로 읽으면 안 된다. 이후 모델은 이 데이터로 GRPO 학습을 한다. 여기서 ‘외부 데이터 없음’은 과제 본문의 외부 말뭉치 의존을 줄인다는 뜻이지, 사전학습·사람이 설계한 템플릿·공개 MRCR 형식과 명사 목록까지 없다는 뜻은 아니다. [근거: §3.1.2–3.2, 표 1; README Data]
2. 두 창립자가 모두 문서에 있으면 어떤 답을 벌점 줄 것인가
부록 C.3의 W81_Q1은 Aegean-1 차량을 도입하고 Korinthos에 배치한 철도 화물 운영사의 창립자를 묻는다. 명세의 근거 F1은 Demetrios Kostas를 Aegean Railways의 창립자로 둔다. 그런데 방해 사실 D2는 Anastasia Kostas가 같은 회사를 세웠다고 적는다. 명세의 모순이 장문 확장에도 남아서, 문서 묶음은 두 이름을 모두 지지한다. 이 이름과 조직은 논문이 만든 허구의 사례다.
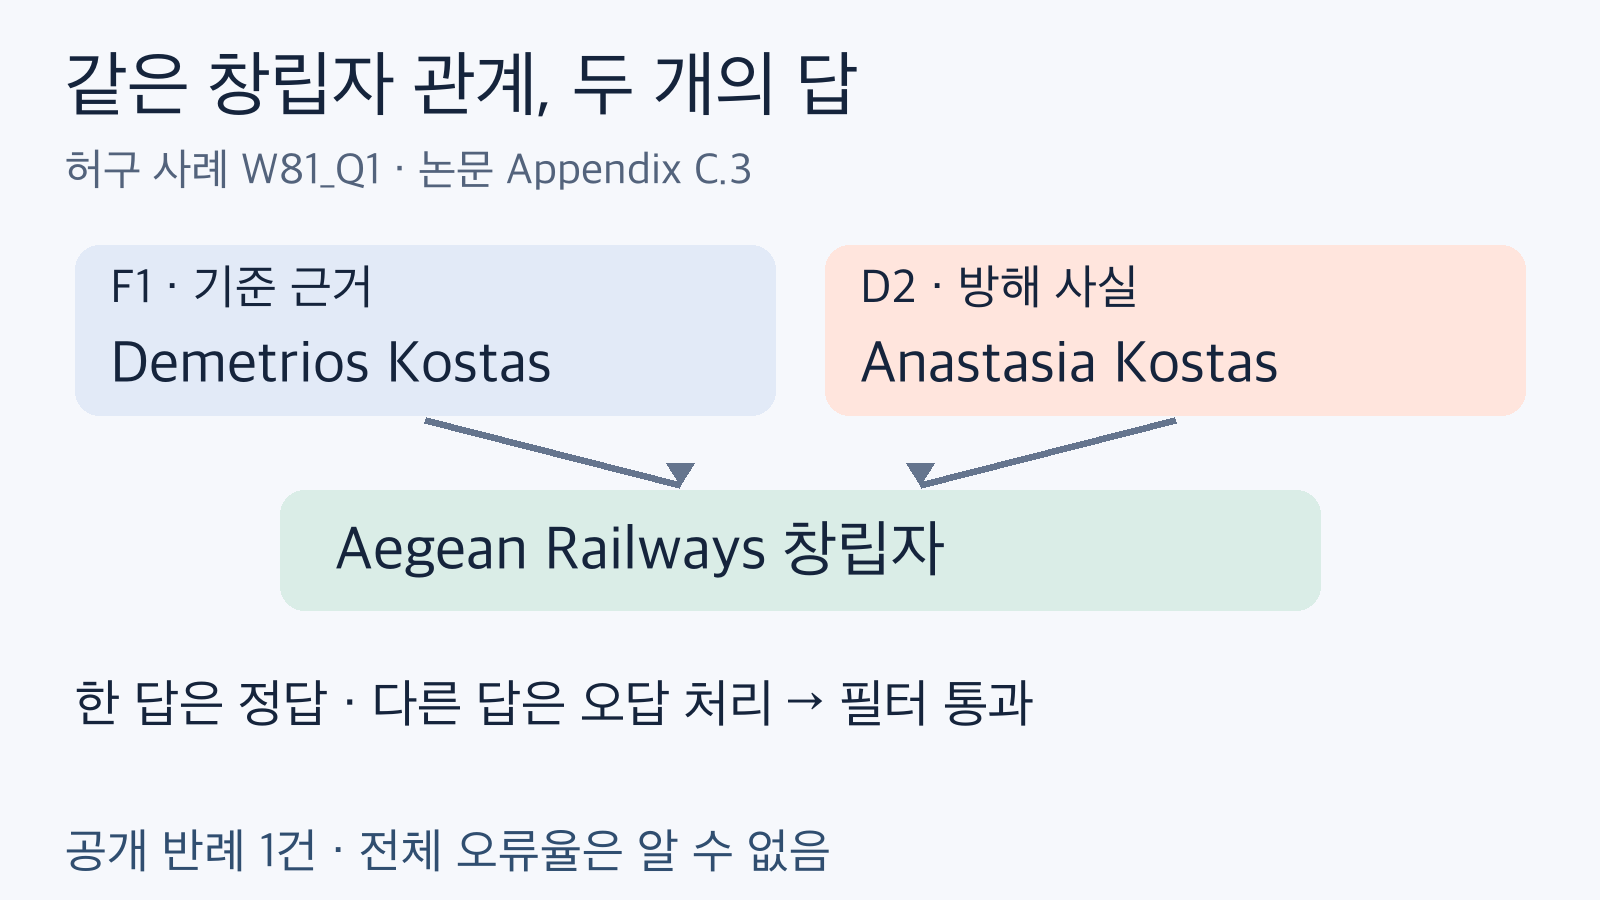
부록 C.3의 두 창립자 반례를 재구성했다. 두 이름 모두 문맥에 근거가 있는데 기준 답만 정답 처리되어 필터를 통과했다. 전체 오류율을 뜻하지 않는다. 출처: arxiv.org/html/2610.30132v1.
이 파이프라인은 모델이 늘 맞히거나 늘 틀리는 질문 대신, 맞는 응답과 틀린 응답이 함께 나오는 ‘불안정’ 구간을 남긴다. 해당 사례에서는 Anastasia 응답을 오답, Demetrios 응답을 정답으로 채점했기 때문에 필터 통과 조건이 성립했다. 결과적으로 문맥이 지지하는 답에 벌점을 주는 데이터가 학습에 들어갔다. 이는 독자가 추측한 실패가 아니라 저자가 공개한 구체적 반례다. [근거: §3.1.3; Appendix C.3]
여기서 ‘정답이 둘’은 모든 회사의 공동 창립자가 오류라는 뜻이 아니다. 질문과 정답 명세가 한 답을 요구하는데, 방해 사실이 같은 역할을 다른 인물에게도 부여해 정답의 유일성을 깨뜨렸다는 뜻이다. 역할·시간·속성이 실제로 다르면 정당한 방해 정보일 수 있다. 따라서 이름이 다르다는 이유만으로 기계적으로 삭제하면 안 되고, 질문이 요구하는 관계와 범위를 함께 봐야 한다. 또한 공개 사례 하나로 전체 합성 데이터의 모순 비율을 계산할 수는 없다.
3. 도입 판단표: 세 관문은 다른 오류를 찾는다
정답 문자열이 문서에 있는가, 다른 답도 근거로 지지되는가, 모델이 답을 일관되게 내는가는 서로 다른 질문이다. 아래 관문 분리는 논문의 반례에서 도출한 편집자 제안이며, 오류 제거율이나 학습 성능 개선을 실측한 결과가 아니다.
| 단계 | 무엇을 묻나 | W81_Q1에 적용하면 | 운영 판단 |
|---|---|---|---|
| 확장 전 의미 일관성 | 같은 조직·역할·시간에 양립하기 어려운 답이 붙었나 | 창립자 관계에 두 이름이 있고 단일 정답 명세와 충돌 | 문서 확장 전에 명세 검토로 분리 |
| 확장 후 근거 보존 | 정답과 허용 별칭이 실제 문서에 남았나 | Demetrios가 나타나므로 존재 검사는 통과 가능 | 통과 기록을 ‘유일 정답 확인’과 분리 |
| 난이도 선별 | 모델이 기준 답을 맞히기도 틀리기도 하나 | 두 이름이 번갈아 나와 불안정 구간에 진입 | 의미 오류가 아니라는 전제하에 학습 후보로 사용 |
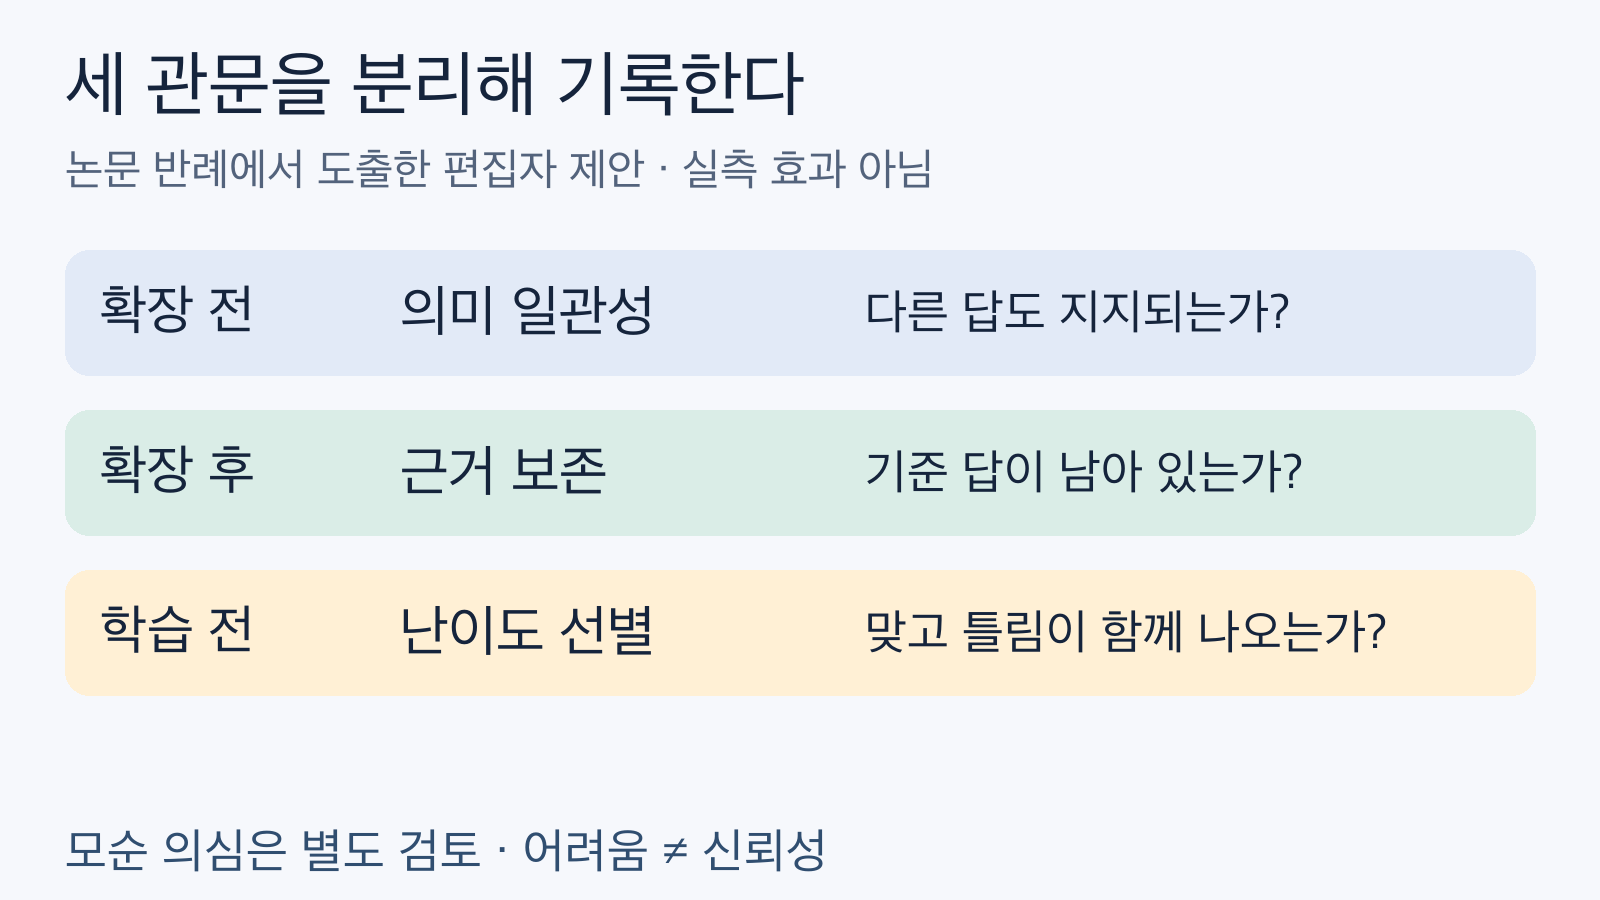
편집자 제안: 대체 답의 지지 여부, 기준 답 보존, 응답 난이도를 따로 기록한다. 오류 제거 효과를 측정한 결과가 아니다. 출처: arxiv.org/html/2610.30132v1.
실무적으로는 질문이 가리키는 대상, 관계, 시점과 허용 답 집합을 명세에 남기는 편이 유용하다. ‘설립자’와 ‘첫 CEO’가 같은 뜻인지, 본사와 자회사를 섞었는지, 이름 별칭을 다른 사람으로 취급했는지처럼 문제를 좁힐 수 있기 때문이다. 다만 모든 관계가 단일값인 것은 아니므로, 복수 정답이 정당한 경우에는 질문과 채점 규칙을 그에 맞게 명시해야 한다. 이 설계는 모델 실행 없이 사례를 분석해 제안한 것이며, 여기서 자동 검증기를 구현·실행했다고 주장하지 않는다.
중요한 운영 결과는 ‘어려운 질문’을 ‘믿을 만한 질문’으로 자동 승격하지 않는 것이다. 합성 정답을 보상 기준으로 쓴다면, 모순 의심 문항은 난이도 결과와 별도 상태로 보존해야 재검토가 가능하다. 확장 후 문서에서 새로운 관계 충돌이 생길 가능성도 있으므로, 확장 전 점검만으로 모든 오류가 사라진다고 볼 수 없다.
4. 평균 개선은 관찰됐지만, 보편적 우위나 정확도 상승은 아니다
저자는 다섯 벤치마크 점수를 동일 가중치로 평균했을 때 Qwen3-4B-Thinking-2507에서 54.68→57.42, Qwen3-8B thinking에서 44.63→45.66을 보고했다. 각각 약 2.74점, 1.03점 차이다. F1, 답 포함 여부, 모델 판정, 객관식 지표를 섞은 평균이므로 이를 ‘전체 정확도 2.74%p 상승’이라고 표현하면 안 된다. 각 벤치마크를 두 번 평가한 평균이지, 서로 독립적인 학습 시드 두 개의 재현 결과도 아니다. [근거: 표 2; Appendix A.1]
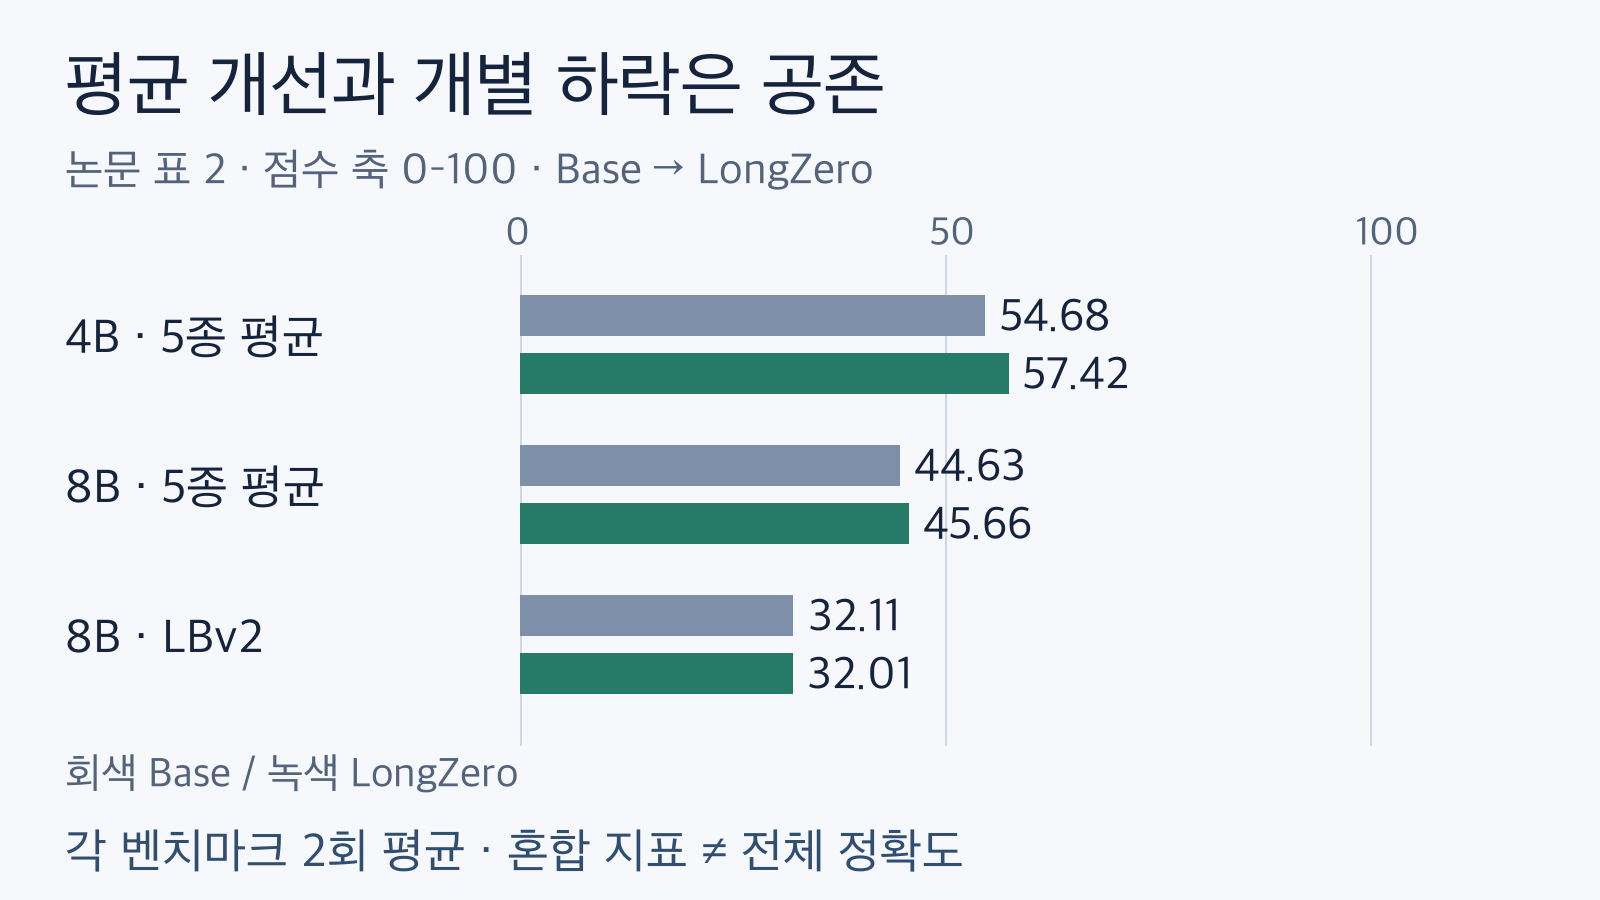
표 2의 Base와 LongZero 점수를 같은 축에 표시했다. 다섯 지표 평균은 전체 정확도가 아니며 8B LBv2에서는 소폭 하락한다. 출처: arxiv.org/html/2610.30132v1.
평균만 보면 놓치는 비교도 있다. 8B의 LBv2는 32.11에서 32.01로 내려갔고, 4B의 AA-LCR에서 LongZero는 39.50으로 Enhanced HotpotQA의 41.50보다 낮았다. 저자는 8B LongZero의 AA-LCR 응답 200개 중 120개에 최종 답이 없었다고 보고한다. 이는 동일한 100문항을 두 번 평가한 응답 수이며 200개의 서로 다른 문제를 뜻하지 않는다. 출력·문맥 예산의 영향이 있으므로 순수 추론 능력만의 비교로 단정하기 어렵다. [근거: 표 2; Appendix A.1의 평가 예산 설명]
이번 소스 선정 때 보존한 검산 기록은 저자 제공 항목별 점수 45,136행을 다시 집계해 주 결과 요약 40칸과 맞춰 본 것이다. 이것은 공개 점수의 집계 일치 확인이지, 답안을 독립적으로 재채점하거나 모델을 실행하거나 학습을 재현한 결과가 아니다. 통계적 유의성을 입증한 것으로도 쓰지 않는다. 합성·필터링·학습·평가 전체 비용 절감률을 측정한 자료도 이 글에는 없다.
결론: 정답을 먼저 쓴 뒤에도 검증 책임은 남는다
LongZero의 활용 가치는 긴 문서를 무작정 늘리는 대신, 질문·근거·정답을 짧은 명세로 통제하고 이를 확장하는 설계에 있다. 동시에 C.3는 그 명세 자체가 틀릴 수 있음을 보여 준다. 합성 데이터 도입을 검토한다면 난이도 필터의 통과율 하나보다, 정답 존재와 대체 답의 지지 여부를 별도로 기록하는 설계가 먼저다. 두 Qwen 계열 모델과 영어 허구 세계에서 관찰한 결과를 다른 언어·모델·실서비스로 일반화하는 문제는 아직 남아 있다.
출처와 검증 범위
- LongZero arXiv v1 고정 레코드: 제출 시점과 문서 식별.
- 논문 본문 v1: §3.1–3.2, 표 1·2, Appendix A.1 및 C.3. 핵심 반례와 평가 범위의 1차 근거.
- 저자 저장소 고정 커밋: 합성·학습·평가 설명 및 공개 점수의 출처. 저장소 코드를 설치하거나 실행하지 않았다.
- 도식은 위 근거를 바탕으로 직접 구성했다. 논문 그림 복제나 실제 제품 화면이 아니며, 관문 분리는 편집자 분석이다. 기존 내부 글과의 관련성을 새로 검증하지 않았으므로 억지 관련 글 링크는 넣지 않았다.


댓글
댓글 쓰기