형식에 맞는 답과 계산이 맞는 답은 다르다: Qwen 영어 덧셈의 출력 검증과 지연 비교
응답이 영어 숫자 단어만으로 이루어졌다면 계산도 맞았을까? 서비스가 구조화된 출력을 받는다고 해서 내용의 정확성까지 확보되는 것은 아니다. 7 + 9에 seventeen이라고 답하면 형식은 자연스럽지만, 사용자가 요청한 합은 틀렸다. 자동화가 형식 검사만 보고 다음 결제나 보고 단계로 넘어간다면, 겉으로는 정상 응답인 오류가 그대로 전파된다.
Simon Willison이 2026년 10월 4일 공개한 「Qwen3.8 27B addition in words」는 이 구분을 작은 과제에서 보여준다. 로컬 모델에 양의 정수 두 개를 더하고 결과를 영어 단어로만 쓰도록 요청했다. 소개 글의 최초 공개 시각은 한국 시간 10월 5일 오전 8시 34분이며, 보존된 실험 manifest의 준비 날짜는 9월 30일이다. 모델 출시 발표나 오늘 새로 실행한 벤치마크로 읽어서는 안 된다.
이 글의 목적은 모델 순위를 정하는 것이 아니라 응답 형식, 최종 답의 의미, 지연 예산을 따로 승인하는 검증 절차를 만드는 것이다. 이 글은 저장된 저자 채점과 파싱된 정수의 재집계이며, 모델 실행·전체 응답 파서의 독립 구현·지연 재현은 하지 않았다. 원 소개 글에는 Codex Remote를 이용해 실험을 수행했다는 설명이 있다. AI가 작성한 보고서만 별개의 연구 근거로 세지 않고, 고정 버전 README와 입력·저장 결과를 함께 대조했다.
1. 영어 숫자로 잘 쓰는 능력과 덧셈 정확도는 다르다
저자의 요청은 “무엇이 두 수의 합인가, 다른 정보 없이 답을 단어로만 써 달라”는 형태다. 평가의 주 지표는 보이는 응답 전체가 유효한 영어 숫자로 파싱되고, 그 정수가 실제 합과 정확히 일치하는지다. 숫자 기호, 설명, 마크업, 부가 문장이 섞이면 실패다. 영어 숫자 문장이더라도 잘못된 정수를 나타내면 역시 실패다.
추론을 끈 전체 실행에서는 피연산자 길이를 각각 한 자리부터 열세 자리까지 바꾸었다. 순서가 있는 자릿수 조합 169개마다 30개를 뽑아 총 5,070개를 평가했다. 전체 정답은 1,195/5,070, 23.57%였다. 반면 영어 숫자 형식에 맞는 응답은 4,876/5,070, 96.17%였다. 두 비율은 같은 전체 실행의 같은 분모를 쓰지만, 묻는 질문은 다르다.
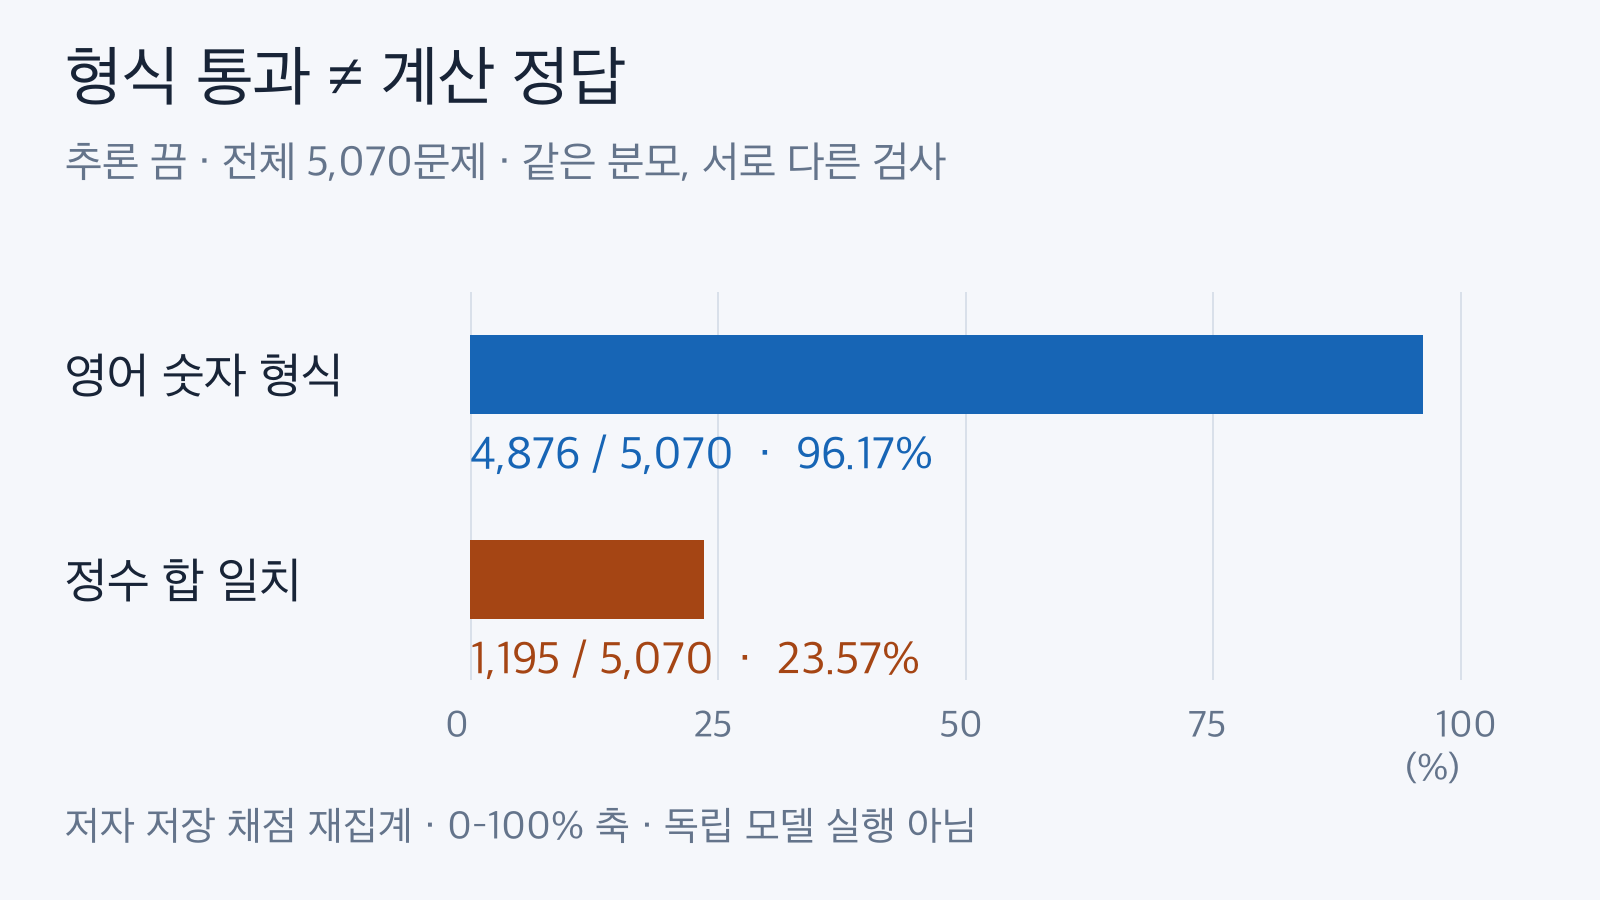
형식 검사는 의미 정확도를 대신하지 않는다. 같은 전체 실행의 저장 채점을 재집계한 그림이며 독립 모델 실행이 아니다. 출처: github.com/simonw/research/blob/af148f91e58c80350f8c2a0fb2ec3984a89b2514/qwen38-addition-in-words/README.md.
그래서 “거의 모든 응답이 규칙을 지켰다”는 보고만으로 이 모델을 계산 업무에 승인할 수 없다. 형식 검사는 결과를 기계가 읽을 수 있는지 판단하고, 의미 검사는 그 결과를 업무에 써도 되는지 판단한다. 형식 실패만 재시도하는 운영은 seventeen 같은 정상 모양의 오답을 잡지 못한다. 이것은 해당 실험에서 도출한 운영 해석이지, 모든 구조화 출력 시스템의 오류율을 측정한 결과는 아니다.
2. 추론 비교는 같은 169문제로 좁혀야 한다
중간 강도 추론을 켠 실행은 전체 5,070문제를 다시 수행하지 않았다. 각 자릿수 조합의 첫 번째 표본인 r01을 골라 169문제를 실행했다. 공정하게 수치를 나란히 읽으려면 추론을 끈 결과에서도 동일한 case ID와 두 피연산자를 가진 169개를 골라야 한다. 전체 실행의 23.57%와 작은 추론 실행의 98.82%를 바로 비교하면 비교 대상이 바뀐다.
| 동일한 169문제의 지표 | 추론 끔 | 중간 강도 추론 |
|---|---|---|
| 보이는 최종 답의 정답 수 | 45/169 | 167/169 |
| 정답률 | 26.63% | 98.82% |
| 영어 숫자 형식 준수 | 164/169 | 168/169 |
| 요청 지연 중앙값 | 1.503392초 | 27.620763초 |
| completion token 합계 | 2,376 | 112,887 |
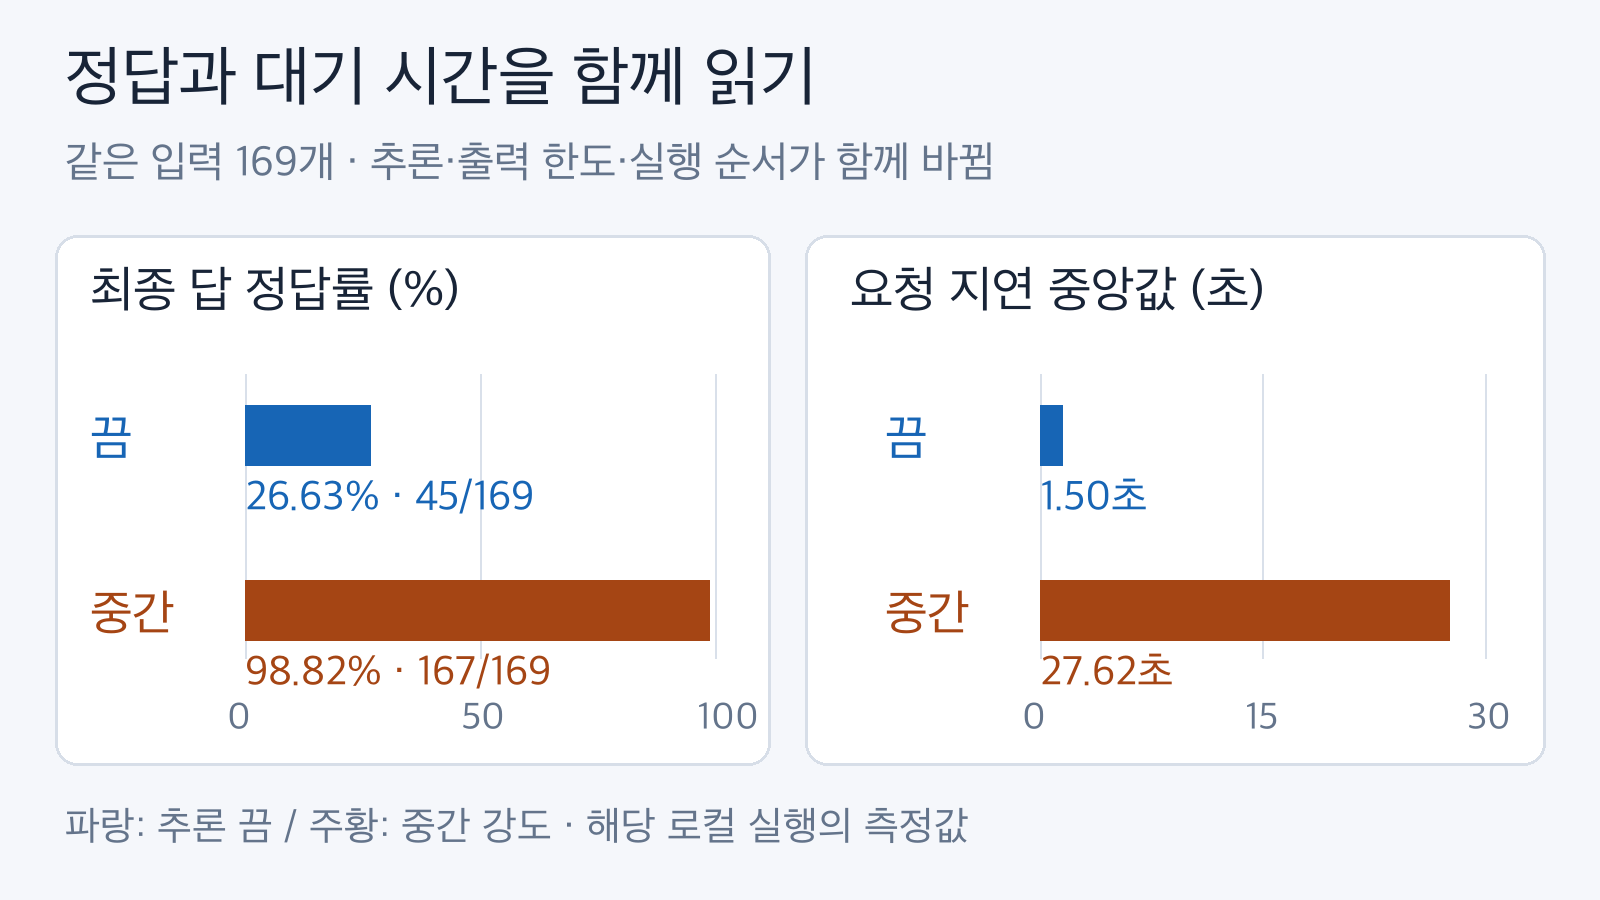
품질 개선과 요청 대기를 함께 읽되 추론만의 인과 효과로 해석하지 않는다. 출력 한도와 순서도 바뀐 로컬 설정 비교다. 출처: github.com/simonw/research/blob/af148f91e58c80350f8c2a0fb2ec3984a89b2514/qwen38-addition-in-words/QWEN38_27B_REASONING_ON_VS_OFF_SHORT_REPORT.md.
두 설정 모두 맞은 문제는 44개, 중간 강도에서만 맞은 문제는 123개, 추론을 끈 설정에서만 맞은 문제는 1개, 둘 다 틀린 문제는 1개였다. 정답 수가 크게 늘어났지만 기존에 맞던 문제 하나도 틀렸다는 점을 함께 보아야 한다. 설정을 바꿀 때에는 전체 평균뿐 아니라 같은 입력에서 어떤 성공이 실패로 바뀌었는지를 기록하는 편이 유용하다.
지연은 해당 로컬 실행의 요청 경과 시간이다. 중앙값은 전형적인 요청을 요약하지만, 최악의 대기 시간이나 동시 처리량은 알려주지 않는다. 표의 토큰은 저장된 completion_tokens 필드의 합계이며 청구 금액이 아니다. 입력 토큰 비용이나 제공사 가격을 끼워 넣지 않았다. 따라서 “추론을 켜면 언제나 이 시간 안에 답한다”거나 “정확도를 올리는 비용이 모든 환경에서 이만큼이다”라는 결론은 낼 수 없다.
3. 계산 과정이 맞아도 최종 출력에서 틀릴 수 있다
중간 강도 실행에서도 보이는 답 두 개가 틀렸다. 첫 번째는 73 + 42,439,903이다. 실제 합은 42,439,976인데, 응답은 42,440,076을 나타내는 단어였다. 추론을 끈 같은 문제는 맞았다. 더 많이 생각하는 설정으로 바꾸었다는 이유만으로 이전의 모든 성공이 보존되는 것은 아니다.
두 번째는 계산과 표현의 연결이 끊어진 사례다. 866,210,161,193 + 296,827,965의 합은 866,506,989,158이다. 저장된 추론 기록은 이 정수에 도달했지만, 최종 답의 맨 앞 단위를 billion이 아니라 trillion이라고 썼다. 응답에는 뒤 그룹의 단위도 잘못 붙었다. 내부 기록 어딘가에 정답이 등장했다는 이유로 사용자가 받은 답을 정답 처리하면 이 실패가 사라져 버린다.
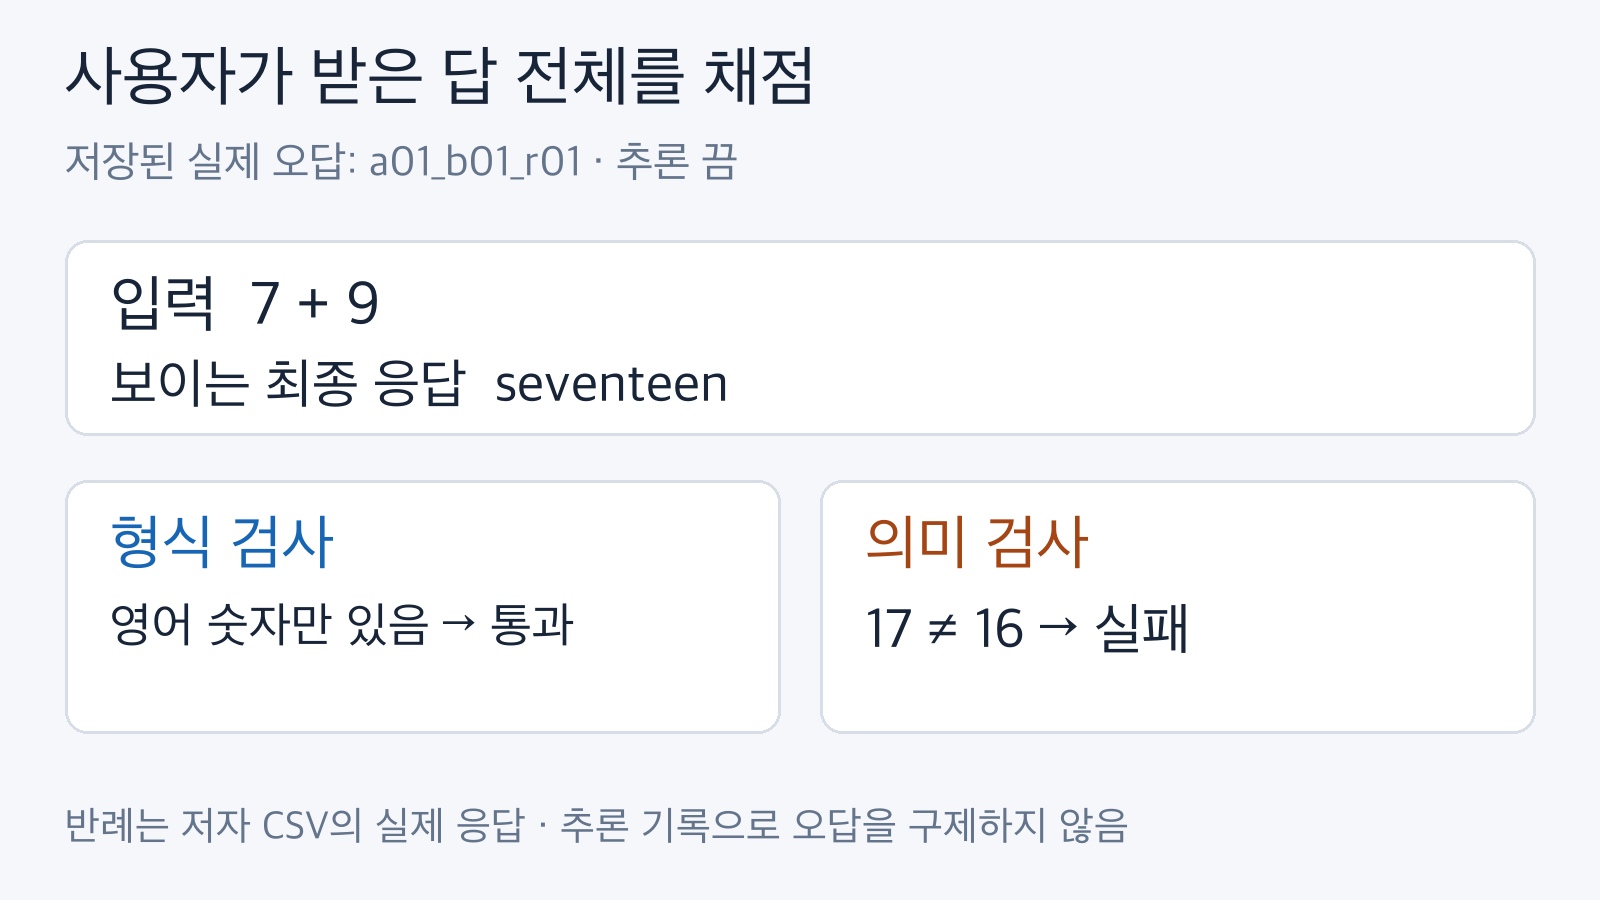
추론을 끈 a01_b01_r01의 실제 응답을 재구성한 설명 그림이다. 제품 화면이 아니며 보이는 최종 답 전체를 채점해야 한다. 출처: github.com/simonw/research/blob/af148f91e58c80350f8c2a0fb2ec3984a89b2514/qwen38-addition-in-words/runs/qwen3.8-27b-q4_k_m-seed-20260929/results.csv.
평가는 서비스가 실제 소비하는 보이는 최종 답 전체를 기준으로 해야 한다. 추론 기록은 원인 분석용 증거가 될 수 있지만 잘못 전달된 값을 구제하는 채점 기준으로 쓰지 않는다. 숫자를 계산하고 영어 표현을 만드는 두 단계 중 어디에서 틀렸는지 분석하더라도, 업무 승인 조건은 끝까지 전달된 값의 정확성이다.
4. 이 비교로 추론 기능 자체의 효과를 분리할 수는 없다
추론 상태만 달라진 실험이 아니다. 추론을 끈 요청은 출력 한도가 128토큰이고, 중간 강도는 max_tokens=-1이었다. 여기서 마이너스 일은 별도의 예측 토큰 상한을 없애는 설정이다. 서버의 컨텍스트가 32,768토큰이므로 문자 그대로 무한한 생성은 아니다. 실행 순서도 무작위로 섞은 순서에서 쉬운 문제 우선으로 바뀌었다.
따라서 이 결과는 두 완성된 실행 설정의 비교이지 추론만의 독립적인 인과 효과가 아니다. 같은 시간이나 같은 토큰 예산으로 비교한 것도 아니다. 운영자가 추론 강도와 출력 한도를 함께 바꾸었다면, 개선 원인을 추론 스위치 하나에만 귀속시키지 말아야 한다. 예산을 고정한 비교는 별도로 설계해야 한다.
적용 범위도 좁다. 기록된 모델 파일은 Qwen3.8-27B-Q4_K_M.gguf이고, 하드웨어는 NVIDIA DGX Spark/GB10, 서버는 CUDA 기반 llama-server의 b1-c398c6e 빌드다. 모델 파일 자체는 공개 실험 저장소에 포함되지 않았다. 양자화, 채팅 템플릿, 서버 빌드, 프롬프트, 디코딩 설정이 바뀌면 동일한 결과를 보장할 수 없다. 영어 숫자 표현과 덧셈, 지시 준수를 합친 이 과제를 일반 업무 정확도나 전반적 지능 점수로 확대하지 않는다.
5. 내 서비스에서는 실패 종류별로 다음 행동을 정한다
이 글의 독자용 산출물은 아래 진단표다. 정답을 계산할 수 있는 업무에서는 모델 응답과 독립된 결정적 기준, 즉 정답 오라클을 둔다. 이 덧셈 과제라면 두 입력 정수의 합이 그 기준이다. 파서가 출력 전체를 읽는지, 잘못된 단위를 허용하지 않는지도 별도로 확인한다. 일부 숫자만 뽑아 일치 여부를 검사하면 불필요한 설명이나 모순된 값을 놓칠 수 있다.
형식 통과는 다음 검사로 넘어갈 조건일 뿐, 업무 성공 승인 조건이 아니다. 다음 표는 저자가 실험한 서비스 정책이 아니라, 보존된 실패 사례에 근거해 이 글에서 작성한 운영 제안이다.
| 관측된 상태 | 실패 분류 | 다음 행동 | 남길 증거 |
|---|---|---|---|
| 응답 전체가 영어 숫자로 파싱되지 않음 | 형식 실패 | 소비 단계로 넘기지 않고 형식 정책 점검 | 원문 응답, 파서 오류, 종료 사유 |
| 파싱은 되지만 정수가 실제 합과 다름 | 의미 실패 | 결정적 계산 경로로 처리하거나 검토 보류 | 두 입력, 기대 정수, 파싱 정수 |
| 정수는 맞지만 요청별 대기 한도를 넘김 | 지연 기준 미충족 | 정확도와 별개로 온라인 경로 승인 보류 | 요청 경과 시간, 타임아웃 기준 |
| 형식·정수·업무 지연 기준 모두 충족 | 해당 입력의 성공 | 그 입력만 다음 단계로 전달 | 입력 ID, 설정, 검사 결과 |
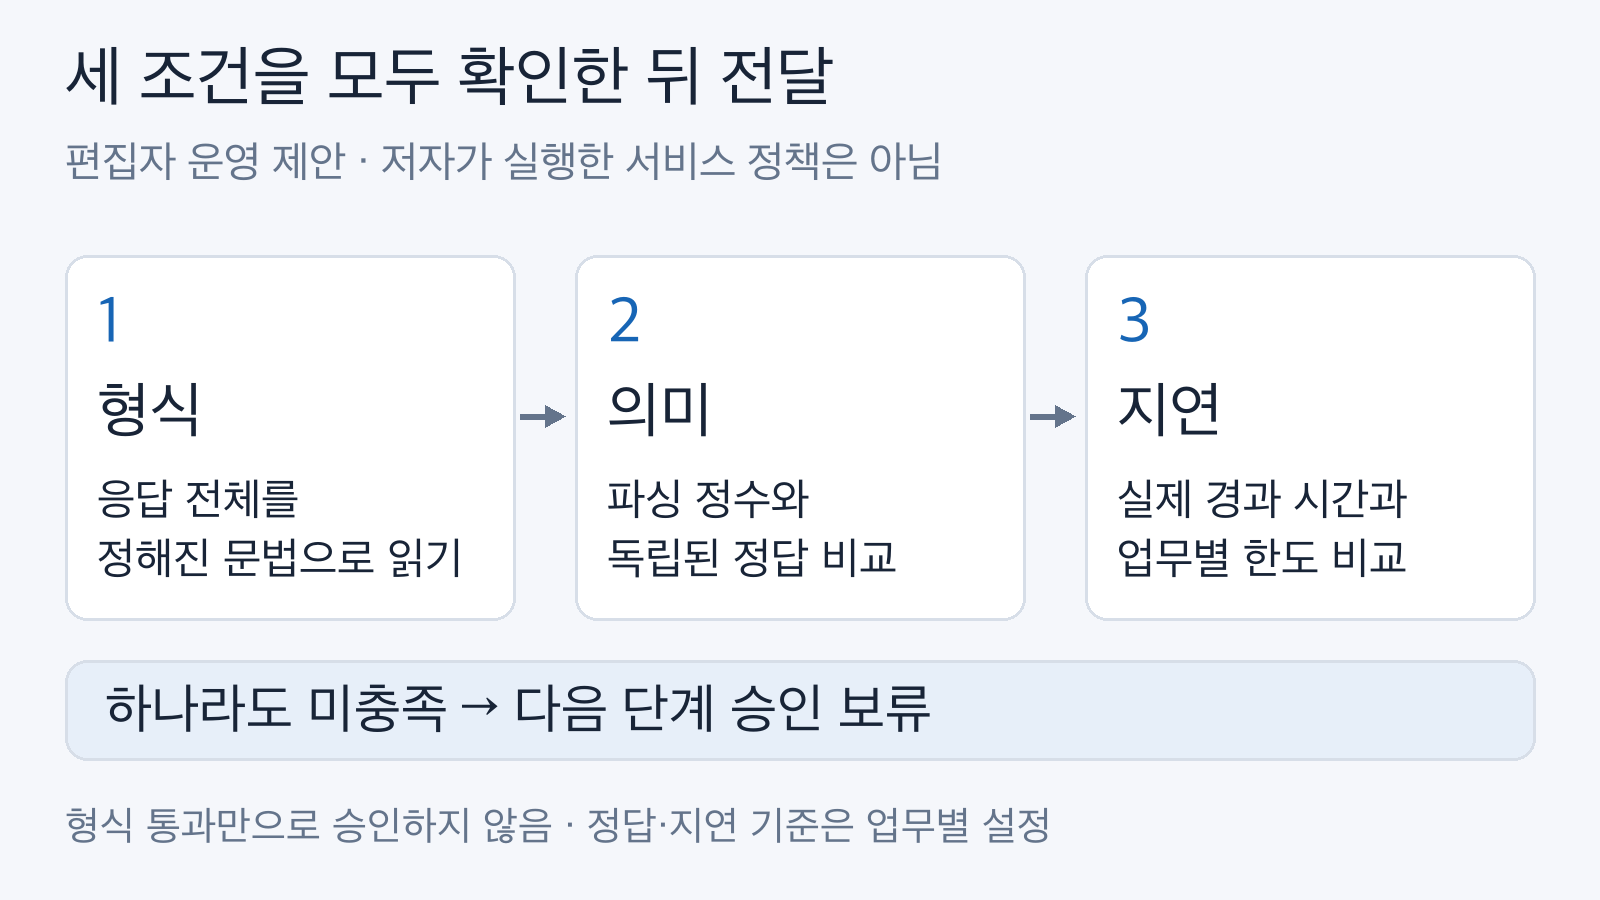
형식·의미·지연을 별개 기준으로 확인하는 운영 제안이다. 저자가 실행한 서비스 정책이나 개선 효과 실험이 아니다. 출처: github.com/simonw/research/blob/af148f91e58c80350f8c2a0fb2ec3984a89b2514/qwen38-addition-in-words/README.md.
핵심은 실패 후 무조건 같은 프롬프트를 반복하는 것이 아니다. 형식 실패와 의미 실패는 다른 증거를 남겨야 하고, 지연 실패는 답이 맞더라도 사용자 경험을 해칠 수 있다. 덧셈처럼 결정적 도구로 처리할 수 있는 핵심 값은 그 도구를 기준으로 삼고, 모델에는 필요한 표현을 맡기는 설계를 검토할 수 있다. 다만 이 실험은 그 대체 설계의 성공률이나 지연을 측정하지 않았으므로 개선 수치를 약속하지 않는다.
설정 변경을 시험할 때는 같은 입력 ID를 유지하고 형식 통과율, 정수 정확도, 요청 지연을 함께 비교한다. 전체 성공 수만 세는 대신 새로 틀린 사례도 따로 확인한다. 이 자료는 각 셀당 하나의 추론 표본만 제공하므로, 자릿수 셀 하나가 맞았다는 이유로 그 셀의 실제 성공률을 확정하지 않는다. 내가 허용할 대기 시간과 오답 위험을 먼저 정한 뒤 자체 입력 집합으로 확인해야 한다.
6. 무엇을 실제로 확인했나
이번 로컬 확인 환경은 Python 3.12.11 / canonical Blogger .venv다. 고정된 source-selection과 보존 근거 파일의 SHA-256을 대조하고, 저장 CSV를 case ID로 연결해 동일 피연산자 여부를 확인했다. 각 행의 이미 파싱된 정수와 파이썬 정수 덧셈을 비교해 저자의 정답 플래그와 일치하는지도 검사했다. 실제 재집계 출력은 off_full: 1195/5070; format: 4876/5070; paired: 45/169 -> 167/169다. 요청 지연 중앙값과 토큰 합계도 저장 열에서 계산했으며 위 표와 일치했다.
이는 공개된 저장 데이터의 산술 검토다. 원 응답 전체를 독립된 영어 숫자 파서로 재채점한 것이 아니며, 채점기의 모든 예외 처리가 옳다는 검증도 아니다. 모델을 실행하거나 하드웨어의 시간을 다시 재지 않았다. 이 구분을 유지해야 저장 로그를 읽은 글이 새 성능 실험처럼 보이지 않는다.
구조화 응답에서 출처의 의미까지 확인해야 하는 사례는 AstaBrief 8B의 인용 보고서 검토와 연결된다. 그 글은 인용·내부 배치의 경계를 다루므로 이번 덧셈 평가와는 다른 주제다. 설정별 점수·시간·비용을 나눠 읽는 방법은 WildClawBench의 CLI 비교에서도 참고할 수 있다. 서로 다른 벤치마크의 점수를 직접 비교하라는 뜻은 아니다.
7. 출처와 다시 읽을 위치
- Simon Willison의 실험 소개: 공개 날짜, 로컬 실험 동기, 작은 추론 표본에 대한 설명.
- 고정 버전 README: Results, Method, Model and machine, Important caveat.
- 동일 169문제 비교 보고서: Paired results, Runtime measure, Every wrong answer.
- 추론을 끈 저장 결과와 중간 강도 저장 결과: 입력 ID, 파싱 정수, 채점, 요청 지연, completion tokens.
형식에 맞는 답은 읽을 수 있는 답이다. 업무에 쓸 수 있는 답인지는 의미와 지연을 포함한 다음 검사에서 결정해야 한다.


댓글
댓글 쓰기