매 턴 생각하지 않는 에이전트: RACE의 추론 토큰 절감과 학습 조건
에이전트의 생각 토큰이 줄었다면 곧바로 운영비도 줄었다고 판단해도 될까? RACE 논문의 WebShop 실험에서는 같은 Qwen3.5-9B 기반의 일반 SFT+GRPO와 RACE-SFT-RL을 비교했을 때, 작업 한 건당 평균 추론 토큰이 2,702에서 535로 줄고 성공률은 52.00%에서 53.40%로 바뀌었다. 하지만 이 결과는 API 청구액 80% 절감이나 성능 무손실을 보장하지 않는다. 아래에서는 비교 행, 성공 판정, 학습 접근 권한을 분리해 읽는 방법을 정리한다.
핵심 결론부터 말하면, RACE는 기존 계획이 다음 행동에도 충분한 턴에서 새 추론을 생략하도록 모델을 학습하는 연구다. 매 턴 생각을 짧게 쓰라는 지시나 도구 호출 자체를 없애는 기능이 아니다. 가중치 학습과 참조 행동 점수 계산에 접근할 수 없다면, RACE를 바로 붙이는 API 프롬프트 최적화로 취급하지 않는다.
1. 먼저 비교 행을 고정한다
원문 Table 2에는 학습하지 않은 Base, RACE-SFT, RACE-SFT+GRPO 등 여러 행이 있다. 이 글의 기본 비교는 일반 학습을 거친 w/o LoGiC (SFT+GRPO)와 RACE-SFT-RL이다. 두 행 모두 같은 Qwen3.5-9B 기반이지만 학습 방식은 다르므로, 추론 생략만 독립적으로 켠 실서비스 A/B 테스트라고 해석해서는 안 된다.
| 평가 환경 | 일반 SFT+GRPO 추론 토큰 → RACE | 토큰 감소율 | 성공률 변화 | 차이 |
|---|---|---|---|---|
| ScienceWorld | 2,073 → 1,403 | 32.32% | 74.55% → 73.28% | -1.27%p |
| WebShop | 2,702 → 535 | 80.20% | 52.00% → 53.40% | +1.40%p |
| AppWorld | 3,545 → 1,900 | 46.40% | 65.30% → 65.13% | -0.17%p |
| DeepSearch | 2,163 → 822 | 62.00% | 35.75% → 35.00% | -0.75%p |
감소율은 논문에 표시된 평균값으로 100 × (1 - RACE / 일반 학습)을 계산해 소수 둘째 자리로 정리했다. 성공률 차이는 뒤의 비율에서 앞의 비율을 뺀 퍼센트포인트다. 이는 발표값 산술 확인이며 모델 실행을 재현한 결과가 아니다. 네 환경 중 세 곳의 성공률 점추정은 낮아졌다. 네 비율을 평균내어 보편적인 효율 향상 점수로 만들지 않는다.
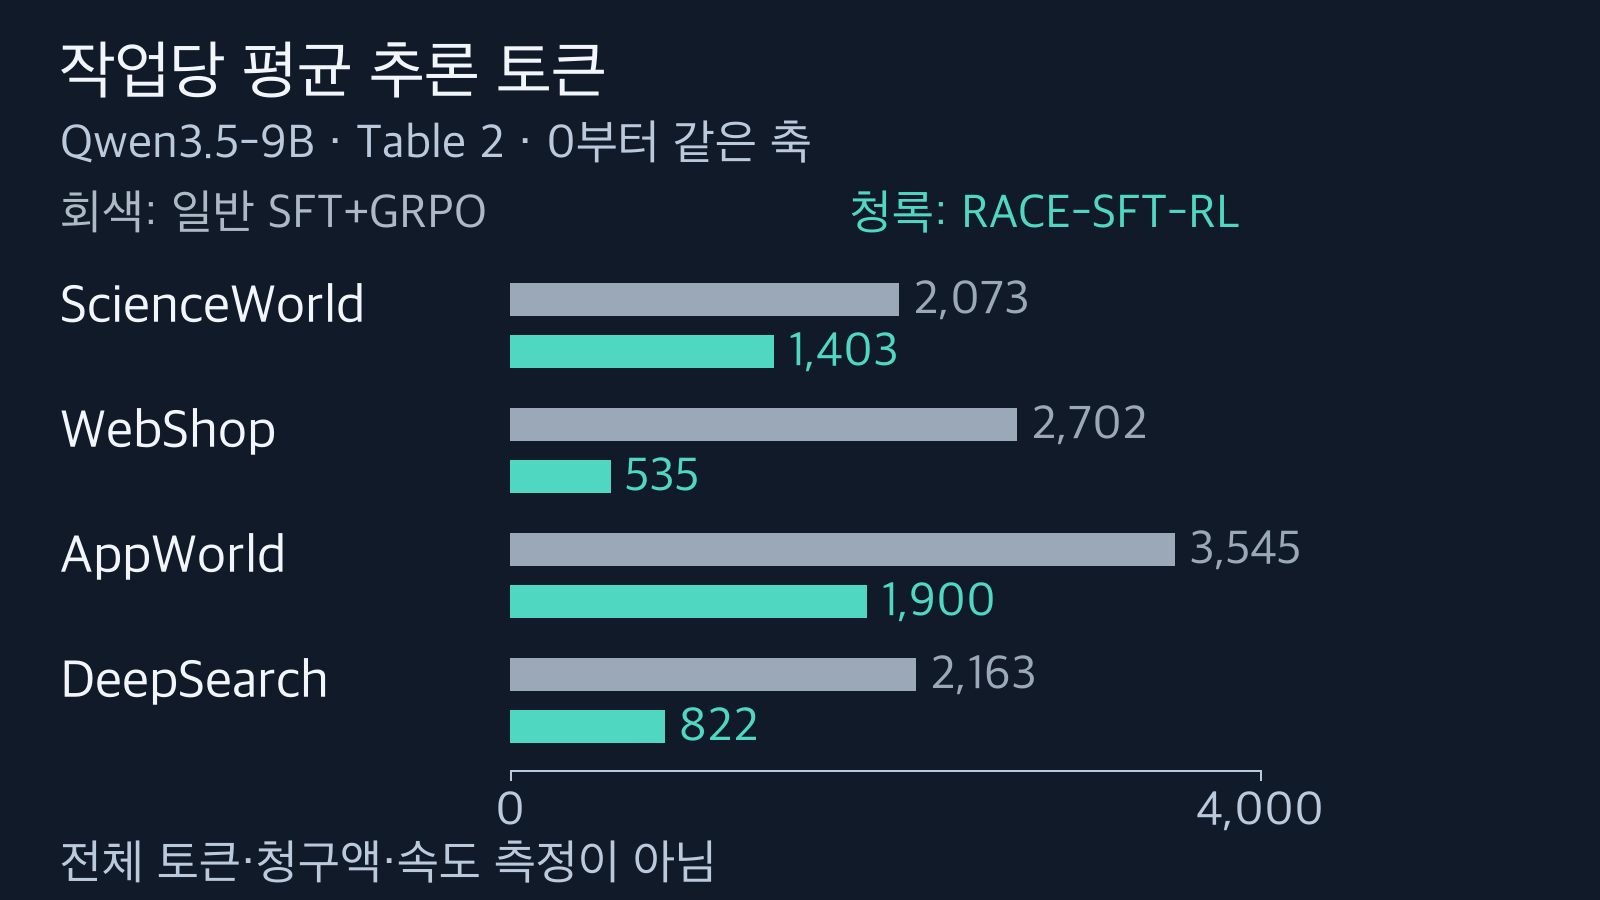
일반 SFT+GRPO 대비 RACE-SFT-RL의 작업당 평균 추론 토큰. 전체 입력·출력 토큰이나 비용 그래프가 아니다. 출처: arxiv.org/html/2610.12061v1.
여기서 기준 행을 RACE-SFT+GRPO로 바꾸면 해석도 달라진다. 그 행의 ScienceWorld 성공률은 75.54%, AppWorld는 67.18%다. RACE-SFT-RL의 73.28%, 65.13%와 비교한 차이는 각각 -2.26%p와 -2.05%p다. 따라서 “성공률 차이가 최대 1.40%p”라는 설명은 일반 SFT+GRPO 비교에만 해당한다. 다른 학습 행까지 포괄하는 성능 유지 선언으로 바꾸면 안 된다.
2. 성공률 옆에는 분모와 성공 기준을 놓는다
ScienceWorld는 공식 테스트 1,819개에서 최종 환경 점수가 100에 도달해야 성공이다. WebShop은 공식 테스트 지시 500개에서 환경 보상이 1이어야 한다. AppWorld는 Test-N 168개와 Test-C 417개, 합계 585개에 대해 상태 기반의 엄격한 작업 성공을 판정한다. DeepSearch는 여러 질의응답 데이터셋의 개발 세트에서 뽑은 400개 질문에 Exact Match를 적용한다. 서로 다른 성공 기준을 하나의 시험처럼 합치지 않는다. 출처는 Appendix A.1–A.4와 C.1이다.
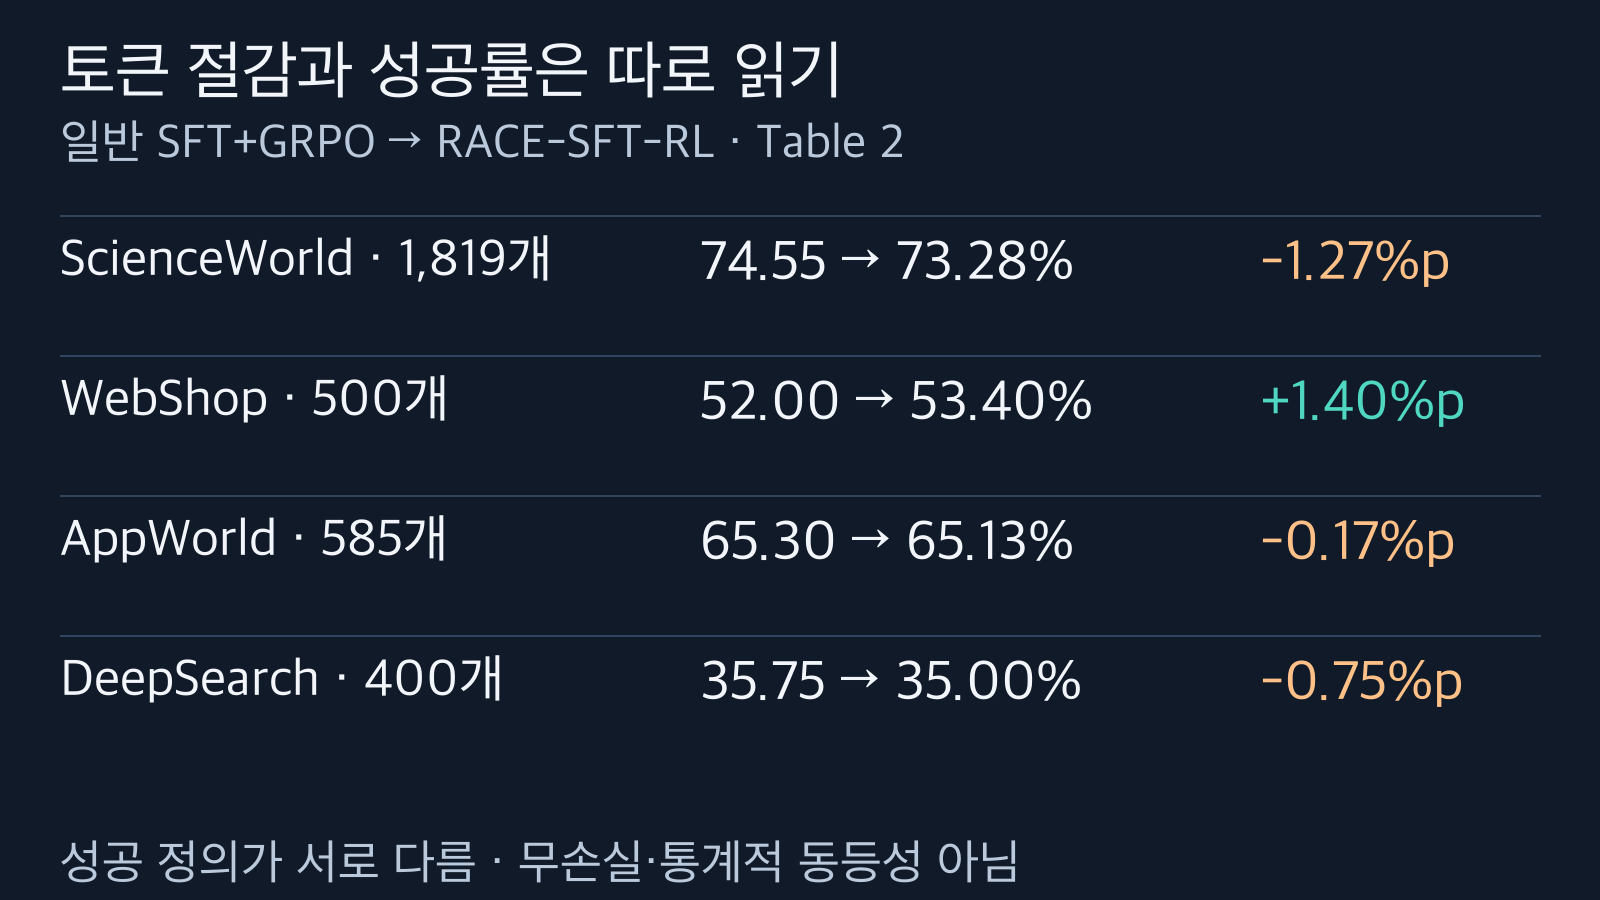
Table 2의 성공률 점추정과 Appendix A/C.1의 평가 분모. 서로 다른 성공 기준이며 무손실 검증이 아니다. 출처: arxiv.org/html/2610.12061v1.
검사한 평가 프로토콜에는 독립 시드 반복에 따른 신뢰구간이나 비열등성 검정이 제시되지 않았다. 차이가 작다는 사실만으로 통계적 동등성이나 무손실을 선언할 수 없다. 반올림된 성공률을 분모에 곱해 실제 성공 건수를 역산하지도 않는다. 원자료의 정확한 성공 건수는 확인하지 못했다.
Appendix C.1의 공통 조건은 최대 30턴, 모델 생성 한 번당 최대 65,536토큰, temperature와 top-p 1.0, 최대 문맥 262,144토큰이다. 이는 실제 작업이 모두 그 한도만큼 사용했다는 뜻이 아니다. AppWorld는 감사된 작업별 API 목록을 사용하고 한 턴에 여러 호출을 허용한다. 추론 생략과 실행 권한 축소는 별개의 문제다.
3. LoGiC는 미래를 아는 실행기가 아니라 학습 신호다
RACE의 중심인 LoGiC는 완성된 행동·관찰 궤적에서 추론 하나를 후보로 지운다. 고정된 참조 행동의 토큰별 평균 로그 가능도를 원래 문맥과 삭제 후 문맥에서 비교한다. 현재 행동 하나뿐 아니라 뒤의 참조 행동들에서도 감소가 임계값 이내일 때 삭제를 받아들인다. 첫 턴의 추론은 유지하고, 앞서 받아들인 삭제는 다음 검사에 누적한다. 이 절차는 §2.3, §3.1 및 Appendix E의 Algorithm 1에 있다.
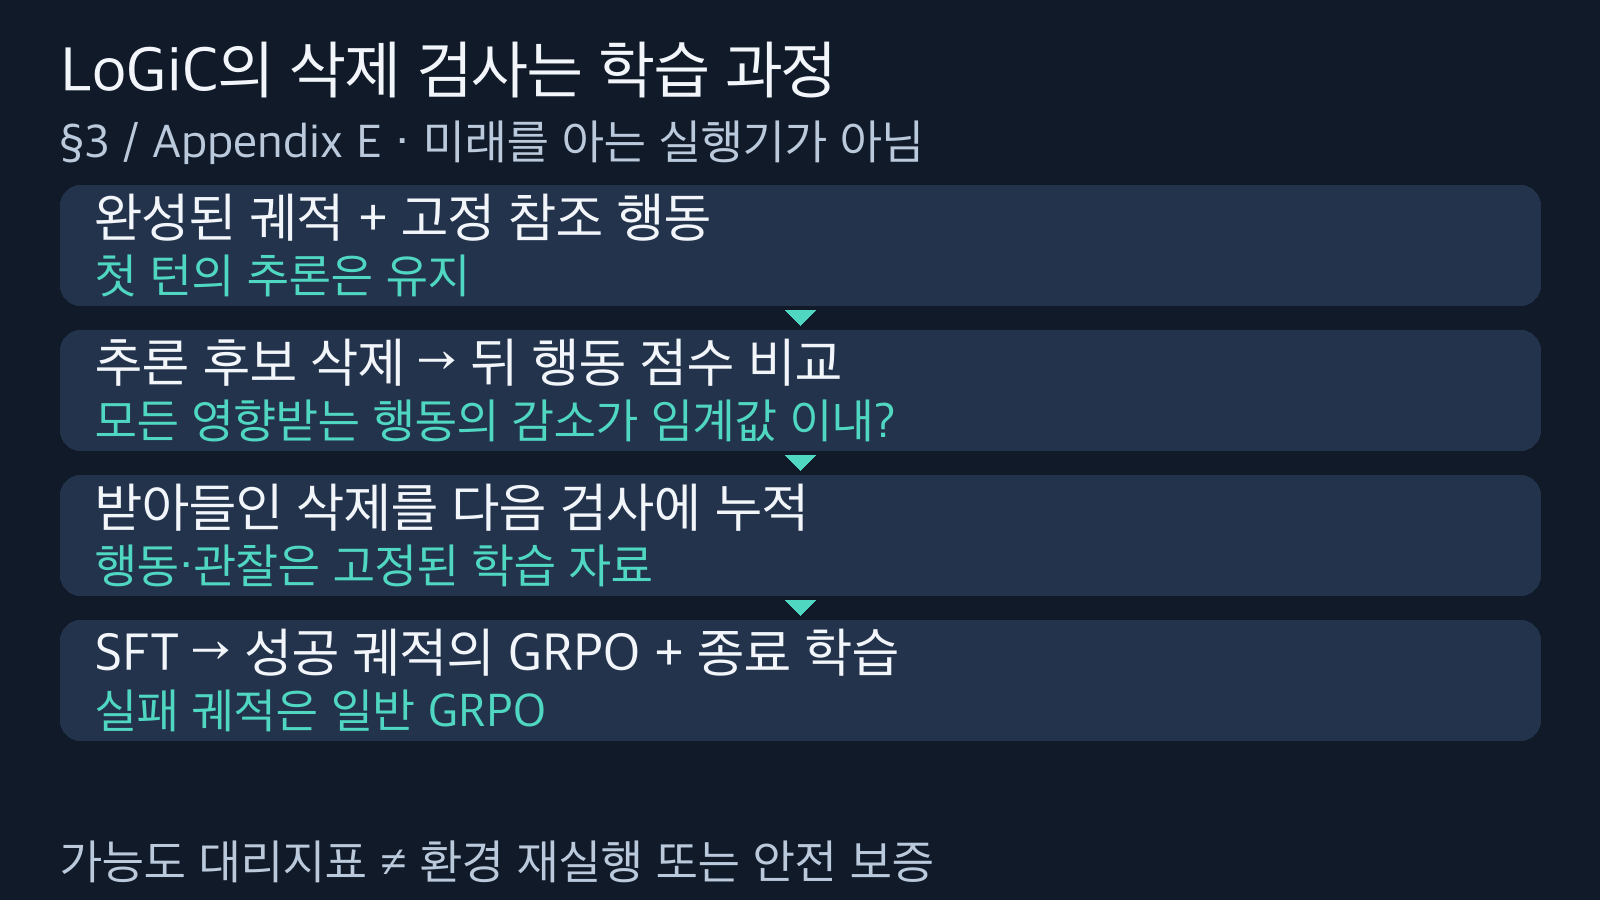
LoGiC는 고정된 학습 궤적에서 삭제 신호를 만든다. 미래 행동을 아는 실행기나 안전 보증이 아니다. 출처: arxiv.org/html/2610.12061v1.
중요한 구분은 뒤의 행동과 관찰이 이미 확보된 학습 자료라는 점이다. 운영 시점에 아직 벌어지지 않은 행동을 미리 알고 삭제를 판단하는 오라클이 아니다. 가능도 점수는 행동 지원을 추정하는 대리지표이며, 삭제된 궤적으로 환경을 다시 실행한 반사실 검증이나 안전 보증도 아니다.
삭제 신호로 만든 적응형 궤적을 지도 미세조정(SFT)에 사용한다. 이후 현재 정책이 만든 성공 궤적에 LoGiC를 적용해 강화학습(GRPO)의 불필요한 추론 토큰을 마스킹하고 추론 종료 토큰을 학습한다. 행동 토큰은 작업 최적화에 남기며, 실패 궤적에는 일반 GRPO를 적용한다. Appendix C.2는 가능도 감소 임계값 0.001, 강화학습 배치 16개와 인스턴스당 궤적 8개를 명시한다. 이 점수 계산과 추가 학습에는 자원이 들지만, 학습비까지 포함한 전체 손익분기점은 이 수치만으로 확정할 수 없다.
4. 어떤 턴을 건너뛰는지 사례로 읽는다
Appendix F.2의 쇼핑 사례에서 모델은 먼저 사용자 조건을 모아 검색한다. 제품 페이지와 설명으로 이동할 때에는 빈 추론 블록 뒤에 도구 호출이 이어진다. 그런데 설명에서 개별 포장 여부를 확인하지 못하자 다시 추론하고 특징 페이지를 확인한다. 이는 논문에 제시된 시뮬레이션 궤적의 요약이며, 이 글에서 실제 구매를 실행한 것이 아니다.
또한 Table 3에서는 RACE-SFT에서 RACE-SFT-RL로 바뀔 때 ScienceWorld의 생각하는 턴당 추론 토큰이 132에서 273으로, AppWorld는 273에서 302로 늘어난다. 건너뛰는 턴이 늘어도 남은 생각이 항상 짧아지는 것은 아니다. 이 비교는 앞의 일반 SFT+GRPO 기준과 다르다. 연구의 초점은 “모든 생각을 줄이기”보다 “언제 새 생각이 필요한지 학습하기”에 가깝다.
5. 도입 여부를 나누는 판단표
다음 표는 실험으로 검증한 배포 지침이 아니라, 원문 조건에 근거한 편집 분석이다. 준비된 도구처럼 소개하지 않고 지금 확인할 수 있는 것과 추가 검증이 필요한 것을 나눈다.
| 독자의 조건 | 지금 가능한 판단 | 다음에 필요한 근거 |
|---|---|---|
| 폐쇄형 API 호출만 가능 | 같은 방법을 즉시 적용한다고 말하지 않는다 | 학습 가중치와 참조 행동 점수 접근 가능 여부 |
| 모델 학습과 궤적 수집 가능 | 후보 학습 방법으로 검토한다 | 동일 환경의 일반 학습 기준, 성공 정의, 실패 분포 |
| 청구액이나 응답 속도 개선이 목표 | 추론 토큰 수치만으로 목표 달성을 선언하지 않는다 | 전체 입력·출력 토큰, 실측 지연, 과금 체계, 학습비 |
| 결제·메일·데이터 변경을 자동 실행 | SKIP을 검증·승인 생략으로 바꾸지 않는다 | 행동별 권한, 되돌리기, 상태 검증과 오류 대응 |
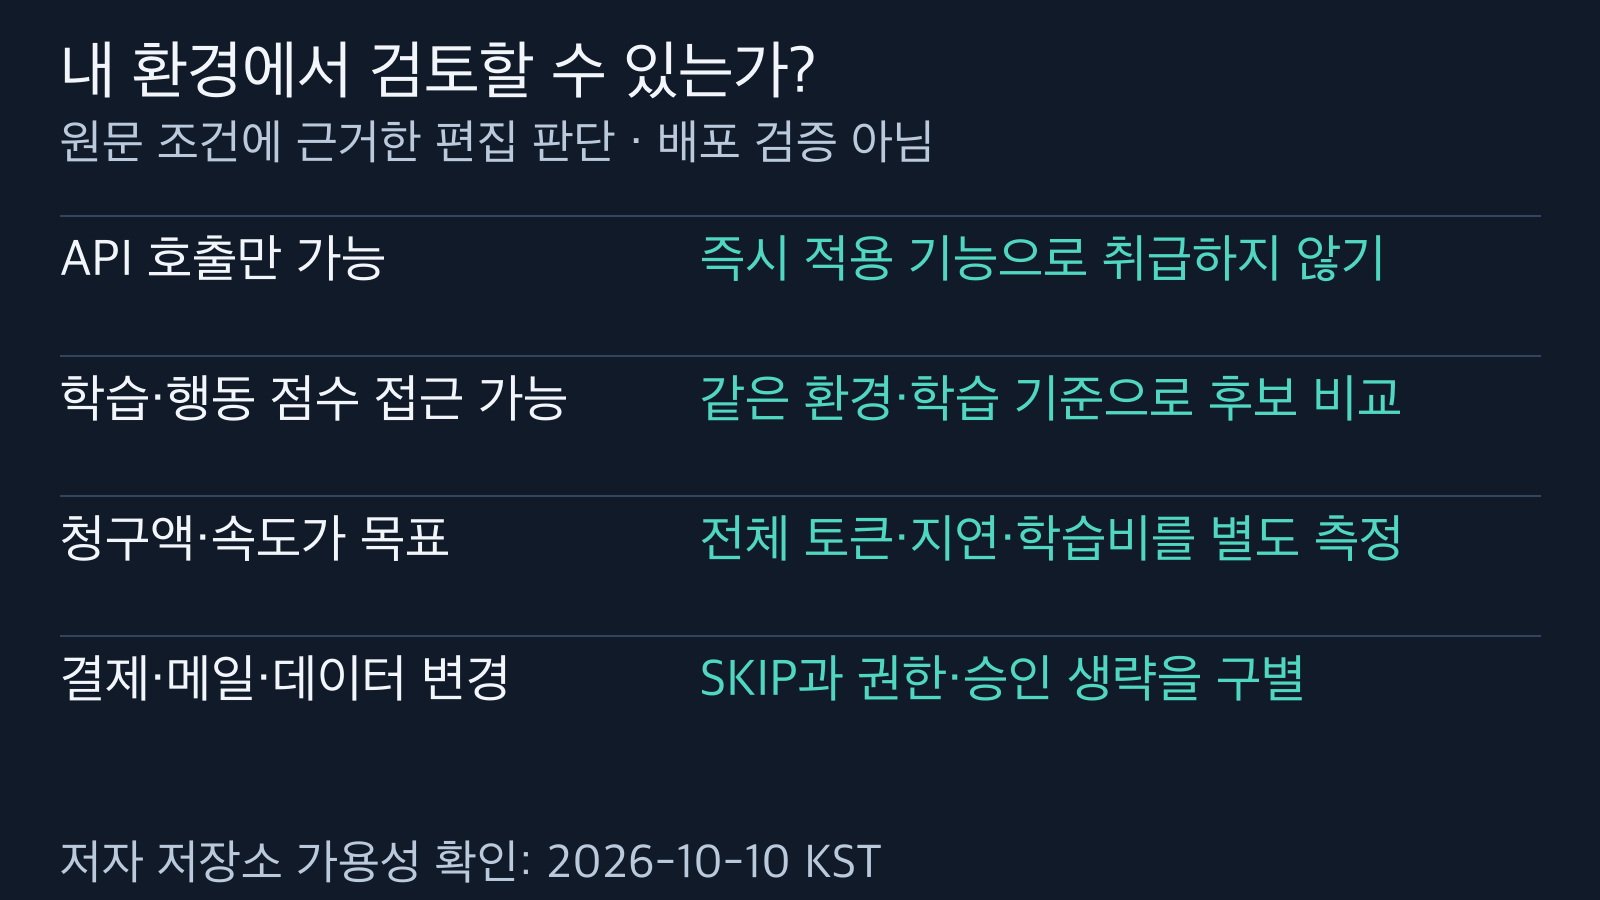
원문 조건에 근거한 편집 분석. 실제 배포·과금·권한 안전성을 검증한 결과가 아니다. 출처: arxiv.org/html/2610.12061v1.
추론 토큰 감소는 전체 토큰, API 청구액, 지연 시간 또는 에너지의 같은 비율 감소를 뜻하지 않는다. 특히 위험한 행동에 대한 승인이나 결과 확인은 별도로 유지해야 한다. 이는 논문의 안전성 실험 결과가 아니라 적용 범위를 넘지 않기 위한 편집 판단이다.
2026년 10월 10일 15시 07분 KST에 수집된 저자 저장소 증거에서는 size가 0이고 라이선스 항목은 null이며, 커밋 API는 빈 저장소에 대한 409 응답을 반환했다. 이 확인 시점에는 실행 코드·체크포인트·원시 결과·사용 라이선스를 독립적으로 검사하지 못했다. 영구적으로 비공개라거나 앞으로도 없다는 뜻은 아니다. 다운로드·설치 성공을 검증한 연구 도구로 소개하지 않는다.
결론적으로 RACE를 읽을 때 가장 유용한 질문은 “추론을 얼마나 줄였나?” 하나가 아니다. “어떤 학습 기준과 비교했나, 성공을 무엇으로 판정했나, 내 환경에서도 추가 학습과 행동 검증이 가능한가?”까지 묶어야 한다. 제한된 환경의 점추정은 연구 후보를 고르는 근거이지, 다른 모델이나 실서비스·보안 중요 업무의 성능 보증은 아니다.
출처와 검증 범위
- Cheng 외, When Should Agents Think? Adaptive Reasoning via Cross-Turn Estimation, arXiv:2610.12061v1. 2026년 10월 8일 제출된 프리프린트이며 동료심사 통과는 확인하지 않았다.
- 원문: https://arxiv.org/html/2610.12061v1 — §2.3/§3, Table 2–3, Appendix A/C/E/F.
- 서지 기록: https://arxiv.org/abs/2610.12061v1
- 저자 연결 저장소: https://github.com/HututuAI/RACE — 가용성 설명은 위 확인 시점의 보존 응답에 한정한다.
이 글은 고정된 원문 증거를 읽고 수치와 적용 범위를 대조한 분석이다. 모델 학습·독립 재현·실서비스 비용 측정은 수행하지 않았다. 본문의 그래프와 절차도는 발표값과 방법을 자체 도식화한 것이며 저자의 원본 그림이나 제품 화면을 복제하지 않았다.


댓글
댓글 쓰기