증명을 통과했는데 다른 문제를 풀었다면: SemantEq로 명제와 증명을 따로 감사하기
AI가 수학 문제를 Lean 명제로 옮기고 증명까지 완성했다. 컴파일도 성공했다. 이제 원래 문제를 제대로 풀었다고 표시해도 될까? 그 전에 확인할 것이 있다. 증명한 명제가 처음 요청한 명제와 같은지를 증명 검사기가 대신 보장해 주지는 않는다.
SemantEq 논문의 도입 예시는 이 차이를 선명하게 보여 준다. Nat.Prime 5는 “5는 소수다”, Irrational (Real.sqrt 2)는 “2의 제곱근은 무리수다”라는 서로 다른 주장이다. Mathlib에서 각각 증명할 수 있으면, 앞의 명제를 가정하고 뒤를 따로 증명하거나 그 반대로 해도 양방향 함의가 성립한다. 논리적 동치는 맞지만, 한 문제를 다른 문제로 번역해도 된다는 뜻은 아니다. Lean 커널이 틀린 증명을 받아들였다는 이야기와도 다르다. 논문 서론
이 글은 2026년 10월 23일자 arXiv v1 프리프린트와 저자 저장소의 고정 커밋을 읽고, 명제 수용 결정을 나누는 방법을 분석한다. 동료 심사를 거친 최종 결과로 소개하지 않는다. 아래 실험 수치는 논문 및 저자가 저장한 기록의 보고값이며, 여기서 새로 Lean을 실행하거나 모델을 평가한 결과가 아니다.
1. 서로 참인 두 문장이 같은 문제는 아니다
양방향 함의 검사는 보통 유용하다. 기준 명제가 후보 명제를 함의하고 후보도 기준을 함의하면 대응 관계를 확인할 수 있기 때문이다. 그러나 두 결론을 라이브러리에서 각각 가져올 수 있을 때에는 전제가 아무 일도 하지 않아도 검사가 통과한다. 증명 능력이 강해질수록 이런 우회로를 더 잘 찾을 수 있다는 것이 논문의 문제의식이다.
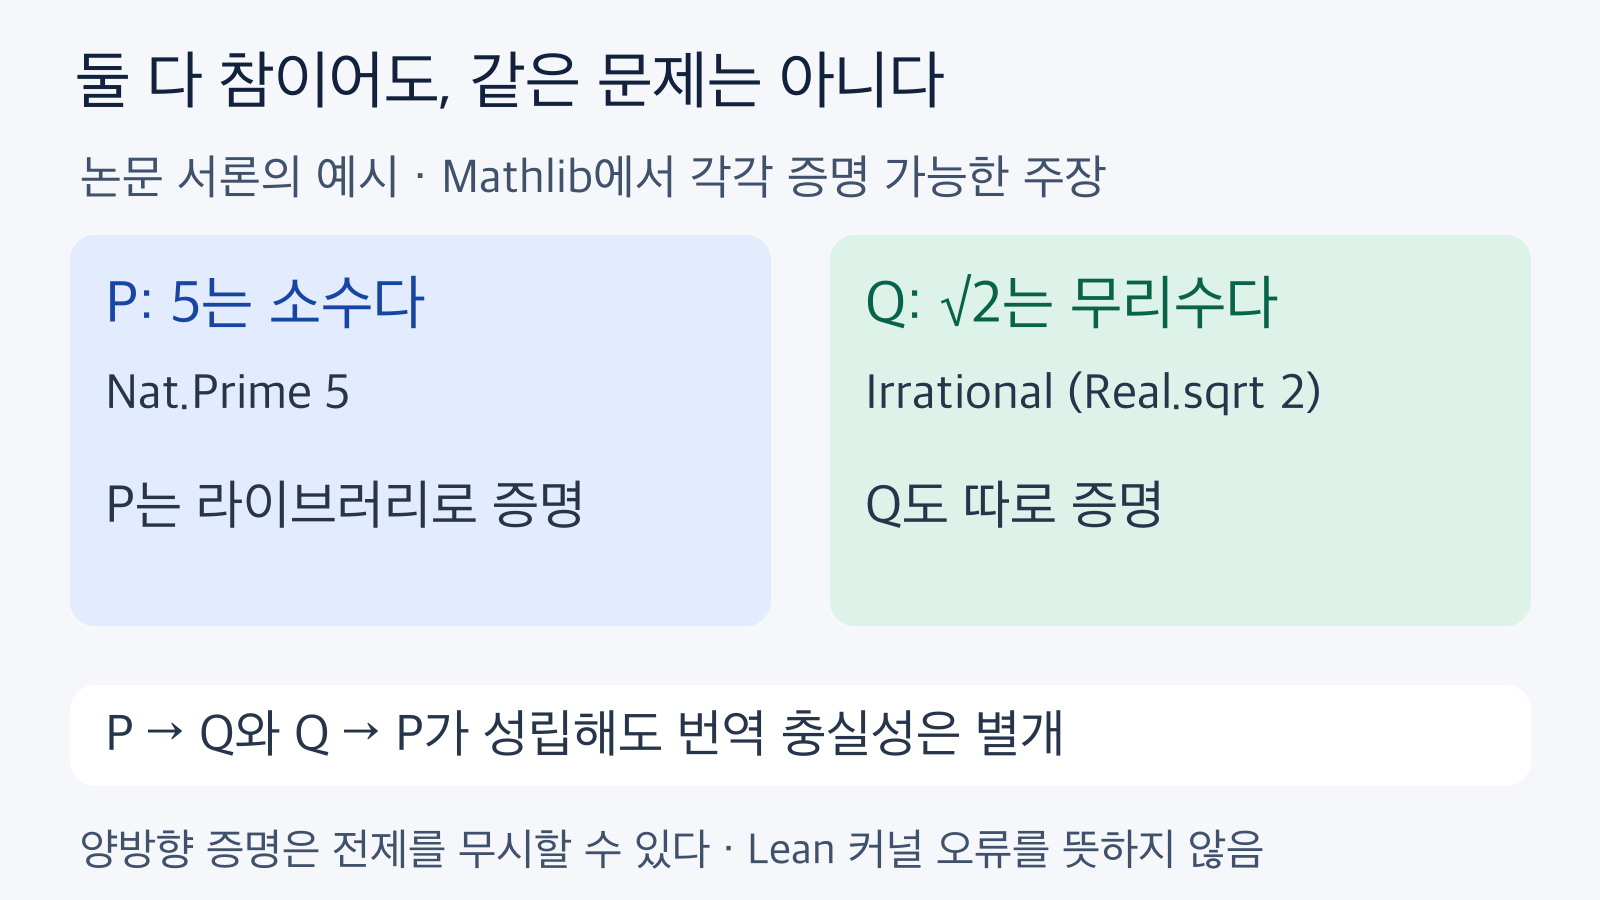
서론의 실제 예시를 새로 그렸다. 각각 참인 두 주장의 양방향 함의는 문제 번역의 충실성을 보장하지 않는다. Lean 실행 화면이 아니다. 출처: arxiv.org/html/2610.32919v1.
따라서 “증명 코드에 기준 정리의 이름이 들어간다”도 충분한 조건이 아니다. 이름을 한 번 언급한 뒤 쓰지 않을 수 있고, 중간에 값을 꺼냈지만 결론에는 기여하지 않을 수도 있다. 논문 부록 E는 전술 스크립트의 이름 검색과 실제 증명항에서의 의존성을 구분한다. 검토 대상은 증명을 작성한 설명이 아니라 Lean이 검사하는 증명항이다.
여기서 전제는 두 종류로 구분하면 편하다. 문제 자체가 주는 가정이 있고, 한 방향의 대응 증명에서 가정한 ‘반대편 명제’가 있다. 논문이 그 명제를 실제로 사용했는지 묻는 것은 후자의 의미다. 단지 원래 문제의 가정이 본문 어딘가에 등장했는지를 세는 검사가 아니다.
2. Eval은 길을 찾고, ProofAudit은 가져온 증명을 심사한다
SemantEq는 논리적 재배열, 라이브러리의 등식·동치에 따른 다시 쓰기, 변수 변경, 구조적 약화라는 네 종류의 허용 단계를 정의한다. 한 방향의 약화나 특수화는 역으로 되돌릴 수 있다는 보장이 없으므로 양방향의 사슬이 각각 필요하다. 라이브러리 정리가 결론을 통째로 공급하는 것과, 같은 내용을 다른 표현으로 옮기는 다리 역할을 하는 것을 구별하려는 설계다. §2 정의 1·2
SemantEq-Eval은 모델 없이 제한된 변환을 탐색한다. 찾은 증명은 관련성 검사, 증명항 분류, 모순으로부터 결론을 닫는 경로의 검사, 반대편 명제를 빼고 다시 시도하는 검사 등을 거친다. 반면 SemantEq-ProofAudit은 모델이나 다른 증명기가 이미 작성한 증명항을 감사한다. 생성 능력을 높이는 일과 어떤 증명을 수용할지 정하는 일을 분리한다.
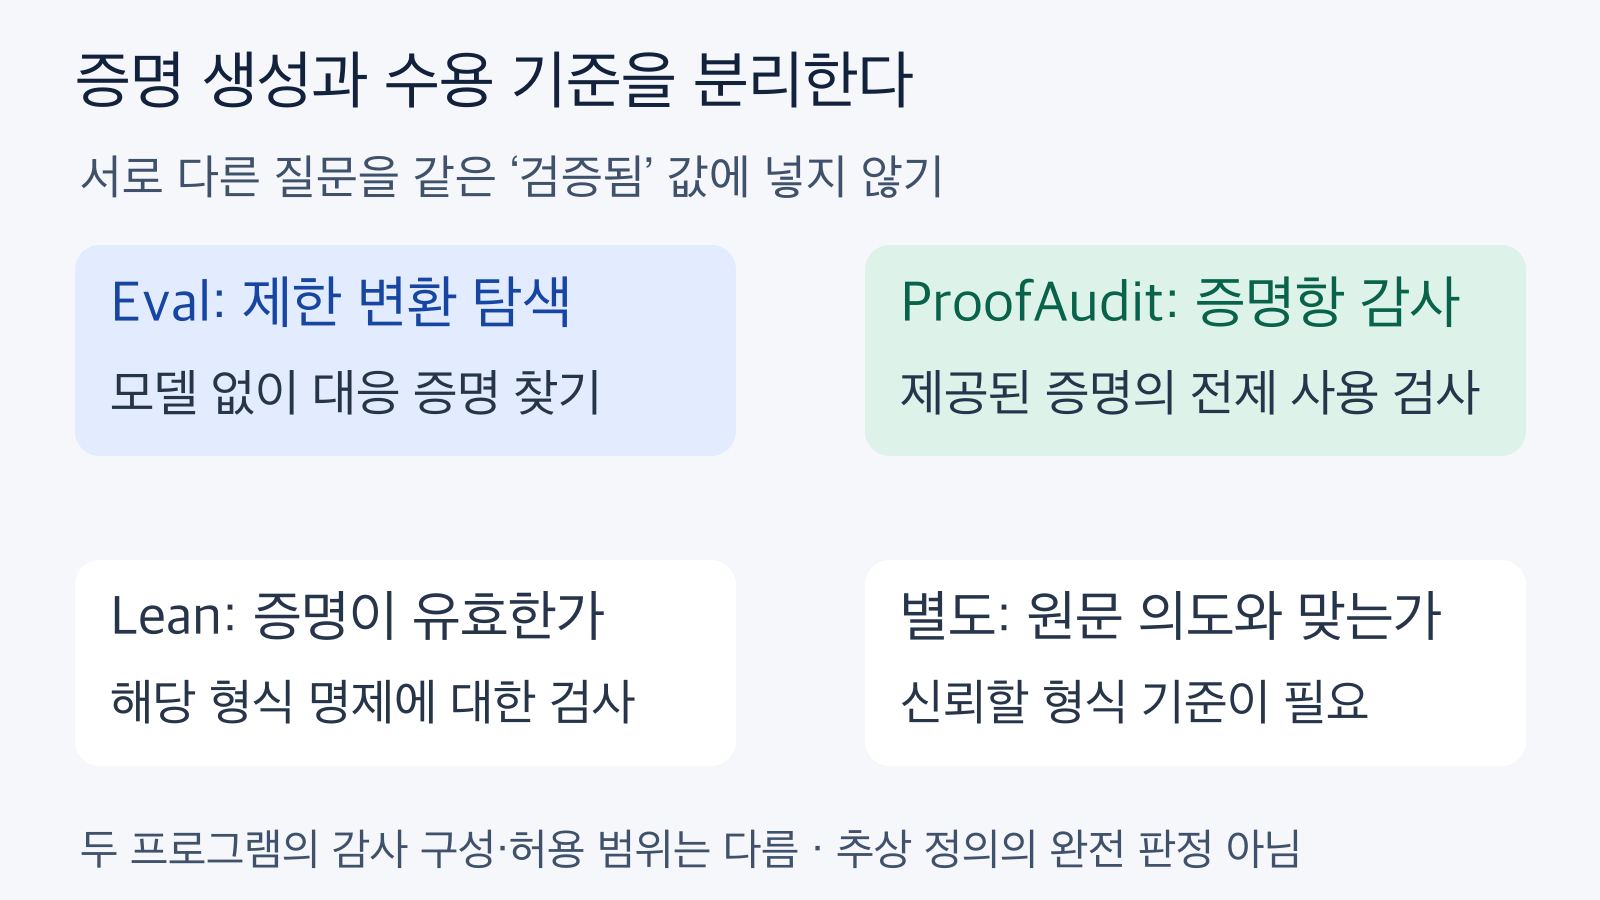
논문 §§2.2·4.1의 역할을 분리했다. 두 도구의 검사 구성과 허용 범위는 다르며, 수용은 자연어 의미의 완전한 보증이 아니다. 출처: arxiv.org/html/2610.32919v1.
다만 두 프로그램을 동일한 검사기의 다른 호출 방식으로 생각하면 안 된다. ProofAudit에는 최종 증명항에서 반대편 명제를 어떤 대상에 적용했는지 확인하는 검사가 있고, Eval의 사전 관련성 검사와는 차이가 있다. 또 감사 정책은 추상적 정의를 그대로 완전 판정하는 알고리즘이 아니다. 다시 쓰기의 정당화나 반대편 명제의 가정을 채우는 위치에서 라이브러리 사실을 허용하는 범위가 있으며, 더 엄격한 모드는 일부 허용을 실패로 바꾼다. 수용 결과와 함께 정책·경고를 남겨야 하는 이유다. §4.1, 부록 G
3. 65.6%를 읽기 전에 분모를 고정한다
표 1은 전체 테스트 1,452쌍 가운데 해당 도구 체인에서 정교화되는 1,303쌍을 채점한다. 제외된 149쌍을 성공이나 실패에 임의로 더해서는 안 된다. 저자 재판정 라벨 기준 SemantEq-Eval의 TP/FP/FN/TN은 242/0/127/934다. 정밀도는 수용한 242쌍 중 맞은 242쌍으로 100%, 재현율은 동등한 369쌍 중 찾은 242쌍으로 65.6%다. 같은 도구 체인으로 옮긴 BEq+는 228/10/141/924, 정밀도 95.8%, 재현율 61.8%다.
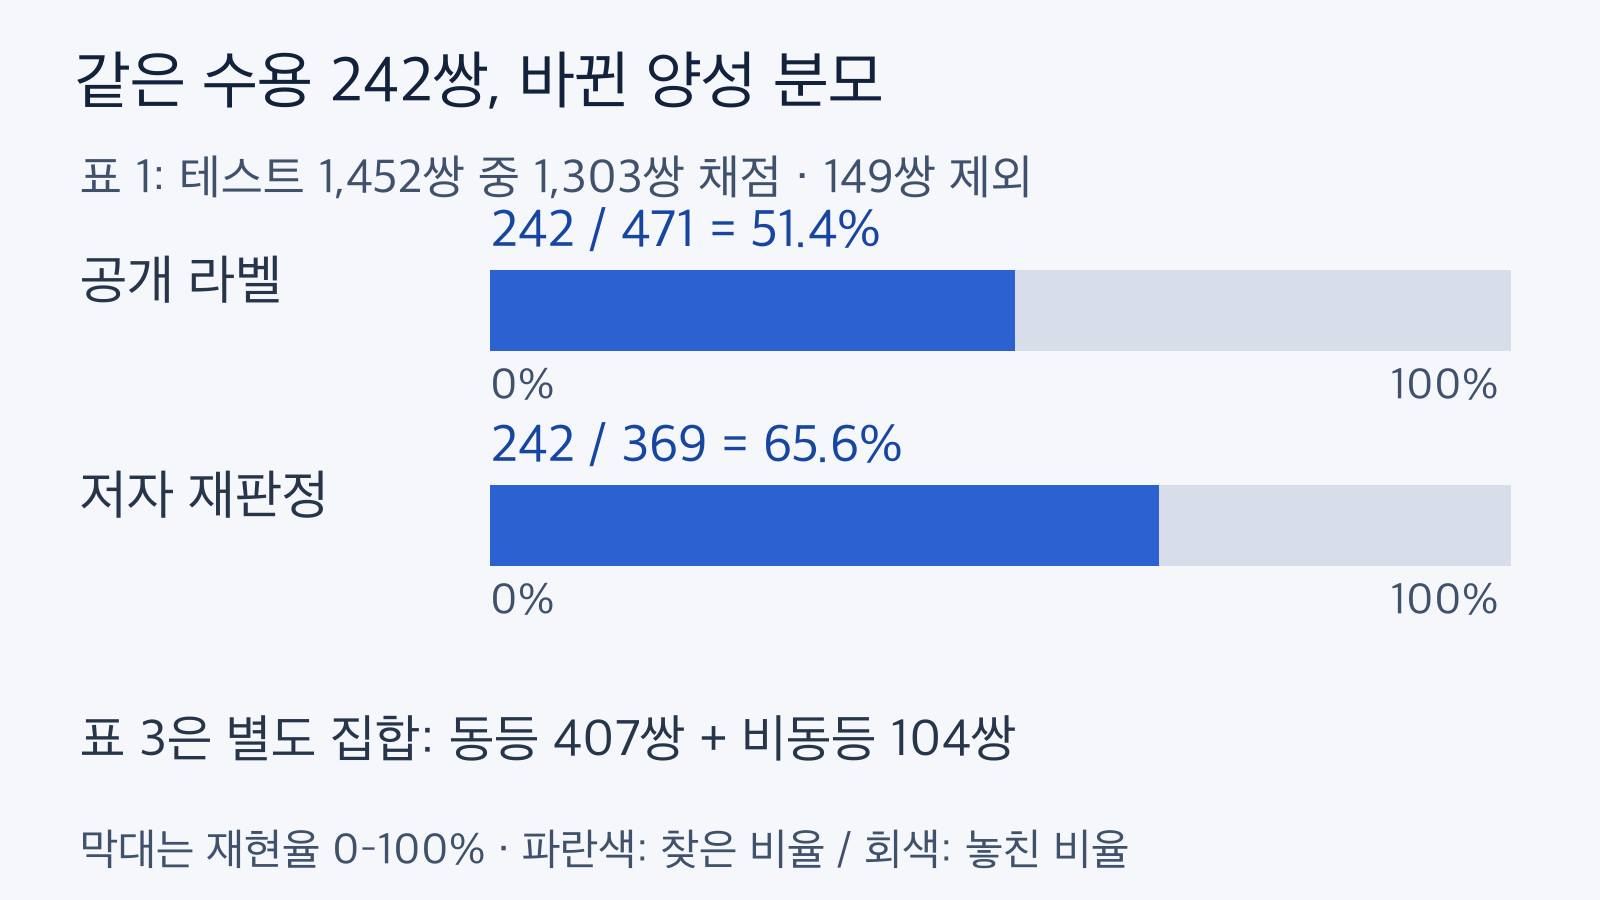
표 1의 보고값으로 그린 0–100% 재현율 막대다. 수용 수가 늘어난 것이 아니라 라벨과 양성 분모가 바뀌었다. 표 3의 분모와도 구분해야 한다. 출처: arxiv.org/html/2610.32919v1.
원래 공개 라벨로 보면 같은 SemantEq-Eval 수용 결과의 재현율은 242/471, 즉 51.4%다. 51.4%에서 65.6%로 달라진 것을 추가 학습이나 재실행의 성능 향상으로 읽으면 안 된다. 라벨과 양성 분모가 바뀐 것이다. 저자는 원래 동등하다고 라벨링된 테스트 쌍을 검토해 102개를 비동등으로 바꿨다. 이 중 88개는 자기 평가기·감사기의 결과가 검토 계기였고, 원래 비동등 라벨은 재검토하지 않았다. 적어도 8개 변경은 단순 오기 정정보다 평가 기준의 차이를 반영한다. 사람의 최종 판정이 있었다고 해서 독립·맹검 전수 재라벨링이 되는 것은 아니다. 표 1, §3, 부록 H
표 3의 인증 집합은 또 다르다. 총 511쌍 중 동등한 407쌍과 비동등한 104쌍이며, 407은 테스트의 369쌍에 별도 재현율 평가 모음의 38쌍을 더한 값이다. faithful 프롬프트의 ProofAudit 양방향 인증은 330/407, 81.1%이고 모델 없는 기본 탐색은 266/407, 65.4%다. 차이는 64쌍, 약 15.7%포인트다. 엄격한 감사 모드에서는 faithful의 양방향 인증이 323/407로 줄어든다. 표 1의 65.6%와 표 3의 81.1%를 같은 분모의 상승 폭으로 연결해서는 안 된다.
비동등 104쌍에서 양방향으로 컴파일되는 증명은 expedient 조건 43쌍, unrestricted 조건 45쌍으로 논문에 보고됐다. 서로 다른 프롬프트 조건이므로 합쳐서 ‘88개 오류’라고 세면 안 된다. ProofAudit의 양방향 인증은 각 조건에서 0쌍이지만, 한 방향만 인증된 사례는 있다. ‘0’은 모든 방향에서 모든 함의를 거부했다는 뜻도, 일반 환경의 오수용 확률이 0이라는 뜻도 아니다. 표 3, §4.2
4. 수용 기록을 나누는 판단표
실제 도입에서 얻을 수 있는 효용은 ‘검증됨’ 표시 하나를 늘리는 것이 아니라, 서로 다른 질문을 같은 성공 값에 넣지 않는 데 있다. 다음은 논문의 구분을 바탕으로 작성한 판단표다.
컴파일 성공은 증명 유효성 칸에만 기록하고, 명제 충실성 칸을 자동으로 채우지 않는다.
| 관찰한 결과 | 기록해도 되는 것 | 별도로 남겨야 하는 질문·조치 |
|---|---|---|
| 후보 명제와 증명이 Lean 검사를 통과 | 그 형식 명제에 대한 증명 유효성 | 대상·가정·결론이 원래 문제에서 바뀌었는지 확인 |
| 양방향 함의가 컴파일 | 해당 함의의 논리적 성립 | 반대편 명제가 실제로 일했는지, 라이브러리가 결론을 대신 줬는지 감사 |
| Eval이 쌍을 수용 | 고정 도구 체인과 제한 탐색 정책에서 대응 증거를 찾음 | 기준 명제의 신뢰성, 사용한 라이브러리·정책·예외를 별도 보관 |
| ProofAudit이 두 방향 인증 | 제공된 두 증명항이 해당 감사 정책을 통과 | 경고·허용 사실 및 엄격 모드에서 달라지는 결과를 확인 |
| 한 방향만 인증 또는 탐색 실패 | 현재 절차로 양방향 수용 증거가 부족 | 즉시 ‘오역 확정’으로 바꾸지 말고 적용 대상·시간 제한·변환 범위 진단 |
| 자연어 원문과 기준 명제가 어긋남 | 기준 자체의 검토가 필요 | 기준을 그대로 복사한 후보도 통과할 수 있으므로 원문 검토로 되돌림 |
이 판단표는 논문을 바탕으로 작성한 운영 제안이며, Lean 실행이나 새 모델 실험으로 검증한 절차가 아니다.
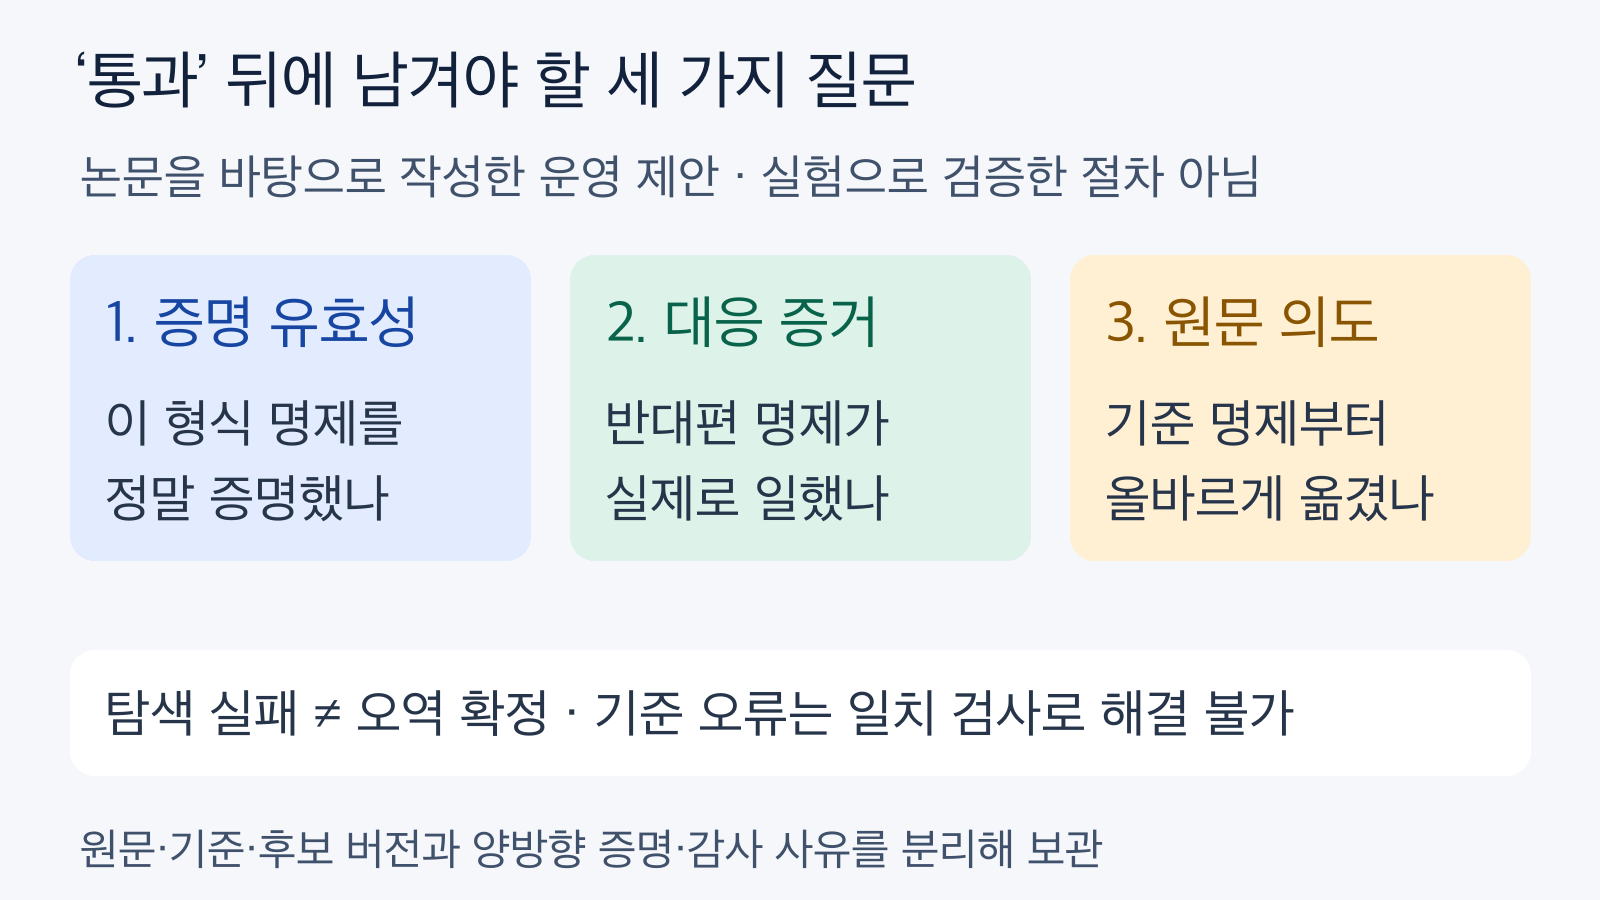
본문 판단표를 시각화한 편집상 제안이다. 컴파일 성공만으로 뒤의 두 질문을 자동 승인하지 않고, 실패만으로 오역을 확정하지 않는다. 출처: arxiv.org/html/2610.32919v1.
예를 들어 후보가 원래 없던 가정을 추가했다면 ‘더 쉬워진 문제를 증명했는가’를 먼저 본다. 동등 판정을 얻기 위해 기준 문장을 후보에 맞춰 조용히 고치는 방식은 대응 검사를 무의미하게 만든다. 원문·기준·후보의 버전을 고정하고 양방향 증명과 실패 사유를 보존해야, 증명 개선인지 문제 변경인지 나중에도 구분할 수 있다. 이 보관 방식은 이 글의 편집상 제안이지 논문이 측정한 운영 성과는 아니다.
5. 지금 도입할 때의 비용과 남는 경계
고정 저장소의 기본 CLI는 쌍당 벽시계 제한이 20초지만, 논문과 재현 스크립트는 --timeout 0을 사용한다. 기본 명령만 실행하고 논문의 전체 재현율이 그대로 나올 것이라 기대하면 안 된다. 원래 벤치마크 문장도 별도로 가져와야 한다. BEq+ 호환 포트는 공개 저장소에 포함되지 않아 공개 재현 절차의 해당 표 행은 저장된 기록에서 복사한다. 공개 스크립트가 있다는 사실과 모든 비교기를 독립 재실행할 수 있다는 사실은 다르다. 고정 README의 Usage·Released data
권리 범위도 분리한다. 코드는 Apache-2.0이지만, 외부 벤치마크에서 온 명제는 원출처 라이선스를 따른다. 저자 라벨·선별 쌍·사례 연구에는 아직 별도 라이선스가 없다고 README에 적혀 있다. 코드 라이선스만 보고 데이터 전체의 상업적 재사용까지 일괄 승인됐다고 해석할 수 없다.
성능 수치에도 세 가지 경계가 남는다. 첫째, 표 1에 오수용이 관측되지 않았어도 부록 F에는 채점하지 않은 validation 분할의 Munkres 18.8b를 Eval이 잘못 수용한 알려진 사례가 있다. ProofAudit의 인스턴스화 검사는 같은 증명항을 거부하므로 두 도구의 한계를 뒤섞어서도 안 된다. 둘째, 모델 캠페인은 2026년 8월 30일 gpt-5.6-sol medium을 사용한 쌍·프롬프트당 한 세션 실험이다. 생성은 Lean 4.28.1/Mathlib 1f9fffd5, 감사는 Lean 4.30.0-rc1/Mathlib 0c154d67에서 이뤄졌다. 10월 26일 새로 측정한 최신 모델 성능이 아니다. 셋째, 신뢰할 수 있는 형식 기준이 필요하다. 기준과 일치하는 결과를 얻어도 그 기준이 자연어 의도를 올바르게 옮겼는지는 남는다. 부록 F·H·K
SemantEq의 실용적 메시지는 ‘증명 검사는 쓸모없다’가 아니다. 증명 검사가 답하는 질문을 존중하면서, 다른 질문에 그 성공을 재사용하지 말자는 것이다. 형식 명제에 대한 증명, 반대편 명제를 사용한 대응 증거, 자연어 원문의 의도라는 세 층을 구별하면 더 강한 증명기를 쓰더라도 무엇을 수용했는지 설명할 수 있다.
함께 읽을 글과 원문
관련 글은 하나만 연결한다. 코딩 에이전트의 87% 통과가 저장소 완성을 뜻하지 않는 이유는 Vero의 고정 명세와 저장소 완료를 다룬다. 여기서 다룬 것은 그보다 앞단인 ‘형식 명제가 다른 문제로 바뀌었는가’다. 같은 형식 검증 주제라도 실패 위치가 다르며, 관련성이 낮은 글로 링크 수를 채우지는 않았다.
- 논문 v1: SemantEq: Faithful Bidirectional Equivalence of Formal Statements — 서론, §§2–4, 표 1·3, 부록 F·G·H·K.
- 저자 구현: SemantEq 고정 커밋 f927670 — Usage, Released data, License 및 ProofAudit 규칙.
AI를 활용해 작성·편집한 글입니다. 원문 주장, 저자 저장 기록, 편집상 판단을 구분했으며 독립적인 Lean 재현이나 모델 추론을 수행하지 않았습니다.


댓글
댓글 쓰기