SimpleB2T: 뇌 신호를 지워도 남는 성능, 시간 지름길을 검증하는 법
뇌 활동으로 문장을 복원하는 모델이 좋아졌다는 소식을 읽을 때, 먼저 물어야 할 질문은 모델 크기가 아니다. 뇌 신호를 없애고 입력의 시간 구조만 남겨도 같은 이득이 생기는가? 단어 시작 시각에 맞춰 자른 신호를 여러 개 함께 처리하면, 정답 단어를 직접 넣지 않아도 서로 겹치는 구간이 단어 길이의 단서가 될 수 있다.
Dulhan Jayalath와 Oiwi Parker Jones의 프리프린트 「Removing Timing Shortcuts Improves Non-Invasive Brain-to-Text」는 이 문제를 합성 신호 대조군으로 드러낸다. 이 글은 그 결과를 임상 성과나 마음 읽기 기술로 소개하지 않는다. 시간 정렬된 데이터를 다루는 개발자가 신호 정보와 입력 제작 규칙의 효과를 분리하는 평가 설계를 가져갈 수 있도록 정리한다. 원문은 2026년 9월 30일 제출된 arXiv v1이며, 동료 심사를 통과한 논문이라는 사실은 별도로 확인하지 않았다.
1. 겹치는 창이 어떻게 정답의 힌트가 되는가
논문이 검토한 설정에서는 사람이 말을 듣거나 글을 읽을 때 기록된 비침습적 뇌 활동을 사용한다. 각 단어의 시작 시각은 이미 알려져 있다. 모델 입력은 해당 시각부터 시작하는 3초짜리 창이다. 자연스러운 말에서는 다음 단어가 3초보다 빨리 시작하므로 인접한 두 창에 동일한 샘플이 다른 상대 위치로 들어간다.
두 창에서 같은 패턴이 얼마나 밀려 있는지 찾으면 단어 시작 시각 사이의 간격을 추정할 수 있다. 그 간격은 단어의 발화 길이와 관련된다. 단어마다 흔한 길이가 다르므로, 문장 전체의 창을 함께 인코딩하는 모델은 뇌 활동의 의미를 충분히 해독하지 않고도 후보 단어를 좁힐 수 있다. 여기서 누설은 훈련 데이터에 테스트 정답을 복사했다는 뜻이 아니다. 입력 정렬 과정이 라벨과 상관된 별도의 정보 통로를 만든다는 뜻이다.
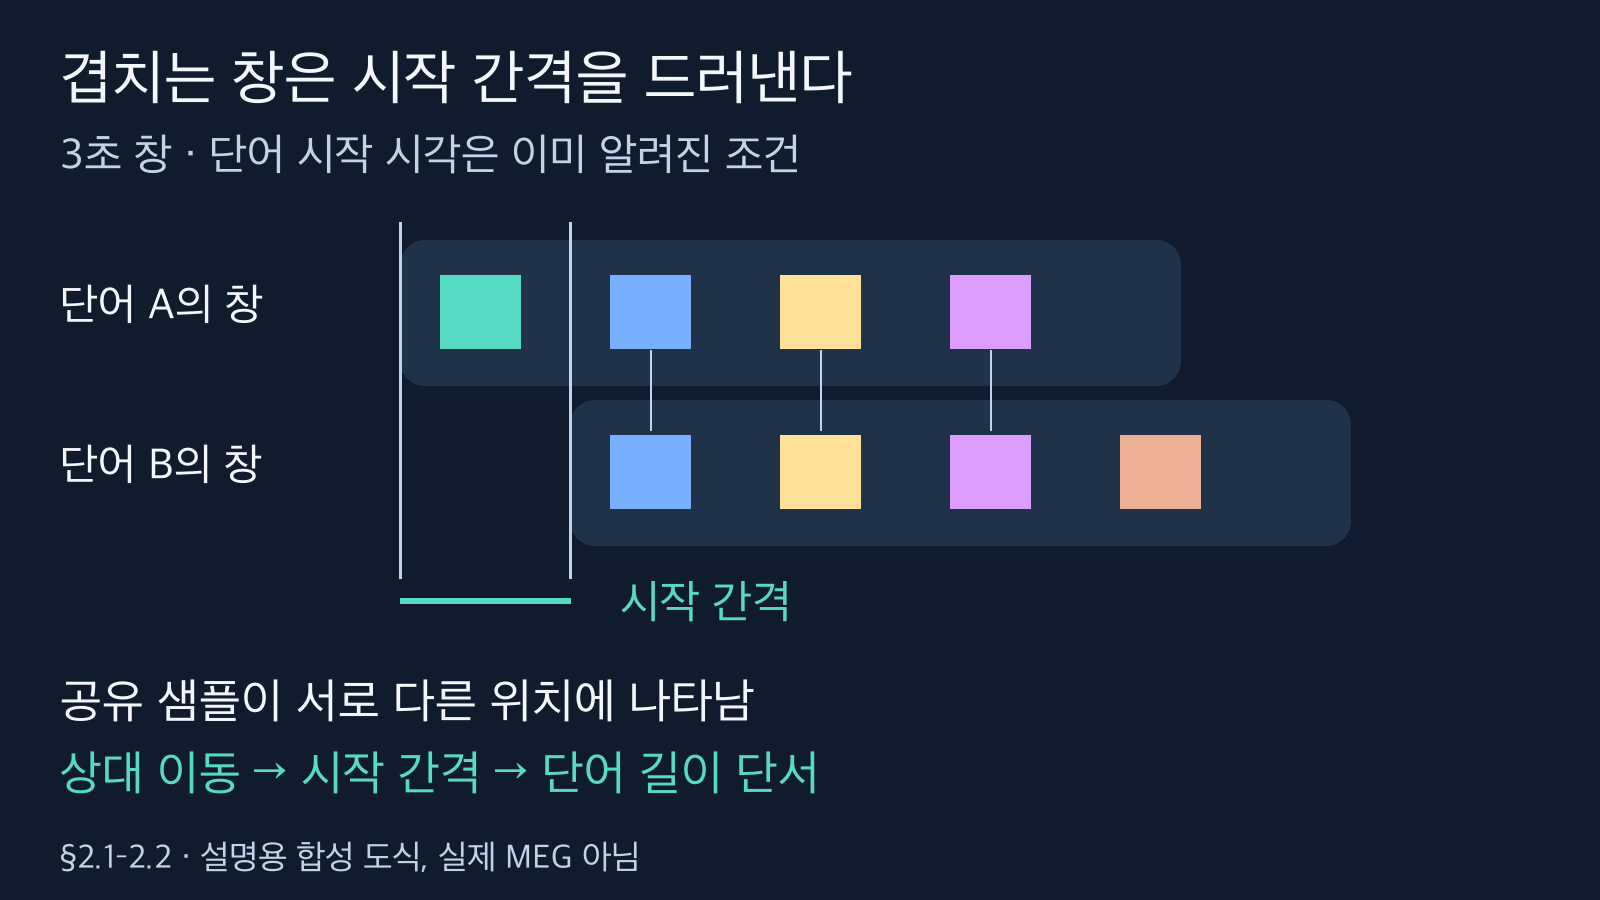
공유 샘플의 상대 이동은 시작 간격을 드러낸다. 설명용 합성 도식이며 실제 MEG가 아니다. 출처: arxiv.org/html/2609.40359v1.
이 그림의 시작 간격과 블록은 설명용 도식이지 실제 뇌파 기록이 아니다. 중요한 점은 합성 신호라도 같은 연속 신호에서 실제 시작 시각에 맞춰 창을 뽑으면 공유 샘플의 상대 이동이 보존된다는 것이다. 창 길이를 줄이거나 단어 경계에서 마스킹하는 방법도 경계 위치를 노출할 수 있다. 따라서 마스크를 넣었다는 사실만으로 시간 단서가 제거되었다고 판단하면 안 된다. 원문 §2.1–2.3, 부록 A.2
2. 뇌 신호를 제거하는 대조군이 말해 주는 것
저자들은 LibriBrain100의 subject 0에서 가장 빈번한 50개 단어를 분류했다. 아래 값은 단어 클래스별 균형을 맞춘 top-1 정확도다. 문장 성공률이나 환자가 의사소통에 성공한 비율이 아니다. 훈련·검증·테스트는 세션 단위로 분리했다.
| 입력과 처리 조건 | 균형 top-1 단어 정확도 | 분리하려는 정보 |
|---|---|---|
| 실제 MEG, 창을 함께 처리 | 22.3% | 뇌 정보와 시간 구조가 모두 존재 |
| 공유 합성 신호, 창을 함께 처리 | 22.0% | 뇌 정보 없이 실제 시작 시각과 겹침 유지 |
| 각 창에 독립 합성 신호 | 5.8% | 인접 창의 공유 샘플 제거 |
| 실제 MEG, 창을 독립 처리 | 9.5% | 창 사이의 직접적인 공유 패턴 비교 차단 |
| 시작 간격만 입력 | 22.9% | 시간 간격 자체의 예측력 |
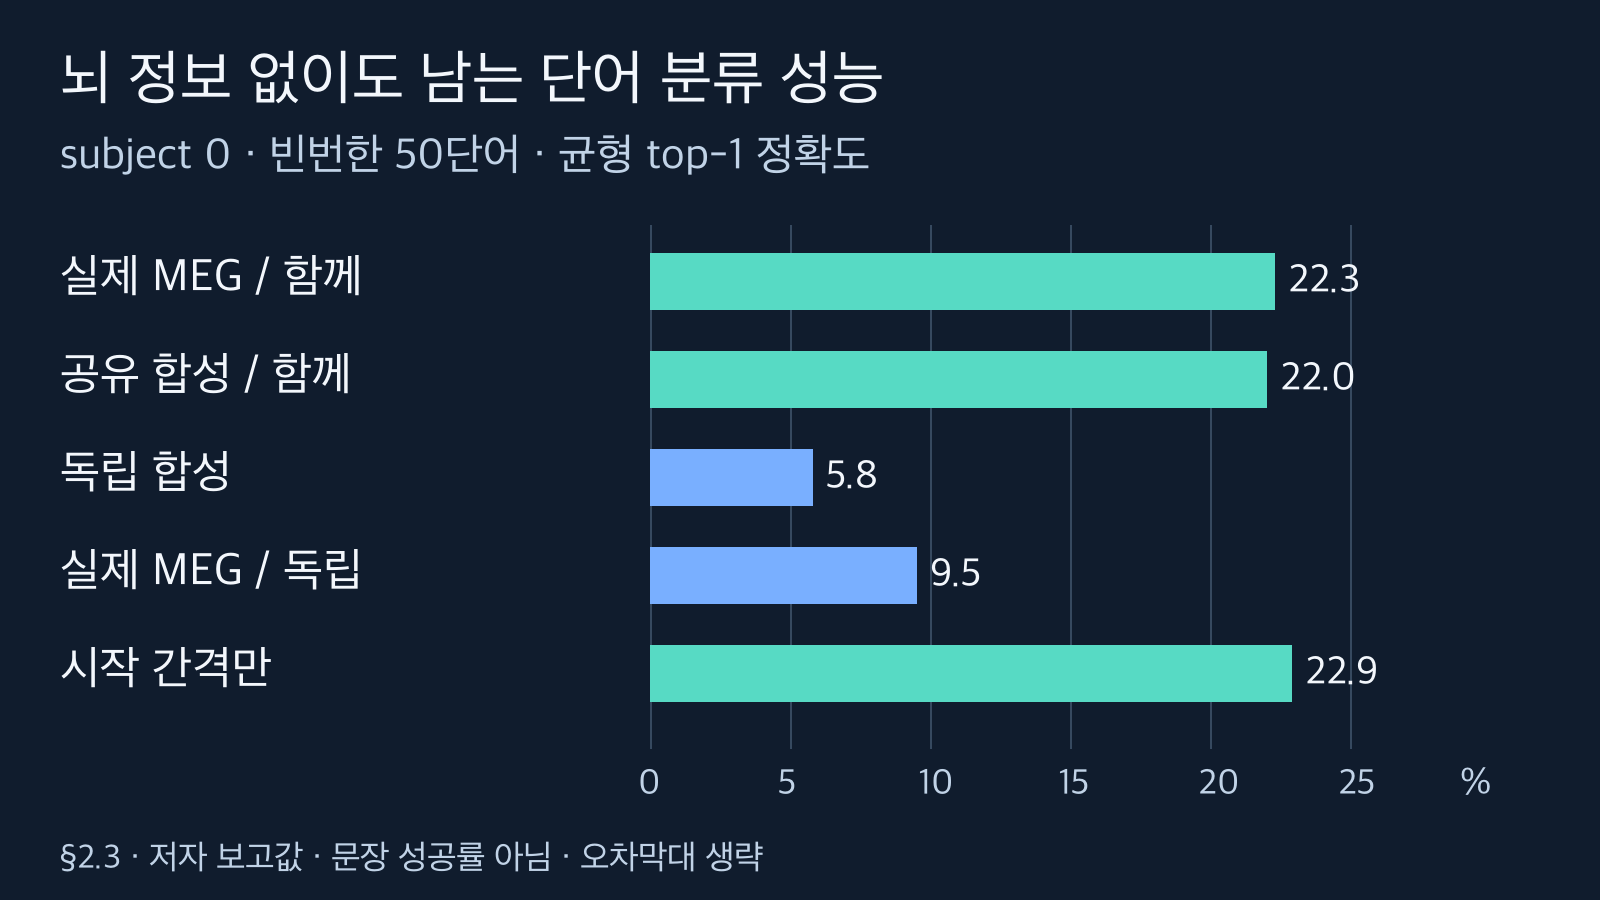
저자 보고 균형 top-1 단어 정확도. 50개 빈번 단어, subject 0. 0–25% 동일 축이며 문장 성공률이 아니고 오차막대는 생략했다. 출처: arxiv.org/html/2609.40359v1.
핵심 비교는 실제 MEG와 공유 합성 신호가 비슷한 값을 보이고, 독립 합성 신호에서는 값이 낮아진다는 점이다. 합성 신호는 단어 의미나 뇌 활동을 담지 않지만 원래의 시작 시각을 이용한 겹침 구조는 남긴다. 따라서 이 실험은 해당 입력 제작 방식에서 함께 처리하는 이득의 상당 부분을 시간 구조로 설명할 수 있음을 뒷받침한다. 단순히 아무 잡음을 넣어 본 실험이 아니라, 없애는 정보와 남겨 두는 정보를 구별한 대조군이다.
그러나 모든 비침습적 뇌-텍스트 모델이 뇌 정보를 사용하지 않는다는 결론은 아니다. 같은 논문의 Brain2Qwerty 대조군에서는 시간 단서가 실제 MEG의 강한 성능을 설명하지 못했다. 시작 시각을 모르는 설정 또한 여기서 평가한 과제와 다르다. 그림의 막대는 저자가 보고한 평균값을 재작성한 것이며, 원시 실험이나 모델을 독립 재현한 결과가 아니다. 원문 §2.3, Figure 1, 부록 A.7
3. SimpleB2T는 무엇을 독립적으로 처리하는가
SimpleB2T는 각 단어 창을 작은 CNN과 MLP로 따로 인코딩한다. 동일한 단어의 서로 다른 기록에서 얻은 예측을 모으고, 언어 모델의 사전 지식과 결합해 문장을 고른다. 창 인코더는 약 2천만 파라미터지만 문장 재채점에는 Qwen3-8B-Base를 사용한다. 따라서 전체 시스템이 2천만 파라미터라거나 측정된 속도 향상이 있다는 표현은 맞지 않는다.
독립 처리란 인코더가 다른 창을 동시에 보지 않는다는 뜻이다. 하나의 3초 창 자체에는 뒤이어 나온 단어에 대한 뇌 반응이 들어 있을 수 있다. 또한 문장의 단어 개수는 이미 알려져 있으며, 검색은 제한된 92개 단어 후보를 사용한다. 이것은 자유로운 생각이나 제한 없는 자연어를 그대로 복원하는 과제가 아니다.
4. 36.6%를 읽기 전에 분모와 관측 비용부터 확인하기
논문의 의사소통 벤치마크는 환자에게 새로 녹음한 문장이 아니다. 보류한 기록에서 각각의 단어에 해당하는 별도 관측을 가져와 문장 위치에 배치했다. Core는 짧은 돌봄 관련 문장 100개, Expanded는 더 다양한 문장 100개, Full은 둘을 합친 200개다. 고정 커밋의 저자 로더 문서에는 Core 기준 단어 위치 595개, Full 기준 1,275개가 명시되어 있다.
단어 오류율 WER의 분모는 기준 문장의 단어 수다. 대치·삭제·삽입 오류를 세는 지표이며, 틀린 문장의 비율이 아니다. 문장 전체가 정확히 일치한 비율은 별도의 SMR로 보고된다. 서로 다른 두 지표를 같은 성공률로 바꾸어 읽으면 안 된다.
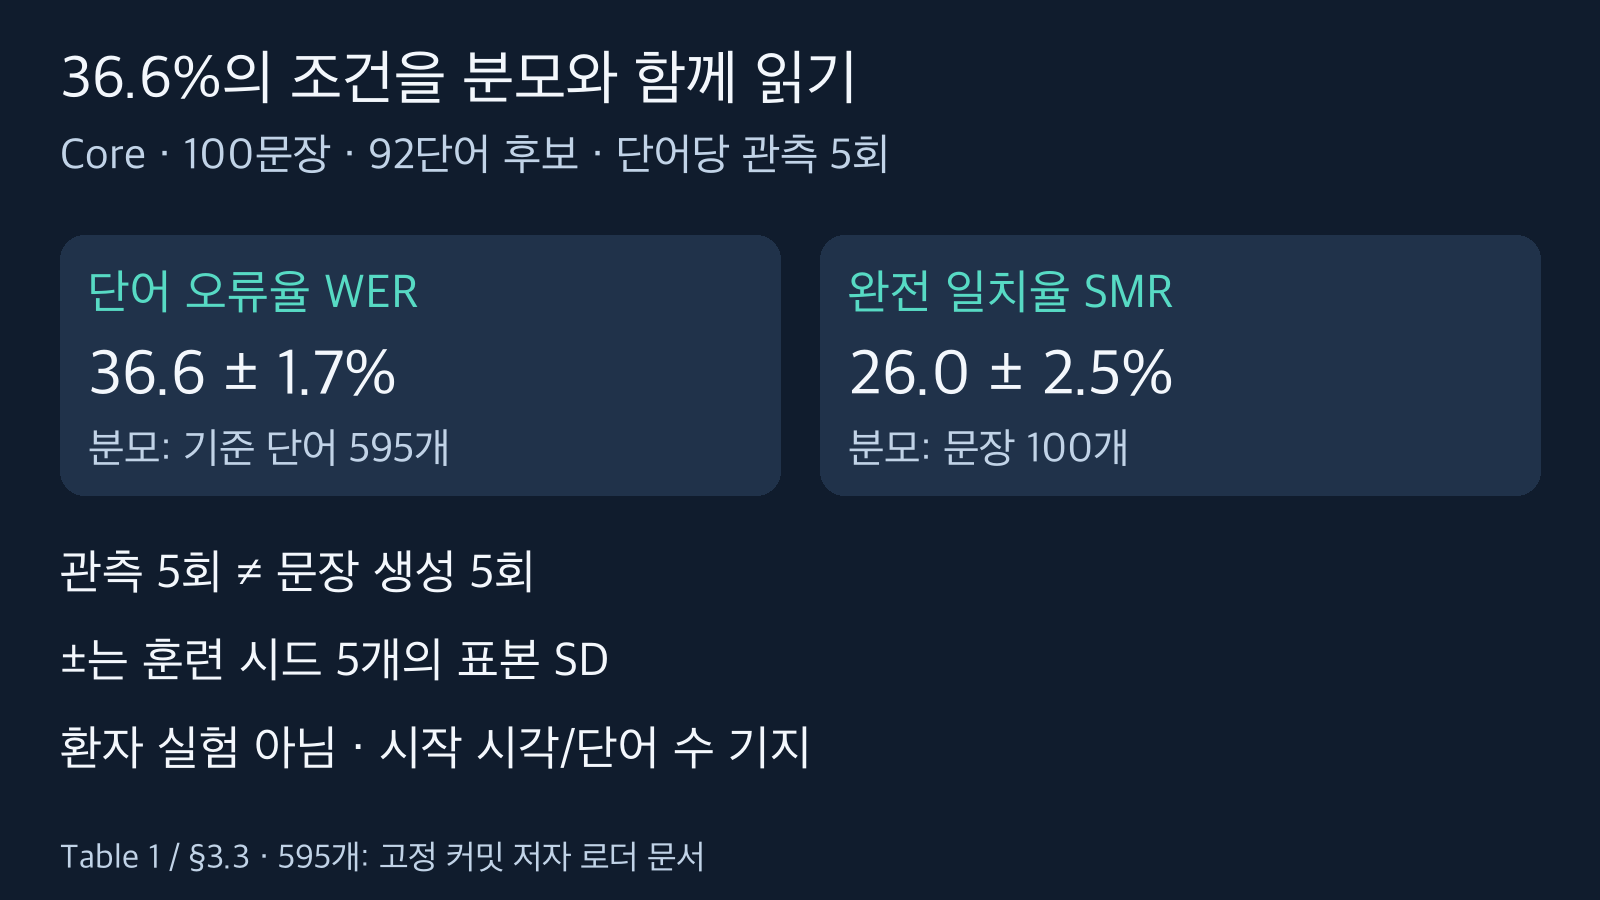
Core의 k=5 조건. WER와 SMR은 분모가 다르다. ±는 5개 훈련 시드의 표본 표준편차이고 595단어는 고정 커밋 저자 로더의 기준 위치 수다. 출처: arxiv.org/html/2609.40359v1.
SimpleB2T의 Core WER는 단어당 관측 한 번에서 65.6±0.8%, 관측 다섯 번에서 36.6±1.7%다. 관측 다섯 번은 같은 단어의 별도 MEG 기록 다섯 개이지, 같은 문장을 다섯 번 생성해 가장 좋은 것을 고르는 방식이 아니다. 반복 관측은 추가 측정 부담을 요구한다. 또 관측 수를 바꿀 때 개발 세트에서 선택한 언어 모델 가중치도 한 번 조건의 1.5에서 다섯 번 조건의 0.5로 바뀐다. 따라서 이를 동일한 측정 비용과 고정 가중치 아래에서 얻은 순수한 개선 효과로 말하지 않는다.
같은 다섯 번 관측 조건에서도 Expanded WER는 44.8±3.7%, Full은 41.0±2.2%다. Core의 문장 완전 일치율은 26.0±2.5%, Full은 23.1±3.0%다. 모든 ± 값은 다섯 훈련 시드에 걸친 표본 표준편차이며 신뢰구간이 아니다. 다섯 시드는 다섯 환자를 의미하지 않는다. 주요 문장 실험은 subject 0의 기록을 사용한다. 원문 §3.3–3.4, Table 1, 부록 B.3, 고정 커밋의 벤치마크 문서
5. 언어 모델이 전부 대신 푸는 것은 아닌가
제한된 후보와 환자 요청이라는 문맥은 언어 모델에 강한 힌트를 준다. 그 영향을 분리하기 위해 저자는 Core의 관측 다섯 번 조건에서 언어 모델만 사용하거나, 실제 뇌 표현을 다른 단어 위치에 섞어 붙이는 비교도 했다. 언어 모델만 사용할 때 WER는 73.8%, 섞인 뇌 표현과 언어 모델을 결합하면 88.3±1.9%, 올바른 뇌 표현과 결합하면 36.6±1.7%였다. 언어 모델을 쓰지 않은 뇌 디코더의 값은 74.3±2.0%다.
이 비교는 해당 벤치마크에서 올바른 관측과 짝지어진 신경 정보가 언어 사전 지식에 보완적으로 쓰였다는 근거다. 표현을 섞는 실험은 표현의 분포를 남기면서 정답 위치와의 대응만 깨뜨린다. 다만 임상 유효성이나 환자의 내적 발화를 읽는 능력까지 검증하지는 않는다. LM-only는 결정론적 결과 한 값이고, 뇌 조건은 훈련 시드의 평균과 표준편차다. 이 차이도 표 해석에 남겨 두어야 한다. 원문 Table 2(a,b), §3.4, 부록 B.2
6. 개발자용 진단표: 무엇을 없애고 무엇을 남길 것인가
합성 신호에서도 성능이 유지된다면 먼저 입력을 만드는 규칙을 감사한다. 모델을 더 크게 만들기 전에 공유 샘플, 실제 시작 시각, 패딩 길이를 각각 분리해 본다. 다음 표는 논문의 실험을 시간 정렬 모델에 적용할 때 사용할 수 있도록 작성한 편집적 진단 도구다. 아래의 다음 행동은 이번 글에서 실행한 실험 결과가 아니라 후속 평가 설계다.
| 관찰한 결과 | 우선 의심할 통로 | 다음에 설계할 비교 | 피할 결론 |
|---|---|---|---|
| 뇌 정보 없는 공유 합성 신호에서도 이득 유지 | 실제 시작 시각과 겹치는 샘플 | 동일 생성 규칙으로 각 창을 독립 생성 | 모든 신경 디코더가 무의미하다는 일반화 |
| 테스트에서 겹침을 없애자 성능 급락 | 지름길 또는 훈련·테스트 입력 불일치 | 비겹침 조건에서 재훈련하고 독립 인코더와 비교 | 급락 한 번만으로 원인을 확정 |
| 입력 표현을 섞자 결합 모델 성능 악화 | 실제 관측과 정답의 대응 관계 | 표현 분포는 유지하고 위치 대응만 끊기 | 언어 모델이 언제나 전부 대신 푼다는 주장 |
| 관측을 늘리면 오류 감소 | 측정량과 언어 가중치 변화 | 관측 비용을 적고 고정 가중치 비교도 추가 | 추가 녹음 없이 얻는 무료 개선 |
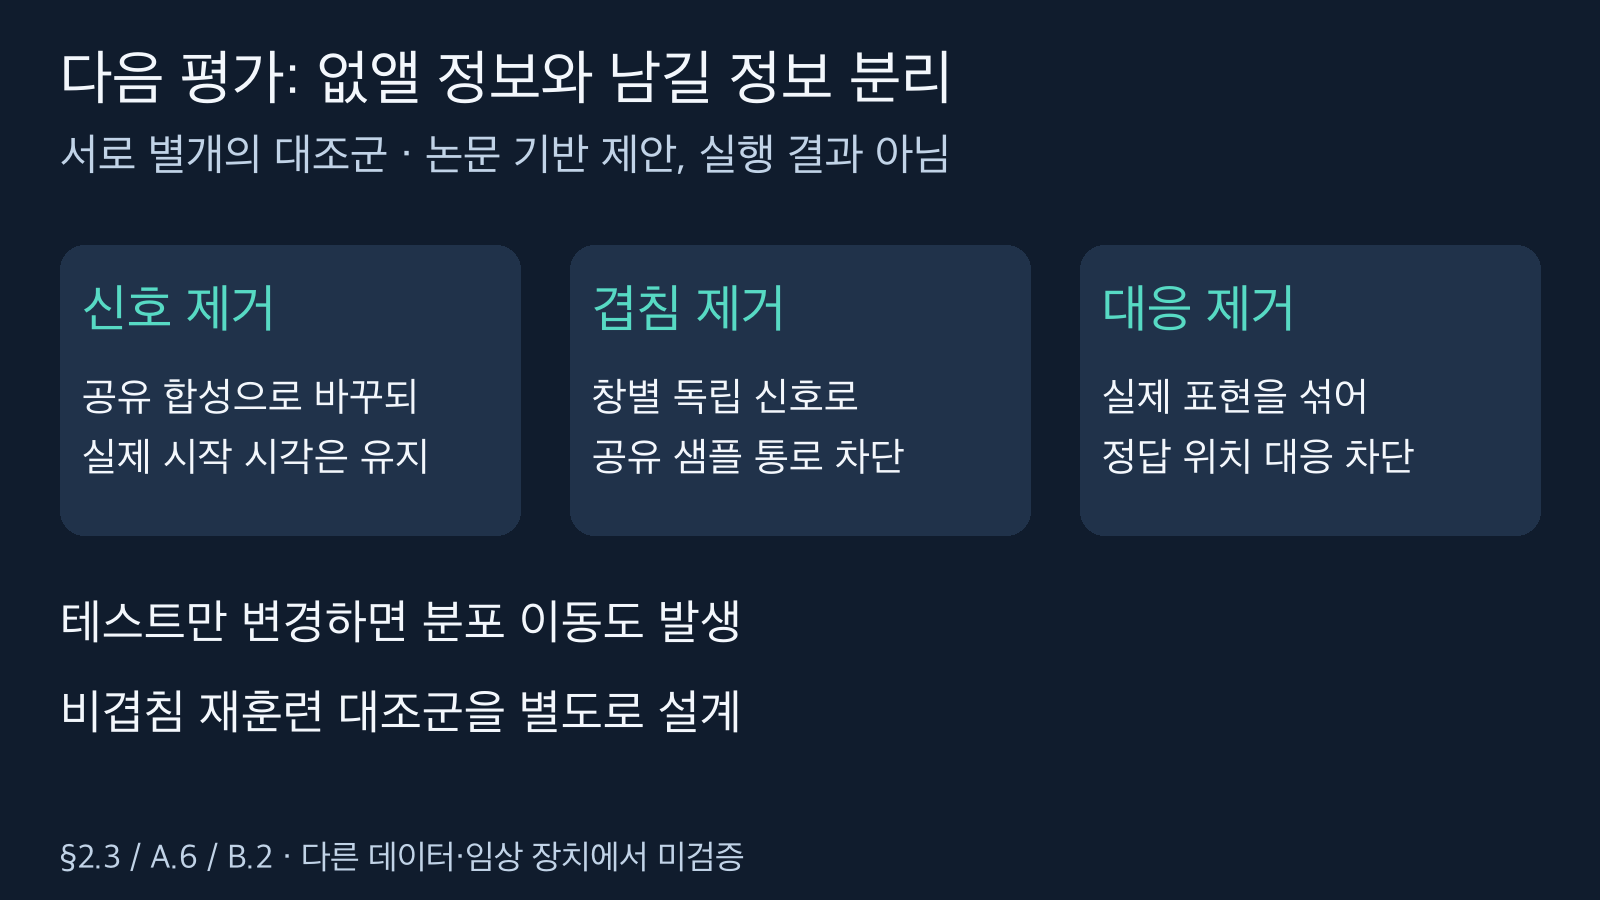
논문 대조군에서 도출한 별개의 평가 설계. 연속 적용 순서나 이번 글의 실행 결과가 아니며 실제 신호 표현 섞기는 별도 비교다. 출처: arxiv.org/html/2609.40359v1.
실무에서는 먼저 같은 라벨 정의, 세션 분리, 후보 어휘, 지표를 고정한 뒤 대조군을 비교하는 편이 해석하기 쉽다. 패딩이나 마스크의 길이도 라벨의 간접 단서가 될 수 있으므로, 신호 값을 제거해도 메타데이터 통로가 남는지 별도로 확인한다. 특히 테스트 입력만 바꾸는 비교는 분포 이동과 누설 제거를 동시에 일으킬 수 있다. 논문이 비겹침 조건의 재훈련 대조군을 추가한 이유도 이 구분에 있다.
이 진단표는 논문의 대조군을 바탕으로 작성한 설계 제안이며, 독자의 데이터나 임상 장치에서 검증된 절차는 아니다. 원시 MEG, 학습 가중치와 디코더 실행을 이번 글에서 재현하지 않았다. 보존된 조사 기록에서 논문이 연결한 SimpleB2T 저장소 API는 확인 당시 HTTP 404였으나, 이를 영구적인 코드 부재로 해석하지 않는다. 접근 가능한 고정 커밋의 벤치마크 문서는 분모와 관측 구성을 확인하는 보조 근거로만 사용했다.
7. 가져갈 결론과 남아 있는 경계
이 연구에서 유용한 교훈은 성능을 낮추는 대조군이 아니라 어떤 정보를 남긴 상태에서 성능이 유지되는지를 확인하는 대조군이다. 겹침을 보존한 합성 신호, 겹침을 끊은 독립 합성 신호, 시작 간격만 사용하는 입력은 서로 다른 정보 통로를 가리킨다. 독립 인코딩과 반복 관측, 언어 모델의 결합도 그 통로를 구별한 뒤 해석해야 한다.
비침습적 의사소통 기술의 가능성과 지금 검증한 과제의 범위는 함께 말해야 한다. 알려진 단어 시작 시각과 문장 길이, 92개 후보 어휘, 별도 기록을 조립한 문장, 지각된 발화라는 조건은 작지 않다. 마비 환자의 내적·상상 발화 해독이나 실제 임상 사용은 검증되지 않았다. 논문도 사용자 동의와 후속 사용자 중심 검증을 강조한다. 입력 제작 규칙의 지름길을 먼저 제거해야, 신경 신호가 제공하는 정보와 앞으로 개선할 병목을 더 정확히 볼 수 있다.
출처와 확인 범위
- 원문 및 표·부록: Removing Timing Shortcuts Improves Non-Invasive Brain-to-Text, arXiv:2609.40359v1
- 버전 고정 본문: arXiv HTML v1
- 분모·관측 구성: PNPL clinical communication 문서, commit 33aff3fd70a197a47f73a06cb5d1e6b0e1cbfb9b
그림은 원문 결과와 조건을 바탕으로 새로 작성한 설명 도식과 데이터 차트다. 논문 그림이나 실험 화면을 캡처한 이미지가 아니다. 관련 내부 글은 이번 입력의 보존된 중복 검사에서 다른 메커니즘의 이웃 주제만 확인되어, 직접적인 후속 자료로 오해하게 하는 링크를 억지로 넣지 않았다.


댓글
댓글 쓰기