인용은 맞아도 결론은 과할 수 있다: SmoothScore의 지지·반박 근거 대조
1. 개별 절감 근거가 있어도 ‘함께 쓰면 해결’은 다른 주장이다
토큰 가지치기, 희소 전문가 라우팅, 적응형 중단이 각각 특정 환경에서 추론 비용을 줄였다고 하자. 세 문헌을 인용한 AI 보고서가 이를 합쳐 “모두 적용하면 거대한 모델도 지연 폭증 없이 운용할 수 있다”고 결론 내렸다면, 인용 링크가 유효하다는 확인만으로 채택해도 될까?
빠진 것은 조합 자체의 평가다. 가지치기·라우팅·동기화·커널에서 생기는 부가 비용과 상호작용을 측정하지 않았다면, 개별 기법의 이득이 합쳐진다는 보장이 없다. 이는 논문 Table 2의 설명 사례를 재서술한 것으로, 이 글이 실행한 제품 실험이 아니다. 기법들이 무효라는 뜻도, 조합이 불가능하다는 뜻도 아니다. 확인된 범위보다 강한 보장만 걷어 내자는 이야기다.
이 문제를 다룬 프리프린트가 Tiasa Singha Roy·Manya Wadhwa·Greg Durrett의 Quantifying Claim Smoothing by LLM Research Agents다. 이 글은 2026년 10월 26일 공개된 v1과 선정 시 보존된 저자 자료를 읽었다. 논문에는 심사 중이라고 적혀 있으며 심사 완료나 학회 채택을 확인한 연구로 소개하지 않는다.
먼저 실무적인 답부터 정리하면 이렇다. 같은 비교 차원에서 지지 근거와 제한 근거를 나란히 놓고, 조합 자체를 평가했는지 따로 확인한다. ‘근거가 존재하나’에서 끝내지 않고 ‘그 근거로 여기까지 말할 수 있나’를 묻는 것이다.
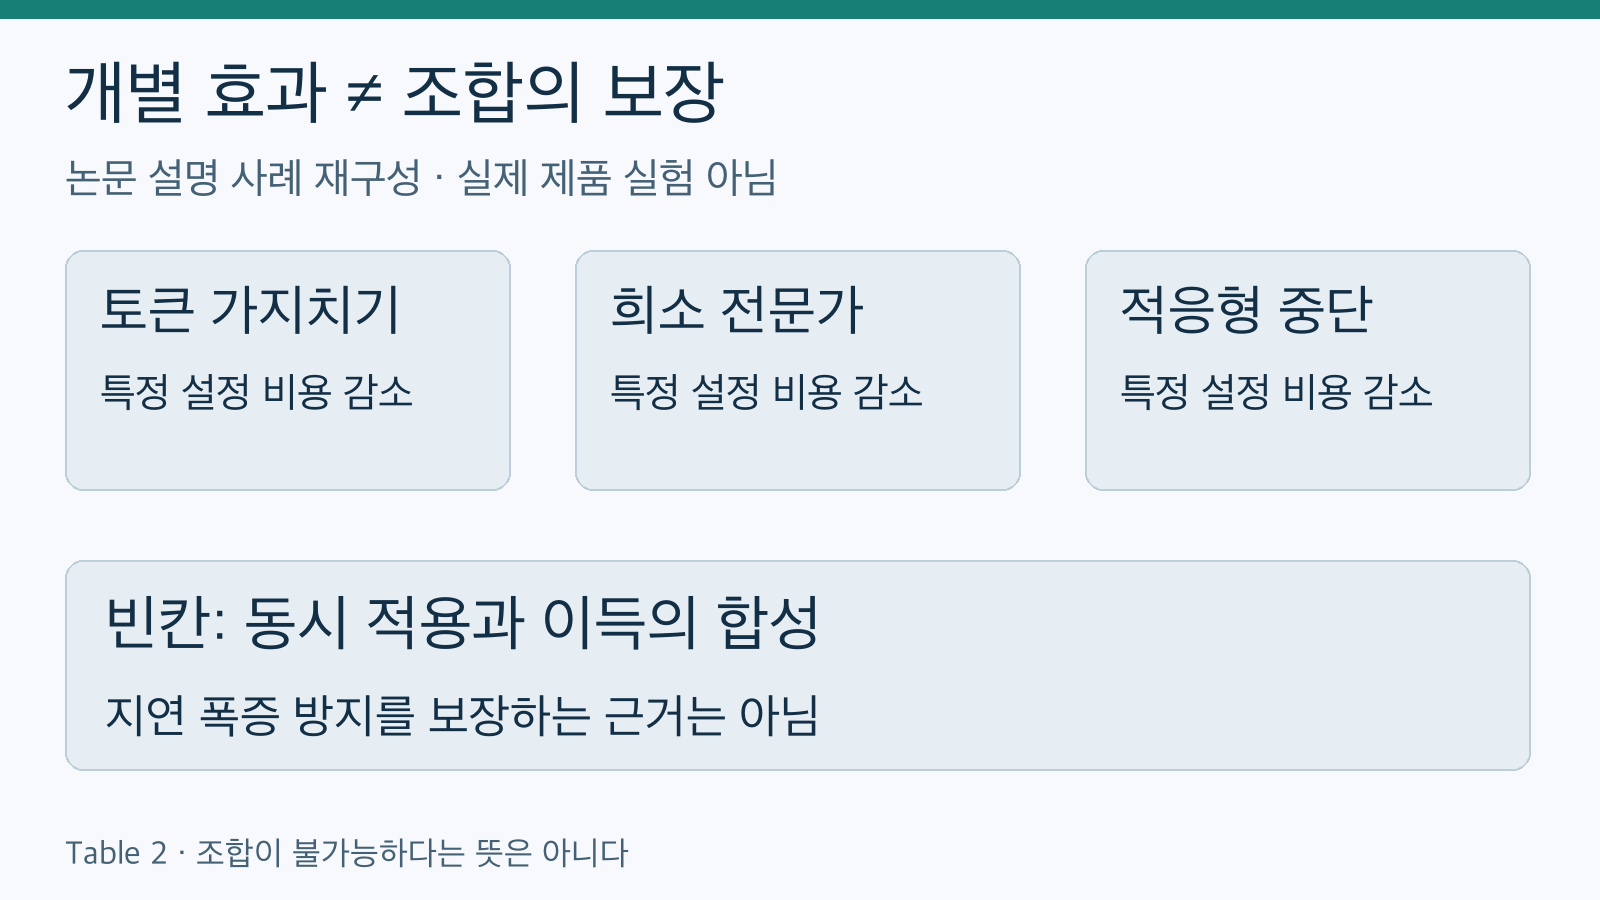
개별 효과가 있어도 이득의 합성은 별도 근거가 필요하다. Table 2의 저자 사례를 재구성했으며 제품 실험이나 조합 불가능성의 증거가 아니다. 출처: arxiv.org/abs/2610.35793v1.
2. 보고서 채택 전에 쓰는 ‘결론 범위’ 검토표
다음은 위 사례에 적용한 편집용 검토표다. 논문의 aspect별 근거 대조를 사람이 보고서를 검토하는 양식으로 바꿨다. 지지 문헌과 반박 문헌의 개수를 투표처럼 세지 않는 것이 핵심이다. 같은 성능·비용·설정에 대한 이야기인지 먼저 맞춰야 한다.
| 검토 항목 | 지지되는 내용 | 같이 보아야 할 조건·빈칸 | 채택할 표현 또는 후속 판단 |
|---|---|---|---|
| 개별 효과 | 각 기법은 특정 설정에서 추론 비용을 낮출 수 있다 | 대상 모델, 하드웨어, 지연과 처리량의 측정 조건이 다를 수 있다 | ‘각각의 조건에서 비용 감소가 보고됐다’로 범위를 보존한다 |
| 동시 적용 | 개별 효과를 뒷받침하는 자료는 있다 | 세 기법의 동시 적용과 이득의 합성은 제시된 근거에서 평가되지 않았다 | ‘함께 쓰면 지연 문제가 해결된다’는 보장은 채택하지 않는다 |
| 실제 도입 | 조합을 검토할 후보로 삼을 수는 있다 | 목표 환경의 부가 비용·상호작용은 별도 측정 대상이다 | 적용 가능성 검토와 성능 보장을 분리한다 |
수정 전 결론은 “세 기법을 함께 쓰면 대규모 모델의 지연 폭증을 막는다”다. 범위를 보존한 결론은 “각 기법의 특정 환경 비용 감소 근거는 있지만, 동시 적용 시 지연 이득이 합성되는지는 제시된 근거만으로 보장할 수 없다”다. 후자는 무조건 부정하는 문장이 아니다. 지지된 부분은 남기고, 입증되지 않은 연결만 분리한다.
이 검토표는 논문 방법에서 도출한 편집 제안이며, 검증된 업무 절감 효과나 완전한 사실성 보증이 아니다. 실제 조직에서는 결론이 바뀔 때 비용이나 안전에 영향을 주는 주장부터 우선 검토하는 용도로 쓸 수 있지만, 검토 시간이나 오류 감소율을 이 연구에서 측정한 값처럼 붙여서는 안 된다.
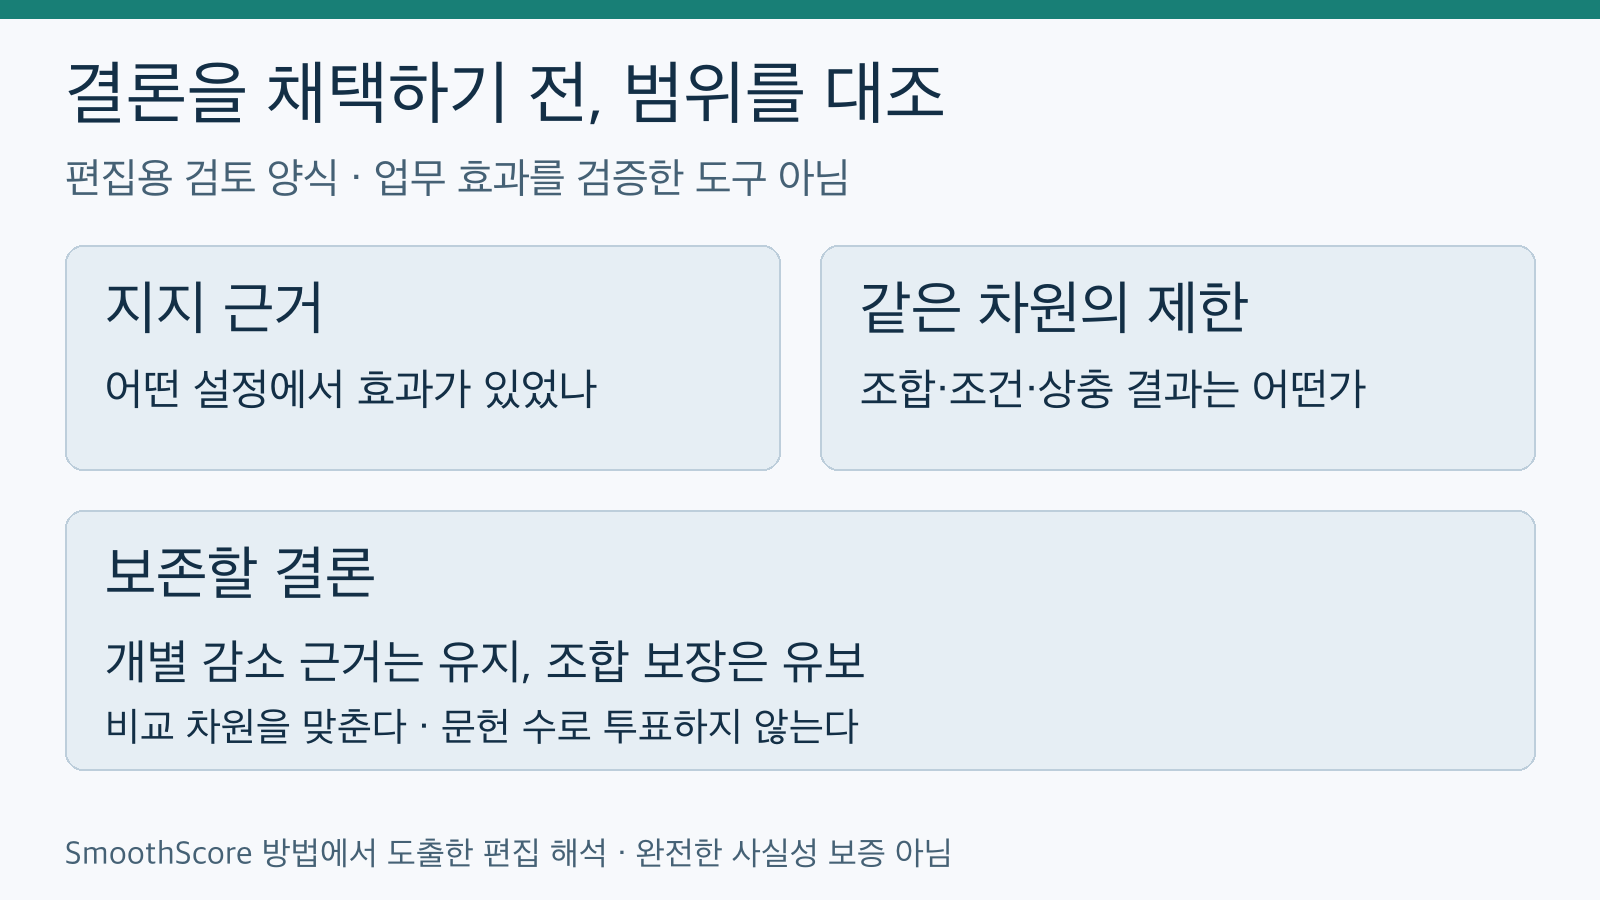
같은 비교 차원으로 지지와 제한을 맞춘 뒤 결론의 범위를 정한다. 논문 방법에서 도출한 편집 제안이며 업무 개선 효과를 검증한 도구는 아니다. 출처: arxiv.org/abs/2610.35793v1.
3. SmoothScore는 무엇을 채점하고 무엇을 놓칠 수 있나
논문 §2.1의 claim smoothing은 여러 근거를 합친 결론 중, 일부 지지는 있지만 전체 결론의 강도나 범위가 근거 전체보다 커진 경우다. 인용이 전부 날조된 상황만 찾는 것이 아니다. 한 논문의 좋은 결과를 다른 조건으로 넓히거나, 상충하는 결과를 줄여 말하거나, 조합 효과를 확인한 것처럼 종합하는 문제가 포함된다.
SmoothScore는 보고서의 결론성 주장을 추출하고, 그 보고서가 인용한 문서에서 지지 근거와 회의적 근거를 따로 모은다. 이어 비교 차원인 aspect를 유도·병합하고 근거를 배정한 뒤, 최종 judge가 1–5점으로 판정한다. 같은 비교 차원에서 서로 다른 결과를 나란히 보게 하려는 구조다. 숫자는 낮을수록 근거 범위에 충실하다는 방향이며, 저자들은 3점 이상을 중요한 수정이 필요한 주장으로 해석한다. 앞의 조합 사례는 Table 2에서 3점이다.
대상은 각 보고서에서 추출한 결론성 주장이다. 보고서 전체의 모든 문장이나 세상의 모든 문헌을 빠짐없이 검증하는 점수가 아니다. 특히 보고서가 애초에 인용하지 않은 결정적인 문헌이 있다면, 인용 문서에 상대적인 평가만으로 그 누락을 해결했다고 볼 수 없다. 자동 추출과 주관적 판정의 오류도 남는다.
Appendix A.1/Table 8에 따르면 추출·근거 처리에는 GPT-5-mini, 최종 판정에는 GPT-5를 사용하며 reasoning effort는 medium, 샘플링은 기본 설정이다. 이 글은 그 모델들을 실행하거나 논문 결과를 독립 재현하지 않았다. 여러 단계를 거친 점수라는 이유만으로 독립적인 진실 판정으로 격상할 수는 없다.
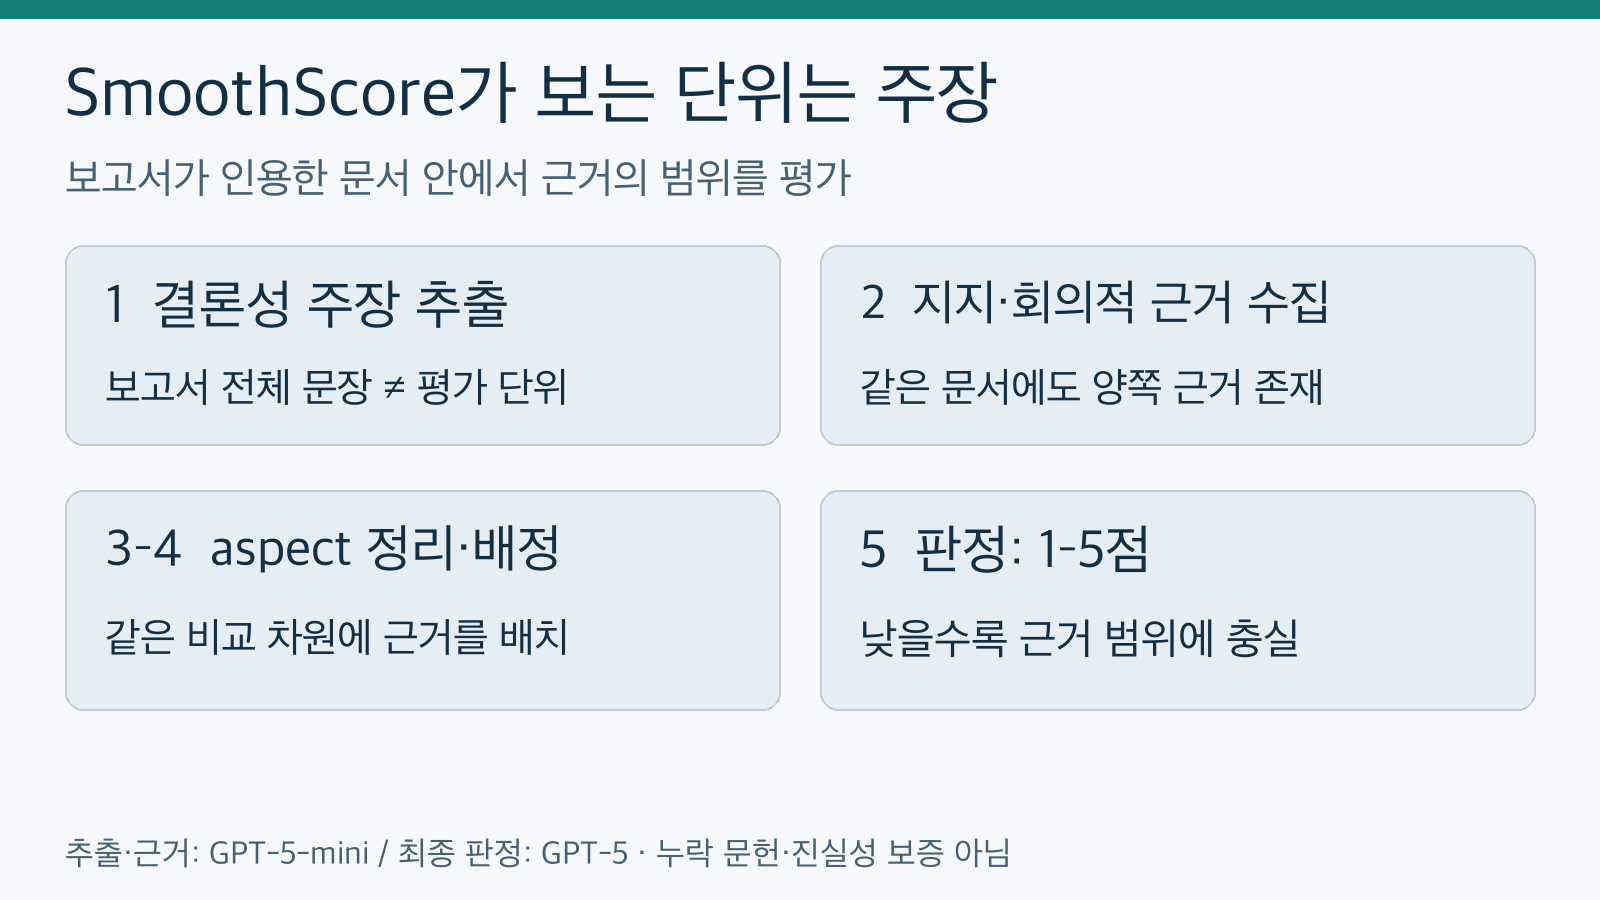
평가 단위는 추출된 결론성 주장이고 근거 범위는 보고서가 인용한 문서다. 낮은 점수가 더 충실하다는 방향이지 세계의 진실성을 보증하는 점수는 아니다. 출처: arxiv.org/abs/2610.35793v1.
4. 원문과 범위 보정 지시를 함께 줬을 때의 결과
독자에게 실용적인 대목은 §6/Table 6이다. ResearcherBench의 61질문에서 기존 WebSearch 보고서가 인용한 문서 전체를 문맥에 넣고 검색을 끈 조건, 그리고 범위를 보정하라는 지시를 결합한 조건을 비교했다. ‘더 읽으면 좋아진다’는 조언이 아니라, 문서 제공과 지시라는 두 개입을 구분해 제시한 실험이다.
| 조건 | Luna 평균 / 추출 주장 수 | Sonnet 5 평균 / 추출 주장 수 |
|---|---|---|
| WebSearch | 1.95 / 416 | 2.54 / 407 |
| WebSearch + 보정 지시 | 1.88 / 397 | 2.23 / 391 |
| 인용 문서 전체 제공, 검색 끔 | 1.80 / 390 | 2.38 / 394 |
| 문서 전체 + 보정 지시 | 1.52 / 378 | 1.78 / 367 |
두 시스템 모두 결합 조건의 평균이 각 단독 조건보다 낮았다. 다만 표의 분모는 조건마다 추출된 주장이고, 같은 주장을 일대일로 추적한 전후 비교가 아니다. 보고서 길이도 달라졌다. 그러므로 1.95→1.52를 정확도 퍼센트나 동일 주장 개선율로 바꾸면 안 된다. 동일 토큰 예산, 같은 비용에서의 읽기 행동 하나의 인과 효과, 실제 업무 성공률을 측정한 결과도 아니다.
논문 전체 연구는 7시스템·4벤치마크를 다룬다. Appendix A.2에서 ResearcherBench 65질문과 expert ScholarQA-CS2 25질문은 전체를 썼고, DeepResearch Bench II 영어 66후보 중 18질문, ResearchRubrics 101후보 중 17질문은 수작업 선별했다. Table 6의 61질문을 Table 1의 65질문 전체 결과와 섞으면 안 된다. 확인한 본문에서는 65에서 61로 줄어든 이유가 설명되지 않았다. 선별된 다문헌 종합 질문 결과를 일반 웹 질문 전체, 한국어 보고서 전체, 현재 제품의 보편적 순위로 확대하지 않는 편이 맞다.
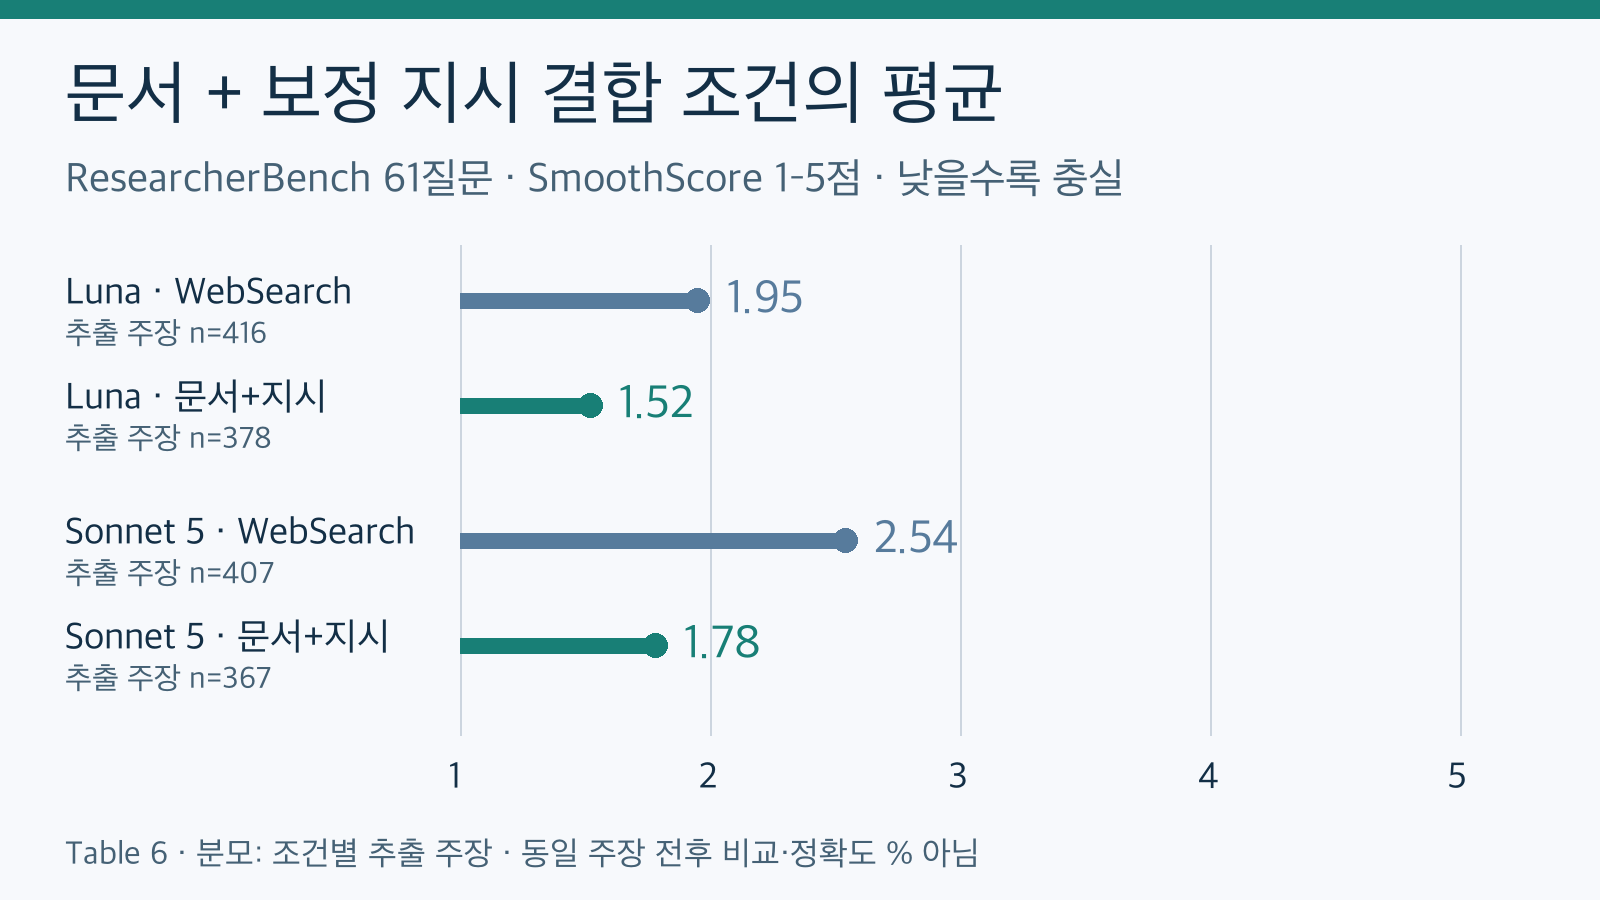
Table 6의 WebSearch와 문서+지시 조건을 1–5점 전체 축에 표시했다. 분모는 각 조건의 추출 주장으로 서로 다르다. 정확도 퍼센트·동일 주장 전후 개선율·비용 절감률이 아니다. 단독 개입 조건은 본문 표에 함께 실었다. 출처: arxiv.org/abs/2610.35793v1.
5. ‘93% 일치’를 정확도라고 쓰면 같은 오류를 반복한다
§5.1/Table 3은 두 저자가 시스템 이름을 가린 동일한 73주장을 독립 채점한 결과다. GPT-5 judge와 Annotator 1의 정확한 점수 일치는 56%, ±1점 이내 일치는 93%다. 인간 두 명의 정확한 점수 일치율은 58%다. 서로 다른 일치 기준이므로 “정확도 93%”라고 압축하면 연구의 의미를 바꾼다. 전체 보고서나 모든 추출 주장을 사람이 검수한 것도 아니다.
신뢰도 통계에는 남은 불일치도 있다. Appendix C 본문의 ordinal α는 judge/인간 간 비교를 0.62/0.64로 적지만 Tables 3/13은 0.68/0.71을 제시한다. 다른 judge 통계도 본문과 표가 일부 다르다. 이 글은 이를 해결했다고 주장하지 않으며 α를 핵심 신뢰성 근거로 사용하지 않는다. 따라서 위의 제한된 일치 관측을 전체 시스템의 신뢰성 인증처럼 쓰지 않는다.
또한 §5.2는 모은 근거를 주고 보고서를 수정했을 때 별도의 rubric 점수가 좋아지는지를 본다. 근거가 보고서 개선에 유용하다는 관측과, 추출한 각 근거가 각 주장에 정확히 대응한다는 직접 검증은 다르다. 저자도 이 차이를 본문에 적었다. 보고서가 인용 페이지를 open/fetch했는지에 관한 trace 역시 ‘실제로 아무것도 읽지 않았다’는 뜻으로 바꾸지 않았다. 검색 응답으로 받은 내용의 관측 한계가 있기 때문이다.
6. 지금 가져갈 것은 설치법보다 결론의 경계다
저자 저장소의 고정 commit c77a61e75577ca095187cad9f0ac8dd1cf72c103에서 확인한 tree는 잘림 없이 README.md 하나뿐이었다. README에는 pipeline과 data가 곧 공개된다고 적혀 있고, 선정 때 보존한 Releases 응답은 빈 목록이었다. 따라서 이 글은 실행 가능한 공개 구현이나 원시 데이터가 준비됐다는 설치 안내를 제공하지 않는다. 이는 그 고정 자료에 대한 확인이지 저장소의 미래 상태에 대한 단정이 아니다.
저자 pipeline이 외부 judge를 쓴다는 점도 도입 판단과 연결된다. 사내 문헌을 같은 구조로 보내려면 해당 자료의 접근·외부 전송 승인을 별도로 확인해야 한다. 이번 글은 사내 문헌을 전송하지 않았고, 실제 실행 비용이나 동일 비용 대비 효과를 측정하지 않았다. 설치와 권한 검토를 마친 도구처럼 제시하지 않는 이유다.
결론적으로 AI 보고서를 채택할 때는 인용 링크의 존재와 종합 결론의 타당성을 분리하는 것이 유용하다. 지지 결과를 버릴 필요는 없다. 다만 지지 결과가 나온 조건, 같은 차원의 제한, 아직 평가하지 않은 조합을 결론에 남겨야 한다. SmoothScore가 제시하는 핵심은 더 많은 인용 자체가 아니라, 근거를 압축하는 과정에서 사라진 경계를 다시 보게 하는 평가 방식이다.
참고 자료
- 논문 v1: Quantifying Claim Smoothing by LLM Research Agents — 정의 §§2.1–2.2, 사례 Table 2, 개입 Table 6, 인간 일치 Table 3, 표본 Appendix A.2, 신뢰도 불일치 Appendix C.
- 저자 저장소의 고정 README — 선정 때 보존한 구현 공개 상태의 근거. 독립 재현 결과가 아니다.


댓글
댓글 쓰기