SQLite 문서 이력, 80.3KiB보다 먼저 볼 것은 저장할 때의 비용이다
문서가 바뀔 때마다 SQLite에 이전 내용을 남기려 한다면, 가장 작은 파일을 만드는 설계가 가장 편한 자동저장 설계는 아니다. Simon Willison이 소개한 실험에서는 과거 문서 전체를 한꺼번에 압축하면 이력 본문이 약 80.3KiB로 작아졌다. 그러나 같은 보고서에서 단일 BLOB 방식은 천 번 저장하는 데 약 26.80초, 128개 버전씩 나눈 JSON 청크 방식은 약 1.528초가 걸렸다. 최종 크기와 저장 과정의 비용은 다른 질문이다. 원문과 연결된 실험 보고서를 함께 봐야 하는 이유다.
저장이 잦고 이력이 계속 쌓인다면, 최종 압축 크기보다 매번 다시 쓰는 범위를 먼저 제한하자. 이 글은 이 결정을 위한 비교표와 점검 순서를 제안한다. 이 수치는 작성자 측 합성 워크로드의 측정값이며, 이 글에서 벤치마크를 재현한 결과가 아니다.
1. 20.4MB가 80.3KB가 됐다는 말의 정확한 범위
2026년 8월 9일 원문의 눈에 띄는 결과는 천 번의 모의 수정으로 쌓인 과거 본문이다. 저장된 결과 JSON에서 원시 스냅샷 본문 합계는 21,387,200바이트, 단일 JSON 배열을 Zstandard로 압축한 이력 BLOB은 82,254바이트다. 원문은 MB·KB로 적었지만 반올림 기준은 이진 단위다. 엄밀히 쓰면 각각 약 20.4MiB와 80.3KiB다.
여기서 분모를 바꾸면 안 된다. 80.3KiB는 데이터베이스 전체도, 현재 문서와 시간 정보를 포함한 크기도 아니다. 단일 BLOB 전략에는 타임스탬프 JSON 11,001바이트가 별도로 있고, 압축 정리된 DB 크기는 122,880바이트로 기록돼 있다. 현재 문서는 별도 TEXT다. 이 항목들을 구분해야 “앱 저장 공간이 곧바로 80.3KiB가 된다”는 오해를 피할 수 있다. 저장된 단일 BLOB 측정 결과의 compression_scaling과 storage 필드가 근거다.
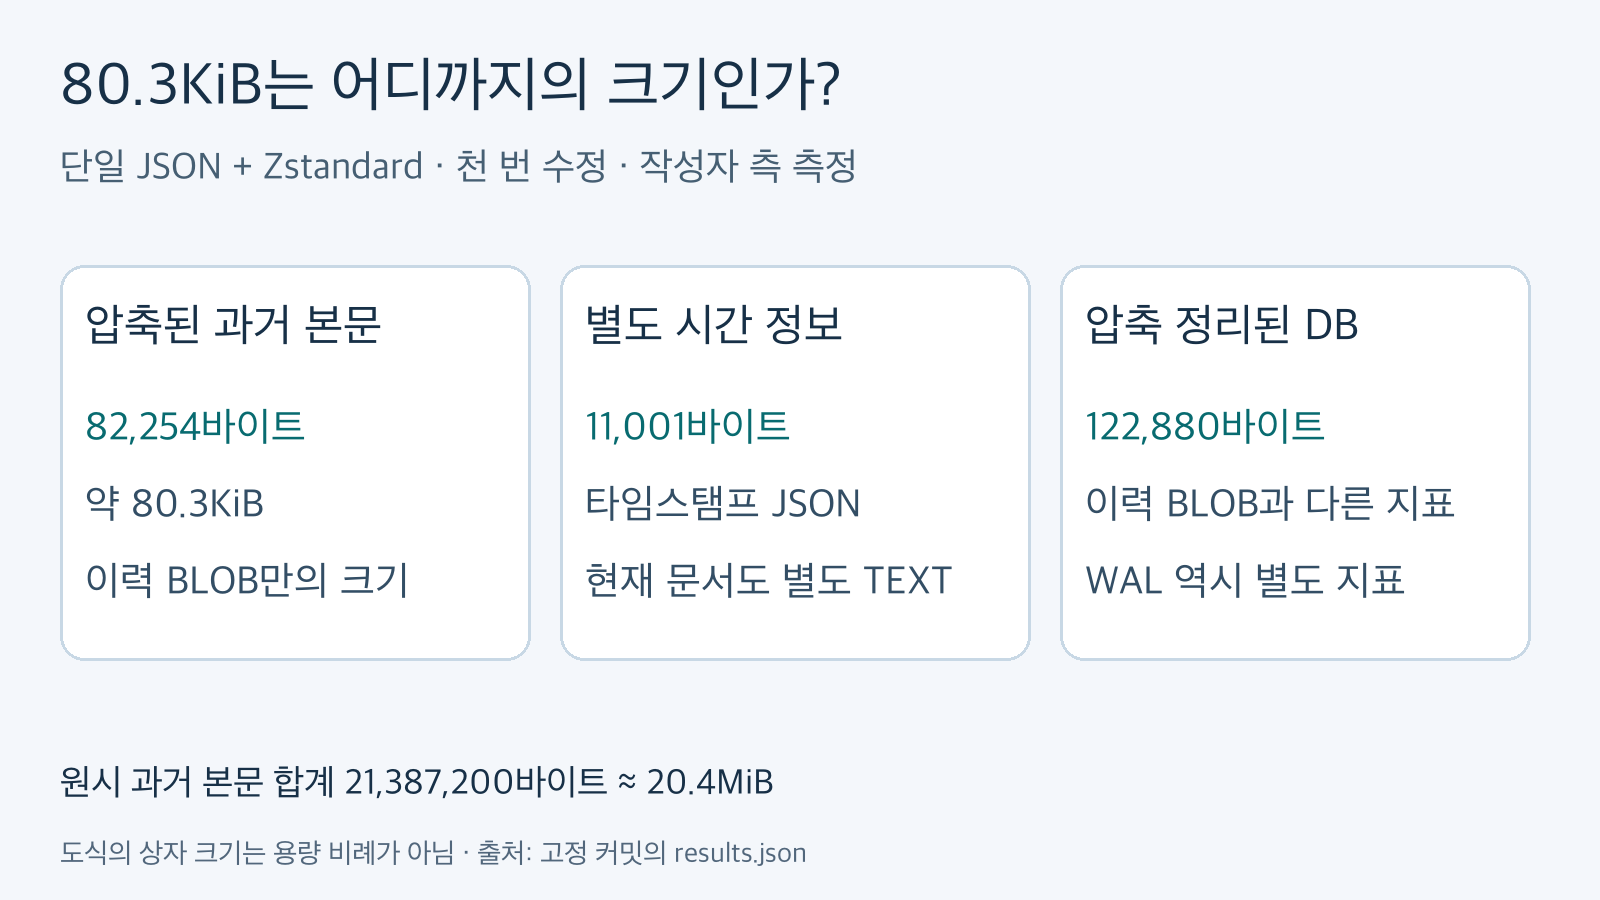
과거 본문 BLOB, 시간 정보, 압축 정리된 DB의 분모를 구분했다. 상자 면적은 용량 비례가 아니다. 출처: github.com/simonw/research/blob/4905e58343b80a01a05144e946b7a6e1618d170a/sqlite-text-history-prototype/benchmark-output-1000/results.json.
2. 수정분을 저장하는 대신, 비슷한 전체 문서를 함께 압축한다
이 방식은 텍스트 diff를 직접 계산해 저장하는 구현이 아니다. 각 과거 버전의 전체 문자열을 직렬화하고, 비슷한 문자열이 이어진 덩어리를 압축한다. 버전 사이에 반복되는 내용이 많으면 압축기가 그 중복을 활용한다. 반대로 매번 관계없는 내용으로 바뀌는 문서라면 같은 이점을 기대하기 어렵다. 보고서의 민감도 실험은 이 한계를 설명하지만, 여기서는 별도 원시 결과가 동결되지 않은 민감도 표의 수치를 성능 근거로 재사용하지 않는다.
현재 문서는 일반 SQLite TEXT로 남는다. 따라서 현재 값을 읽는 경로와 과거 버전을 복원하는 경로를 분리할 수 있다. 과거 압축 BLOB 자체를 검색 가능한 SQL 문자열처럼 취급할 수는 없다. 과거 전체 검색이 요구사항이라면 별도 인덱스나 검색용 파생 데이터까지 설계해야 한다. 이 구분은 README의 두 구현 설명과 REPORT의 Additional production details에 명시돼 있다.
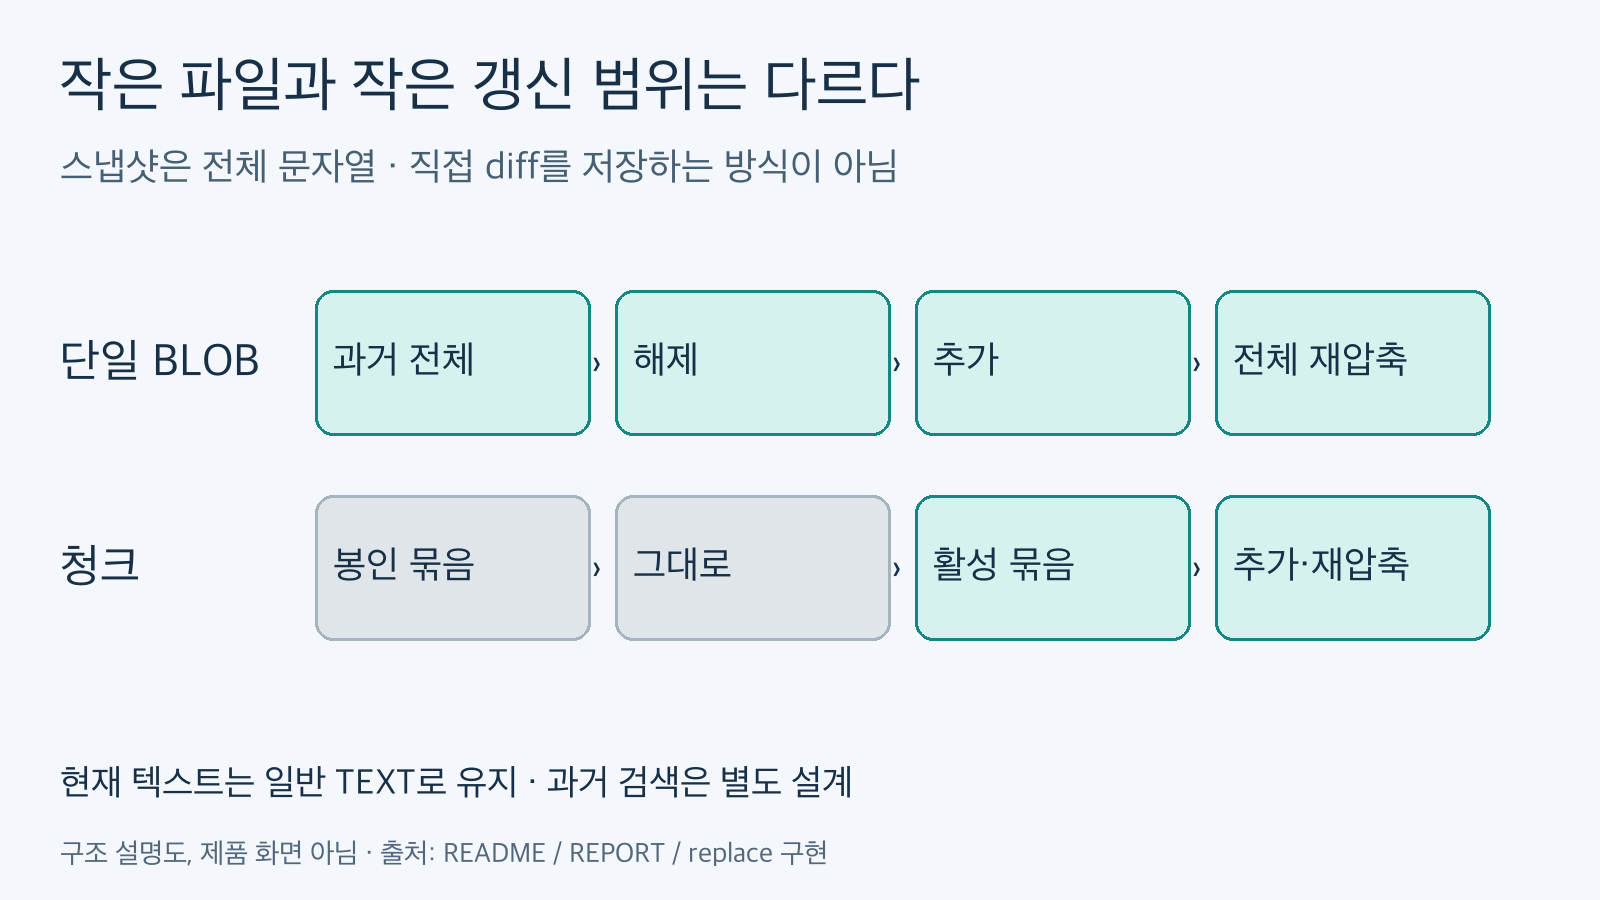
현재 텍스트는 별도 TEXT로 두고, 단일 BLOB은 전체 이력, 청크는 활성 묶음을 갱신한다. 구조 해설이며 제품 화면이 아니다. 출처: github.com/simonw/research/blob/4905e58343b80a01a05144e946b7a6e1618d170a/sqlite-text-history-prototype/REPORT.md.
단일 BLOB에서는 저장할 때 자라는 과거 이력을 풀고 다시 압축한다. 청크에서는 이미 찬 묶음을 두고 마지막 활성 묶음만 고친다. 비유하면 문서철 전체를 다시 묶는 대신 마지막 소책자만 갈아 끼우는 차이다. 이것은 압축 알고리즘의 우열보다 갱신 경계의 선택이다. 다만 활성 청크만 바뀐다고 해서 SQLite 파일 전체의 입출력이 청크 바이트 수와 정확히 같아지는 것은 아니다. 페이지와 트랜잭션 로그는 별도의 층이다.
3. 숫자 비교는 크기·시간·측정 조건을 같은 줄에 놓는다
| 비교 항목 | 단일 JSON + Zstandard BLOB | JSON + Zstandard, 128버전 청크 |
|---|---|---|
| 압축된 과거 본문 | 82,254바이트 | 112,547바이트 |
| 별도 타임스탬프 JSON | 11,001바이트 | 11,008바이트 |
| 압축 정리된 DB | 122,880바이트 | 167,936바이트 |
| 천 번 수정의 총 쓰기 시간 | 약 26.80초 | 약 1.528초 |
| 마지막 25회 수정 지연의 중앙값 | 약 49.904밀리초 | 약 2.196밀리초 |
| 결과 집계 | 단일 실행 | 세 번 실행의 중앙값 |
출처는 동결 커밋의 단일 BLOB 결과와 JSON 청크 세 번 실행 결과다. 마지막 25회 중앙값은 전체 저장 지연의 평균이나 상위 지연 보장이 아니다. 집계 방식도 달라 보편적인 속도 배수로 바꾸지 않았다.
워크로드는 20,000바이트의 결정적 의사 영어 문서에서 시작한다. 작은 교체·삽입·삭제를 천 번 수행하고, 매 50회에는 문단 규모로 바꾼다. 각 수정은 독립 트랜잭션으로 커밋한다. 작성자 환경은 Python 3.13.5와 SQLite 3.46.1이며 WAL 모드, synchronous=NORMAL, 자동 체크포인트 비활성 설정이다. 체크포인트 전 WAL은 쓰기 증폭을 관찰하려는 조건의 결과이지, 정상 운영에서 항상 필요한 디스크 크기라고 단정할 값이 아니다.
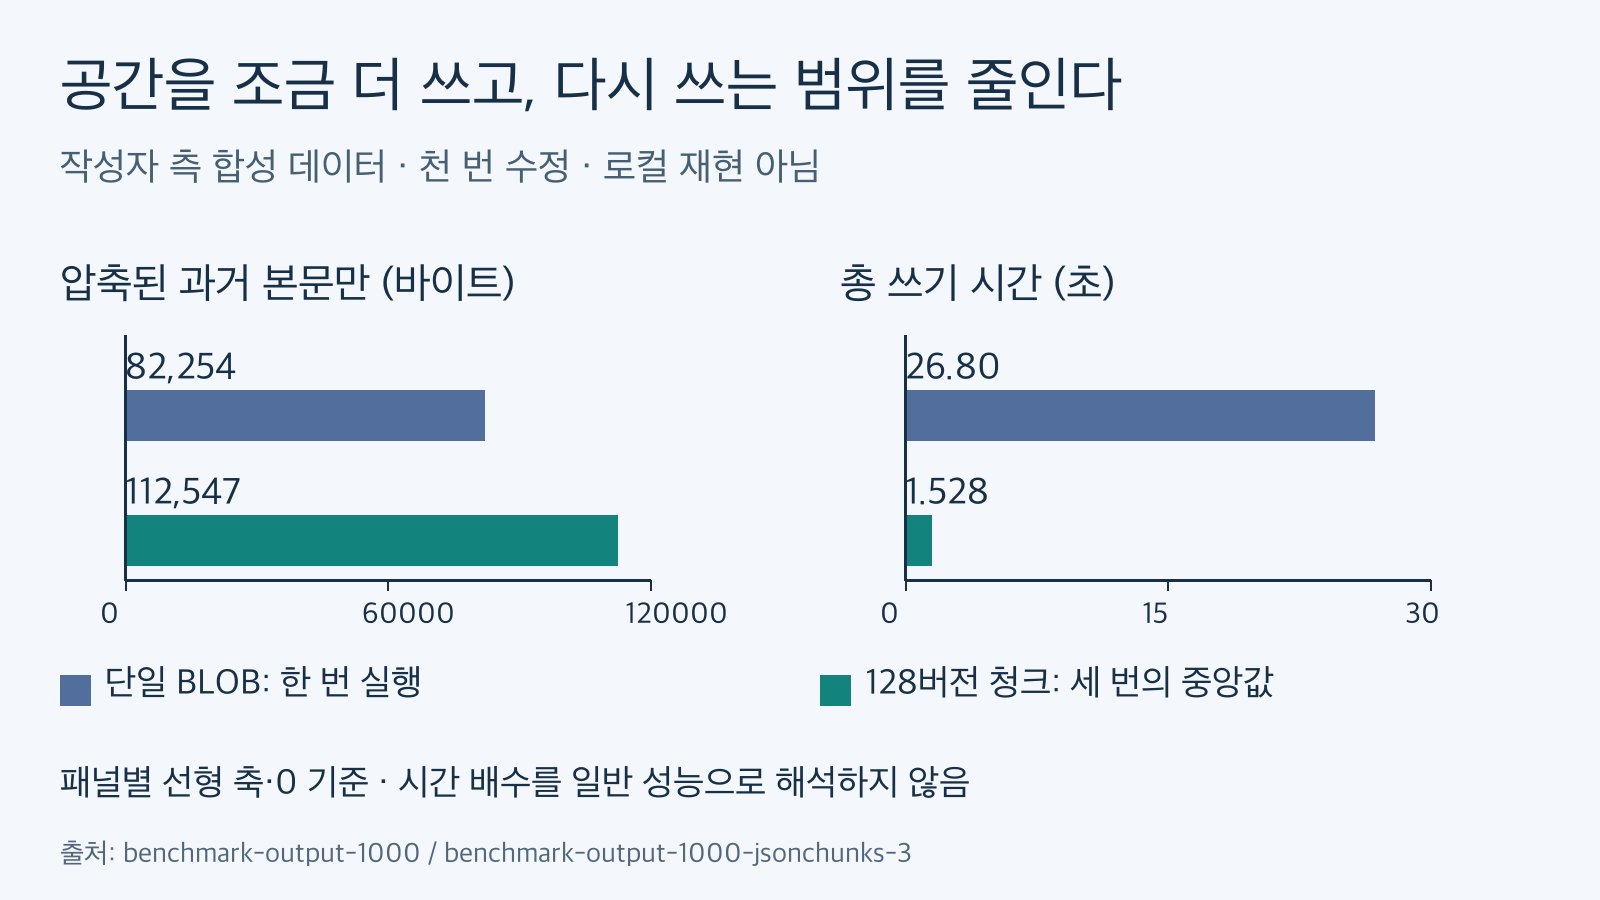
천 번 수정 결과의 압축 본문과 총 쓰기 시간을 별도 0 기준 선형 축으로 비교했다. 단일 BLOB은 한 번, 청크는 세 번 실행의 중앙값으로 집계 조건이 다르다. 출처: github.com/simonw/research/blob/4905e58343b80a01a05144e946b7a6e1618d170a/sqlite-text-history-prototype/REPORT.md.
4. 내 자동저장에 맞추는 선택표
다음 표는 보고서의 권고를 독자의 설계 질문으로 바꾼 편집상 판단 도구다. 실측된 제품별 권장값이나 운영 성능 보장은 아니다.
| 내 요구사항 | 먼저 검토할 방식 | 채택 전에 확인할 것 |
|---|---|---|
| 수정이 드물고 이력도 짧다 | 단일 BLOB | 이력 끝부분에서 재압축 지연을 감당하는가 |
| 저장이 잦고 수천 버전으로 자란다 | 봉인된 JSON 청크 | 활성 청크가 커질 때 저장 지연과 메모리가 어떤가 |
| 과거 한 버전씩 자주 연다 | 청크 | 원하는 버전이 속한 묶음의 복원 비용이 어떤가 |
| 과거 내용 전체를 검색해야 한다 | 압축 이력과 검색 계층을 별도 설계 | 압축 크기 외에 인덱스·보존 정책 비용을 계산했는가 |
핵심은 “128이 정답”이 아니다. 같은 버전 수라도 짧은 메모와 긴 문서는 활성 청크의 원시 바이트 수가 다르다. 보고서는 128버전 또는 원시 JSON 약 2~3MB에서 봉인하는 기준을 제안한다. 하지만 동결된 코드는 revision_count와 chunk_size로 청크 번호를 계산하며, 바이트 한도를 구현하지 않는다. 이를 이미 제공되는 옵션처럼 소개하면 잘못이다. 원문의 짧은 소개보다 실제 코드와 권고를 구별해야 한다.
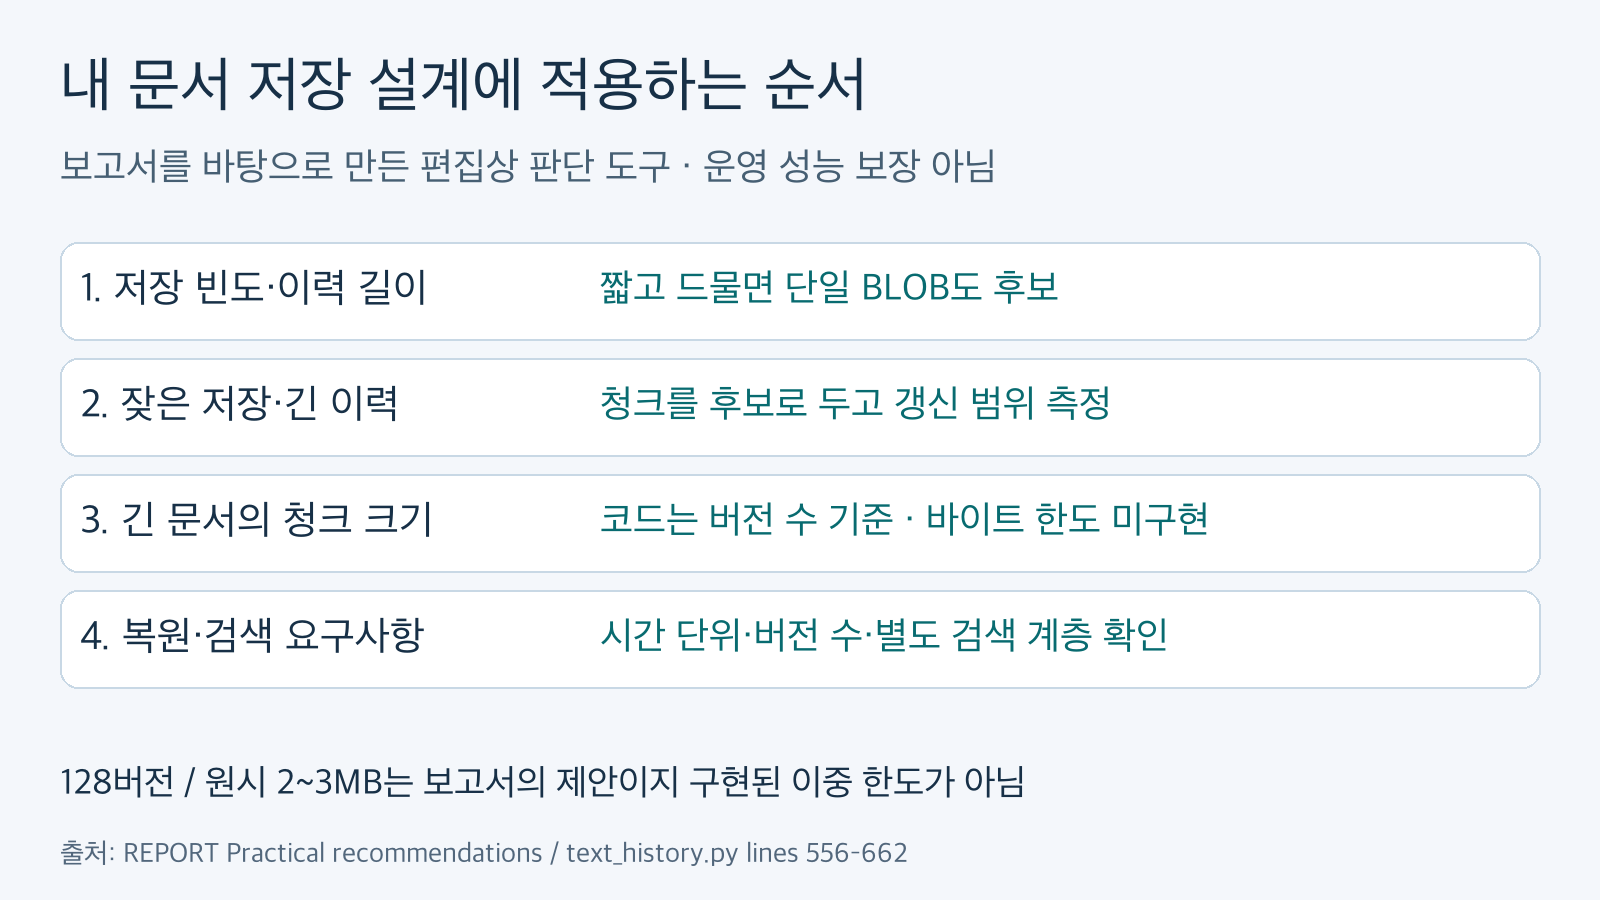
저장 빈도, 갱신 범위, 문서 크기, 복원·검색을 차례로 점검하는 편집상 도구다. 바이트 한도는 보고서 권고이며 현재 코드에 구현돼 있지 않다. 출처: github.com/simonw/research/blob/4905e58343b80a01a05144e946b7a6e1618d170a/sqlite-text-history-prototype/REPORT.md.
5. 도입 전에 확인할 데이터 의미와 복구 경계
저장 경로부터 읽자. replace는 기존 현재 텍스트와 그 버전이 유효해진 시각을 이력에 넣고, 새 텍스트와 시각을 같은 BEGIN IMMEDIATE 트랜잭션 안에서 설치한다. 값이 바뀌지 않은 저장은 기본적으로 건너뛴다. 따라서 단순히 저장 버튼을 누른 횟수와 기록된 버전 수가 항상 같지는 않다. 타임스탬프 정수의 단위도 코드가 초나 밀리초로 강제하지 않으므로 호출 측에서 통일해야 한다.
그다음 복원 경로를 검토하자. 버전 수, 문자열 수, 시각 수의 일치와 청크 경계, 손상 시 오류 처리는 운영 판단의 일부다. 저장 공간만 비교하고 복원 가능성을 확인하지 않으면 작은 파일이라는 장점을 평가할 수 없다. 저장소에는 관련 테스트가 있지만 이 글에서는 실행하지 않았으며, 트랜잭션 구조를 읽었다는 사실을 운영 동시성 감사나 장애 복구 검증으로 바꾸지 않는다.
샘플을 옮겨 실험할 때는 형식도 명시해야 한다. ChunkedHistoryStore.create_document의 기본 format_name은 framed다. 이 글의 JSON 청크 결과와 같은 형식을 검토하려면 format_name="json"을 명시해야 한다. 더 작은 청크가 무조건 이기는 것도 아니다. 묶음을 잘게 나누면 버전 사이 중복을 한 번에 압축하는 범위도 줄어든다. 내 문서 크기와 저장 간격, 과거 조회 빈도에 맞춰 쓰기 지연과 공간을 함께 측정할 문제다.
결론: 압축률은 결과이고, 갱신 경계는 설계다
이 실험을 앱에 적용할 때 가져갈 것은 극적인 압축 숫자 하나가 아니다. 현재 텍스트는 읽기 쉬운 형태로 두고, 과거 이력은 반복 저장 비용을 통제할 단위로 묶는 사고방식이다. 짧고 드문 이력에는 단순한 BLOB을 후보로 남길 수 있다. 자동저장과 장기 이력이 핵심이라면 청크 경계를 먼저 검토하자.
원 저장소는 LLM이 작성한 탐색용 보고서와 코드임을 명시한다. 검증된 배포 패키지나 모든 문서에 통하는 압축률로 받아들일 수 없다. 이 글의 선택표와 도식은 고정된 1차 자료를 읽고 만든 해설이며, 새 실험이나 모델 우월성의 증거가 아니다. 2026년 10월 16일 제작일과 원문 발표일도 구분했다.
출처와 확인 범위
- Simon Willison의 2026년 8월 9일 소개: 아이디어와 천 번 수정 사례.
- README: AI 생성 고지, API 예, 시간 의미.
- REPORT: 측정 조건, 비교와 권고, 한계.
- 구현 코드: 청크 계산, 형식 기본값과 트랜잭션.
후속 수정과 섞이지 않도록 저장소 근거는 커밋 4905e58343b80a01a05144e946b7a6e1618d170a에 고정했다. 관련 글 링크는 이번 패키지에서 본문까지 확인한 적합한 기존 글이 없어 억지로 채우지 않았다.


댓글
댓글 쓰기