한국어 TTS를 영어 순위로 고르지 않기: CER·지연·화자 유사도의 측정 경계
한국어 안내 방송에 쓸 음성 합성 모델을 고른다고 하자. 순위표 첫 화면의 오류율이 낮고 처리 속도도 빠르면 후보가 정해진 것처럼 보인다. 하지만 그 오류율이 영어 문장으로 계산됐고, 속도가 대량 문장 처리량이라면 한국어 이름을 정확히 읽는지, 사용자가 말을 끝낸 뒤 얼마나 기다려야 하는지는 아직 답하지 못했다. 음성이 참조 화자와 비슷하다는 수치도 듣기 편한지와는 다른 질문이다.
Hugging Face가 2026년 9월 30일 발표한 Open TTS Leaderboard는 이런 질문을 여러 측정 축으로 나눠 보여준다. 읽기 쉬운 하나의 종합 점수보다 중요한 것은 지금 보는 열이 무엇을 측정했고 무엇을 측정하지 않았는지다. 이 글은 한국어 서비스 담당자가 순위표에서 후보를 좁히는 판단표와, 결과가 어긋날 때 확인할 순서를 제안한다. 특정 모델을 우승자로 선정하거나 실시간 순위를 전달하는 글은 아니다.
이 글은 공식 발표의 보존본을 해석한 편집자 분석이며, 모델 추론·벤치마크 재실행·사람 청음을 수행한 결과가 아니다. 출처 확인은 보존된 발표 본문과 운영 주체의 Space README에 한정한다. 발표 이후 바뀐 순위나 평가 코드 공개 여부를 확인했다고 주장하지 않는다.
오류율·속도·목소리 유사도는 서로 대체할 수 없다
원문은 intelligibility를 생성 음성의 자동 전사와 입력 문장의 차이로 평가한다. 전사는 Qwen3 ASR을 사용하고, 언어에 따라 단어 오류율 WER 또는 문자 오류율 CER을 보고한다. 이 값은 입력한 말을 음성이 얼마나 전달하는지 살펴보는 대리 지표다. 합성 음성이 정확해도 인식기가 잘못 받아쓸 수 있고, 반대로 받아쓰기에는 문제가 없지만 억양이나 감정이 어색할 수 있다. 따라서 오류율을 사람이 검증한 발음 정확도로 바꿔 말하면 안 된다.
속도에도 두 질문이 있다. RTFx는 실시간 계수의 역수이며, 이 발표의 오프라인 측정은 H200 GPU에서 배치 추론을 수행한다. 대량의 음성 파일을 미리 만드는 작업에서는 처리량을 살펴볼 근거가 된다. TTFA는 재생 가능한 첫 음성이 도착할 때까지 기다리는 시간이다. 대화형 서비스라면 사용자 대기와 더 가까운 질문이지만, 첫 소리가 빨리 나왔다는 사실만으로 나머지 음성이 끊김 없이 전달된다고 결론 낼 수는 없다.
SIM은 생성 음성과 참조 음성의 WavLM 화자 임베딩 사이 코사인 유사도다. 참조 화자의 정체성이 얼마나 유지되는지 추정하는 축이지, 자연스러움이나 선호도 점수가 아니다. 높은 SIM은 복제 동의가 확보됐다는 증거도 아니다. 권한 확인은 모델 성능과 별도로 해야 한다.
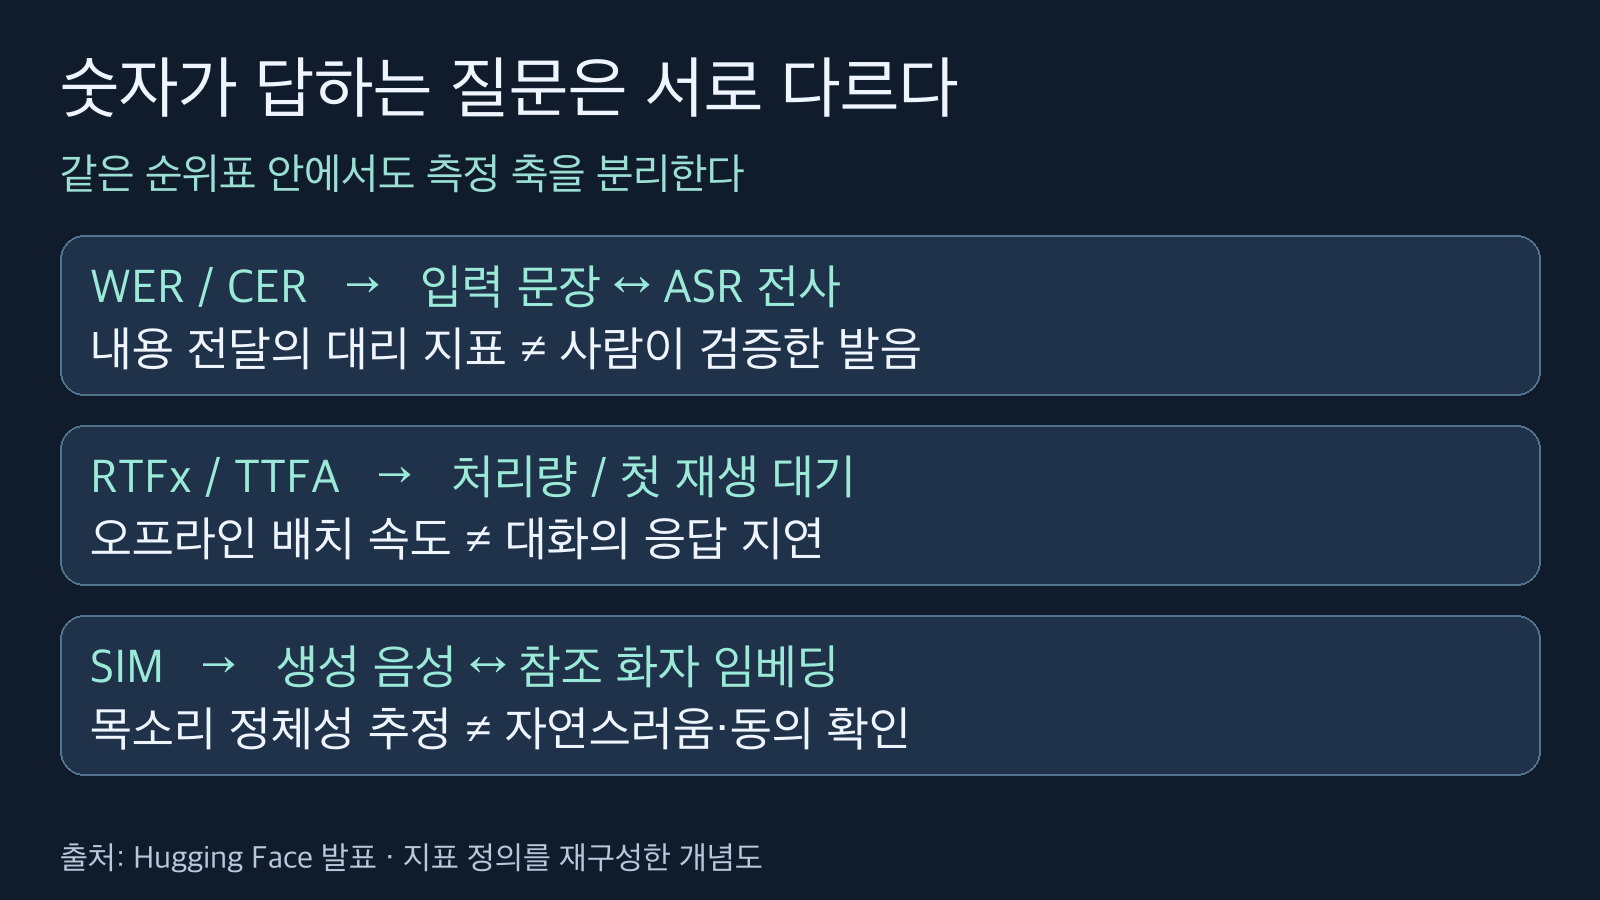
그림 1. 오류율·속도·화자 유사도는 다른 질문에 답한다. 자연스러움과 복제 동의는 이 숫자만으로 확인되지 않는다. 출처: huggingface.co/blog/open-tts-leaderboard.
한국어를 선택하면 비교 대상과 집계 방식도 바뀐다
기본 화면은 Seed TTS Eval과 CV3 Eval의 영어 분할 점수를 매크로 평균한 WER로 정렬한다. 발표는 영어 성능이 다른 언어로 그대로 이어지지 않는다고 명시한다. Seed TTS Eval은 영어와 중국어만 제공하므로, 그 밖의 언어는 CV3 Eval의 zero-shot 평가 점수로 본다. 한국어 후보를 고르는 사람이 영어 기본 순서만 읽으면 언어뿐 아니라 평가 집합의 구성까지 다른 결과를 가져오는 셈이다.
한국어·중국어·일본어에는 CER을 보고한다. 여러 언어를 동시에 선택했을 때 화면의 “Average WER”라는 이름만 보고 한국어도 단어 단위로 합산했다고 이해하면 곤란하다. 원문은 언어별 점수의 매크로 평균이라고 설명하며, 각 언어에 맞는 WER/CER이 들어간다. 모든 언어의 단어를 한데 모아 계산한 오류 비율과는 다르다. 언어별 점수가 평균 뒤에 가려질 수도 있으므로 한국어 서비스의 첫 비교는 한국어 조건으로 제한하는 편이 합리적이다.
음성 복제 여부도 고정해야 한다. Voice cloning을 켜면 선택한 언어에서 그 기능을 지원하는 모델들을 비교하고 SIM 열이 나타난다. 참조 음성 없이 생성한 결과와 참조 음성을 제공한 결과를 한 줄로 이어서 모델 자체가 개선됐다고 해석하지 않는다. 서로 다른 입력 조건에서 관측한 결과일 수 있기 때문이다. 모델명, 언어, 데이터셋, 참조 음성 유무를 함께 기록해야 다음 비교에서 같은 질문을 유지할 수 있다.
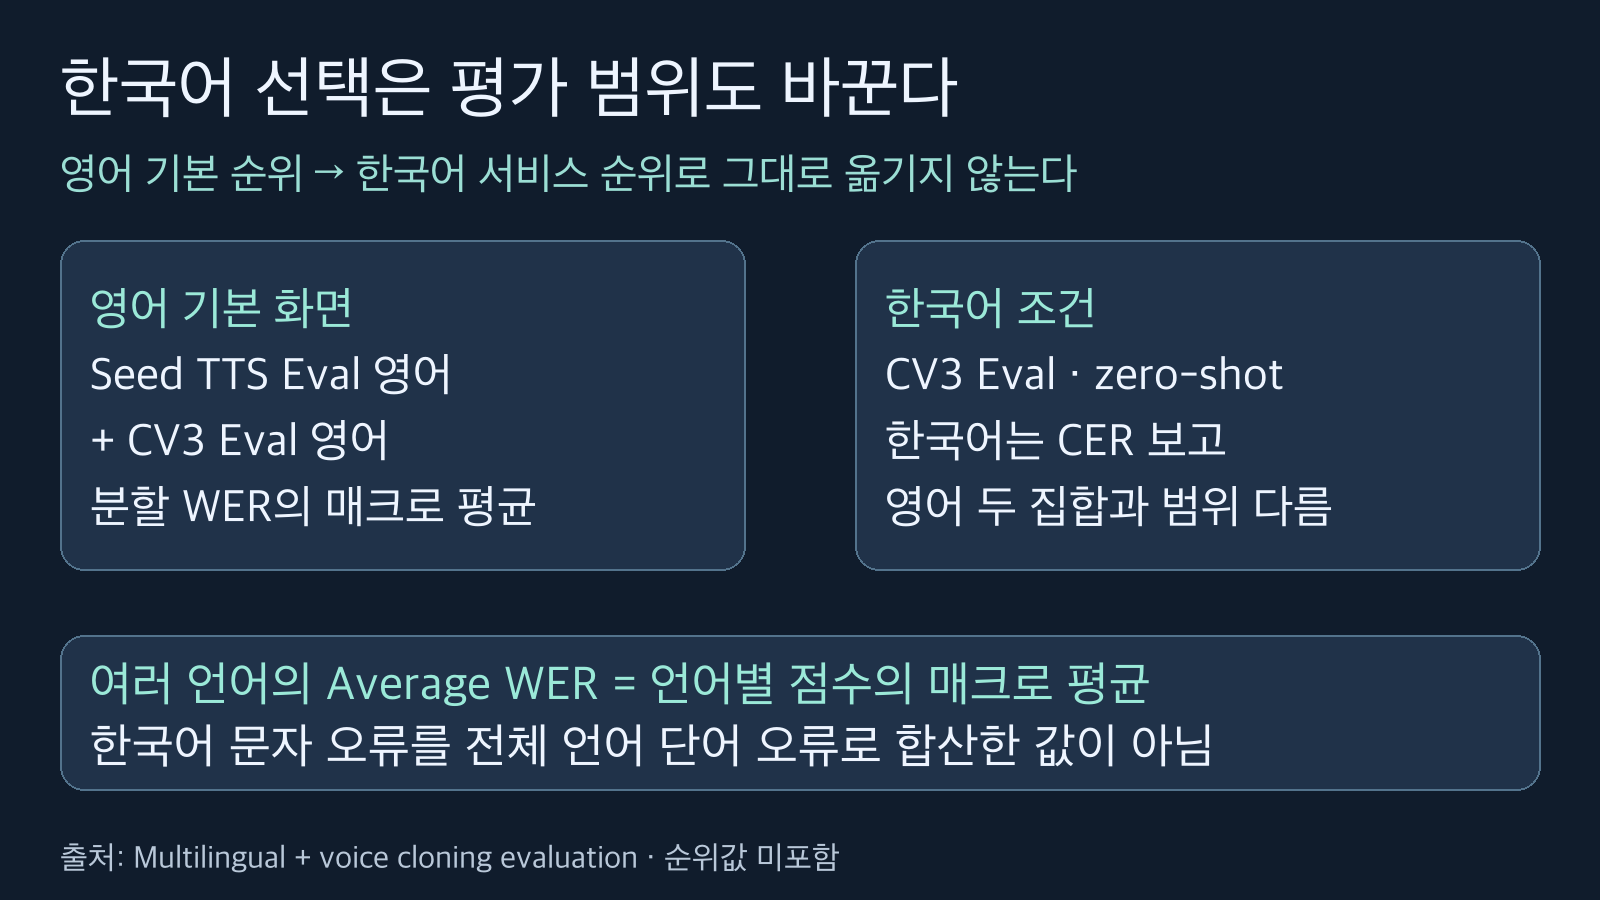
그림 2. 한국어는 CV3 Eval의 CER 조건으로 읽는다. 다국어 Average WER는 언어별 점수의 매크로 평균이며 전체 단어를 합친 비율이 아니다. 출처: huggingface.co/blog/open-tts-leaderboard.
영어 스트리밍 실험이 알려주는 것과 남기는 것
발표의 스트리밍 프로토콜은 같은 CV3-Eval 영어 프롬프트 50개, 배치 크기 1, 같은 하드웨어, 모델 기본 음성을 사용한다. 첫 3회는 워밍업으로 제외하고 나머지 실행의 TTFA 중앙값을 보고한다. 평균이라고 소개하지 않으며, 한국어 문장으로 재측정한 지연이라고도 부르지 않는다. CPU 결과도 있지만 발표 시점에는 제한된 모델 집합이며, 기본 화면은 H200 GPU 비교다.
또 한 가지 경계가 있다. 스트리밍을 지원하는 모델은 첫 오디오 청크가 도착할 때까지 시간을 재고, 비스트리밍 모델은 전체 발화가 생성될 때까지 시간을 잰다. 원문이 설명하는 이유는 비스트리밍에서는 그 전까지 재생을 시작할 수 없기 때문이다. 두 값은 모두 재생 시작까지의 대기를 보여주지만, 내부에서 끝난 작업의 범위는 같지 않다. TTFA만으로 전체 문장 생성 비용까지 같다고 판단할 수 없다.
실제 한국어 대화 서비스를 검토한다면, 이 표는 영어·명시된 장비 조건에서의 후보 축소에 활용한다. 그다음 목표 장비와 한국어 문장으로 첫 재생 시점, 전체 완료 시점, 전달 중 끊김을 별도로 확인하는 실험을 설계한다. 이는 본문에서 도출한 후속 검증 제안이며 여기서 수행한 실험은 아니다. H200 결과를 노트북이나 휴대전화의 지연 보장으로 바꾸지 않는 것이 핵심이다.
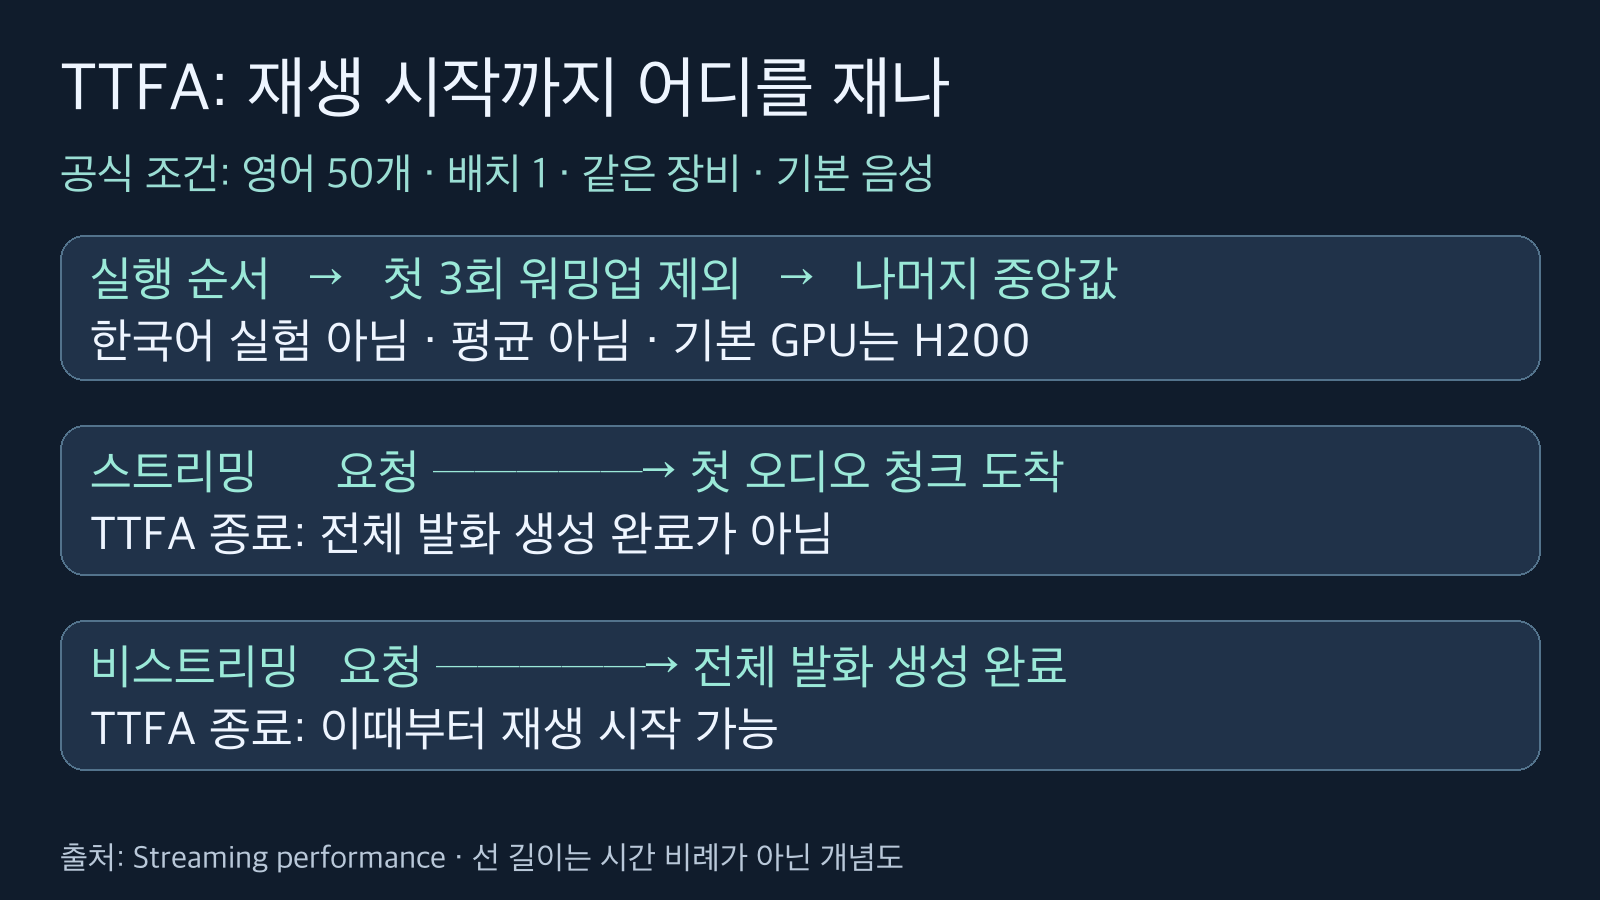
그림 3. 공식 TTFA 프로토콜은 영어 조건이며 한국어 실험이 아니다. 화살표 길이는 시간 비례가 아닌 개념 표현이고 평균이 아닌 중앙값을 보고한다. 출처: huggingface.co/blog/open-tts-leaderboard.
사용 목적에 따라 먼저 볼 열을 고르는 판단표
한국어 안내문이면 한국어 CER을 먼저 확인하고, 대화형 서비스이면 별도로 TTFA의 언어·하드웨어·스트리밍 조건을 확인한다. 아래 표는 원문 지표 정의를 사용 목적에 연결한 편집자 제안이다. 점수 임계값이나 합격 모델 목록이 아니라, 어떤 증거가 더 필요한지 정하는 표다.
| 사용 목적 | 먼저 확인할 조건과 지표 | 아직 답하지 못한 질문 | 후속 확인 제안 |
|---|---|---|---|
| 한국어 안내·접근성 읽기 | 한국어 선택, 동일 복제 모드, CER | 고유명사·금액·날짜를 의도대로 읽는가 | 실제 업무 문장과 입력·전사를 대조하고 중요한 발음을 직접 확인 |
| 실시간 한국어 대화 | TTFA, 장비, 배치 1, 스트리밍 여부 | 영어 지연이 한국어에도 유지되는가, 음성이 계속 잘 전달되는가 | 목표 환경에서 첫 재생·전체 완료·끊김을 따로 기록 |
| 대량 오디오 사전 제작 | 오프라인 배치 조건과 RTFx | 해당 장비·문장 길이에서도 처리량이 유지되는가 | 작업 부하에 맞춘 처리량 확인과 품질 검사를 병행 |
| 승인된 참조 화자 복제 | 지원 언어·모델, 복제 모드, SIM과 CER | 닮은 음성이 자연스럽고 사용 권한도 확보됐는가 | 권한 증빙을 분리하고, 말의 내용과 청취 품질을 각각 확인 |
이 표의 장점은 서로 다른 숫자를 한 점수로 합치지 않는 데 있다. 예를 들어 SIM이 높지만 CER이 나쁘다면 화자 정체성 추정과 내용 전달이 다른 방향으로 움직인 것이다. CER이 낮지만 듣기 부담스럽다면 객관 지표가 놓치는 자연스러움·표현력 쪽을 확인한다. 처리량이 좋아도 첫 소리가 늦다면 미리 생성하는 서비스와 대화형 서비스의 선택이 달라질 수 있다. 어느 경우도 이 글이 특정 모델에서 실제 관측한 현상은 아니며, 지표 정의에서 나온 진단 분기다.
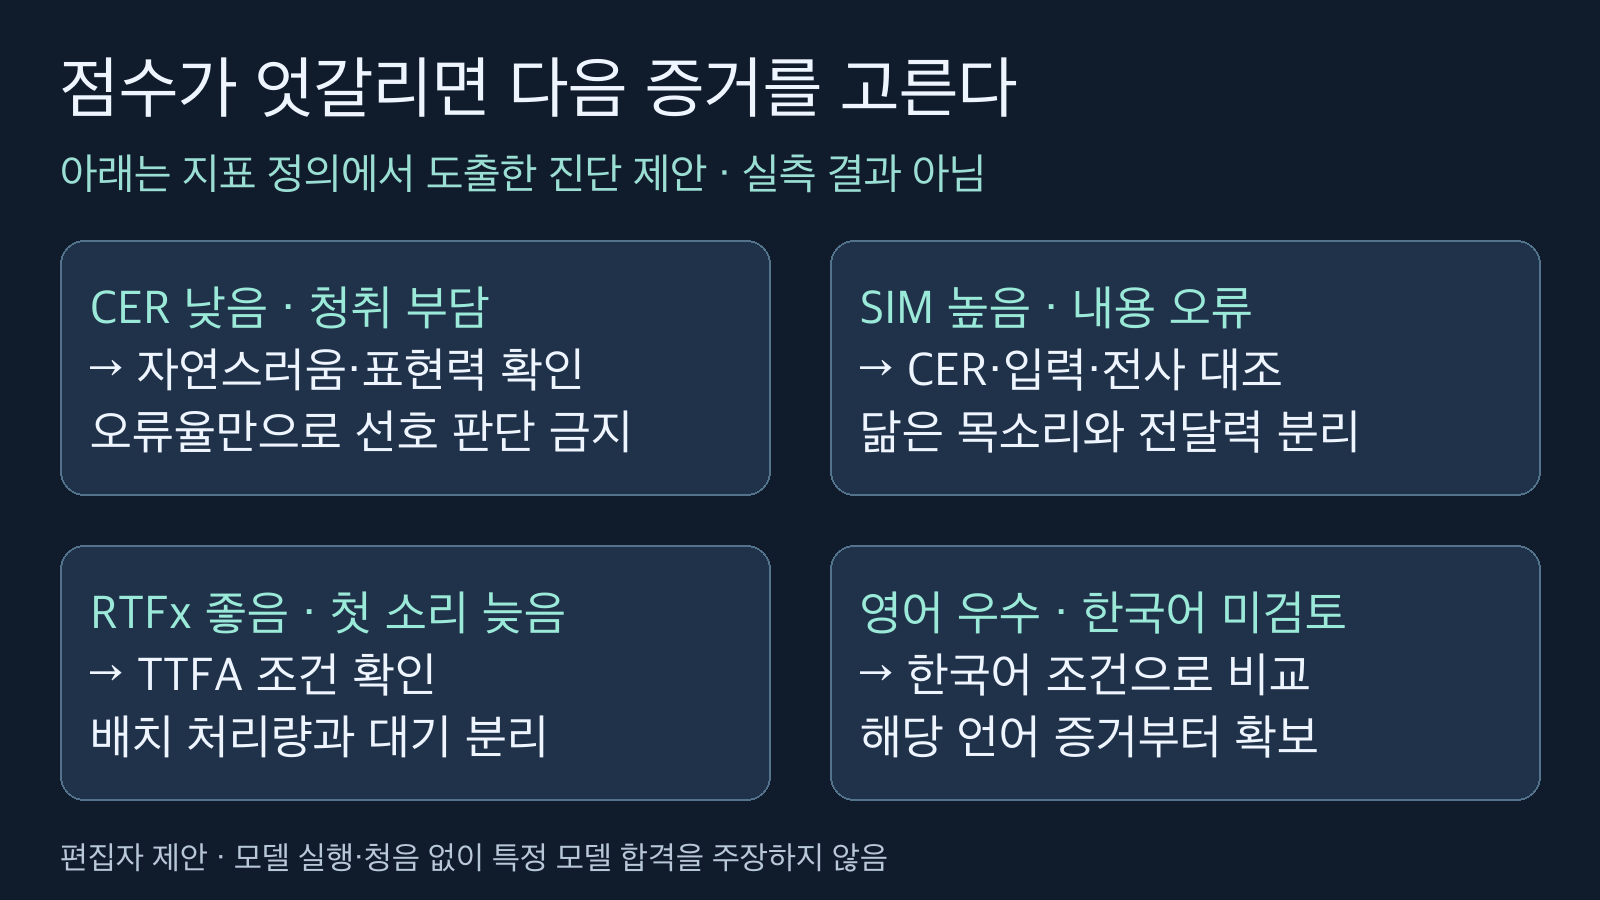
그림 4. 지표 정의에서 도출한 편집자 진단 분기다. 네 상황은 실제 모델 관측값이나 합격 판정이 아니며 후속 검증을 고르는 예시다. 출처: huggingface.co/blog/open-tts-leaderboard.
비교 기록에는 점수보다 조건을 먼저 남긴다
후보를 좁힌 뒤에는 Listen 탭에서 관심 언어와 데이터셋, 복제 여부를 맞춰 출력 음성을 비교할 수 있다. 원문도 수치가 이야기의 일부만 보여주며 인간 선호 순위를 대체하지 않는다고 설명한다. 업무용 검토에서는 한 번의 좋은 샘플만 고르기보다, 자주 등장하는 한국어 이름·제품명·단위·숫자 표현이 포함된 문장 집합을 먼저 고정하는 방법을 제안한다. 이 문장 집합은 새 벤치마크의 정확도를 보증하는 장치가 아니라, 팀이 비교 대상과 실패 사례를 잃지 않기 위한 기록 방법이다.
기록에는 모델·언어·데이터셋·복제 모드·참조 음성·장비·생성 설정을 남기고, 오류율과 첫 재생 지연, 전체 완료 시간, 청취 메모를 다른 칸에 둔다. 전사가 이상하다면 입력 텍스트와 생성 음성을 먼저 보존하고, 합성 문제인지 인식 문제인지 구분한다. “순위가 낮다”는 결론보다 “어떤 조건에서 어떤 증거가 부족했다”는 기록이 다음 선택에 더 도움이 된다. 사람 청취를 하지 않았다면 그 칸은 미검토로 남겨야 한다.
재현 가능성에도 경계가 있다. 발표의 결론은 평가 스크립트를 곧 공개하겠다는 예고다. 운영 Space의 README가 WER·RTFx·SIM과 두 평가 집합을 설명한다고 해서 전체 평가 코드와 데이터를 내려받아 지금 재현할 수 있다고 말하지 않는다. 이 글의 근거는 보존된 발표 시점이다. 실제 도입 검토에서는 당시 사용할 코드 버전과 데이터 접근 조건을 별도로 확인해야 한다.
결국 Open TTS Leaderboard는 한국어 음성의 최종 승자를 알려주는 표라기보다, 내용 전달·처리량·재생 시작·화자 정체성을 구분해서 볼 출발점이다. 한국어 조건을 먼저 맞추고, 서비스 목적에 필요한 지표를 고른 뒤, 표가 측정하지 않은 것을 후속 검증으로 남기는 것이 영어 기본 순위를 그대로 따르는 것보다 안전한 사용법이다.
출처와 검토 범위
- Hugging Face 공식 발표: Open TTS Leaderboard — 객관 지표 정의, 다국어·음성 복제, Listen, Streaming, Conclusion. 2026년 9월 30일 발표 보존본을 사용했다.
- hf-audio 운영 Space README — 같은 순위표의 목적과 WER·RTFx·SIM을 확인한 보존본이다. main의 당시 스냅샷이며 변경 불가능한 업스트림 버전이나 실시간 순위 증거는 아니다.
고정 순위·개별 모델 점수·추론 실행·사람 청음 결과는 포함하지 않았다. 기존 글 중 이 한국어 TTS 평가 질문을 직접 심화하는 관련 글은 보존된 중복 검토에서 확인되지 않아, 이름만 비슷한 에이전트 추론이나 아바타 글을 관련 링크로 붙이지 않았다.


댓글
댓글 쓰기