Ultrafast 요청과 실제 처리 티어는 다르다: AI Gateway 요금·지역 확인법
대화형 코딩 도구에서 응답을 기다리는 시간이 길면 더 빠른 처리 티어를 켜고 싶어진다. 하지만 요청에 ultrafast를 넣었다는 사실과 실제로 그 티어에서 처리됐다는 사실은 다르다. 이 둘을 합쳐 기록하면 기본 티어로 처리된 요청까지 비싼 티어의 성능 표본으로 섞이거나, 비용을 잘못 예상할 수 있다. 도입의 출발점은 빠르다는 홍보 문구가 아니라 요청·지역·응답·요금을 연결하는 관측 설계다.
Vercel의 2026년 10월 8일 공지는 AI Gateway에서 OpenAI Ultrafast를 지원한다고 알렸으며 GPT 6 Astra와 GPT 6.1 Sol을 대상 모델로 명시했다. 이는 Gateway 연동 공지이지 두 모델의 최초 출시를 뜻하지 않는다. 함께 보존한 서비스 티어 문서의 Ultrafast 절에는 Astra만 적혀 있다. 따라서 Sol 지원은 더 새로운 공지에 근거해 설명하되, 특정 계정에서 호출이 성공한다거나 모든 경로에서 즉시 사용할 수 있다고 단정하지 않는다. 공식 연동 공지
이 글은 보존한 Vercel 공식 본문을 바탕으로 작성한 운영 판단 자료다. 실제 모델 호출, 계정별 가용성 확인, 지연시간 측정, 청구서 대조는 수행하지 않았다.
1. 설정 필드부터 나눈다: OpenAI 옵션과 Gateway 옵션
AI SDK에서는 providerOptions.openai.serviceTier에 ultrafast를 지정한다. 서비스 티어 문서는 이 제공자별 옵션에 AI SDK 6 이상이 필요하다고 적고 있다. 원시 Chat Completions와 Responses 요청에서는 service_tier를 사용한다. 비슷한 이름의 통합 옵션 providerOptions.gateway.serviceTier에 Ultrafast를 넣는 방식은 지원되지 않는다. 문서는 통합 옵션이 flex, priority, fast를 받으며 다른 값을 거부한다고 설명한다. 이름만 보고 옵션을 바꿔 넣지 않아야 한다. 서비스 티어 문서
공식 공지의 SDK 예시는 openai/gpt-6.1-sol을 모델로 쓰고 providerOptions.openai.serviceTier를 설정한다. 예시의 gateway.only: ['openai']는 제공자 경로를 제한하는 설정이고, Ultrafast 자체를 지정하는 필드가 아니다. 운영 설정을 검토할 때는 모델 식별자, 제공자 제한, 처리 티어를 각각 확인해야 한다. 아래 그림은 옵션 경로를 설명하기 위한 원본 도식이며 실제 실행 화면이 아니다.
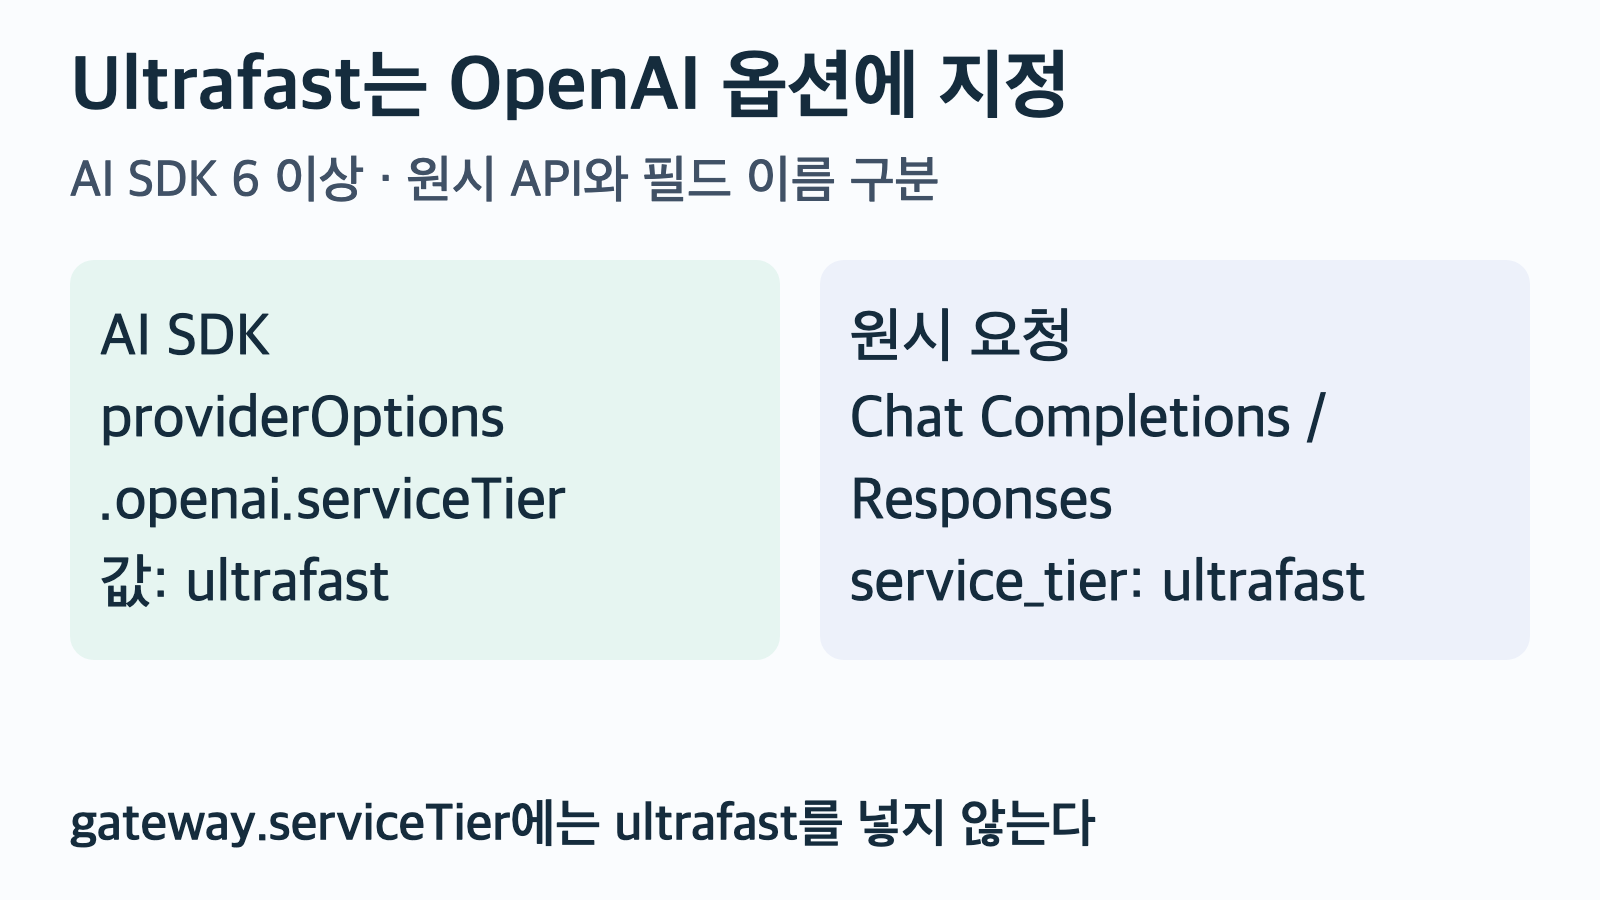
Ultrafast는 OpenAI 제공자별 옵션에 설정한다. 통합 gateway.serviceTier는 ultrafast를 받지 않는다. 실제 호출 화면이 아닌 설정 경로 도식이다. 출처: vercel.com/docs/ai-gateway/models-and-providers/service-tiers.
2. 지역 제약을 속도 옵션보다 먼저 확인한다
공지는 Ultrafast가 US 및 global 처리를 지원하며, EU처럼 지원하지 않는 지역으로 고정한 요청은 표준 default 티어로 처리된다고 설명한다. Ultrafast를 적었다는 이유로 EU 고정 요청도 그 티어로 실행될 것이라고 예상하면 안 된다. 반대로 빨라지지 않았다는 이유로 필요한 지역 제한을 제거하는 것도 적절하지 않다.
여기서 지역 고정과 데이터 레지던시 충족은 같은 확인 항목이 아니다. 공지에 나온 처리 가능 지역만으로 조직의 보관·전송·처리 요건을 모두 충족한다고 결론 낼 수 없다. 필수 EU 제한이 있다면 그 제한을 유지한 상태에서 기본 티어를 전제로 계획하고, 별도의 정책 검토 없이는 지역 설정을 느슨하게 바꾸지 않는 것이 이 글의 편집상 권고다.
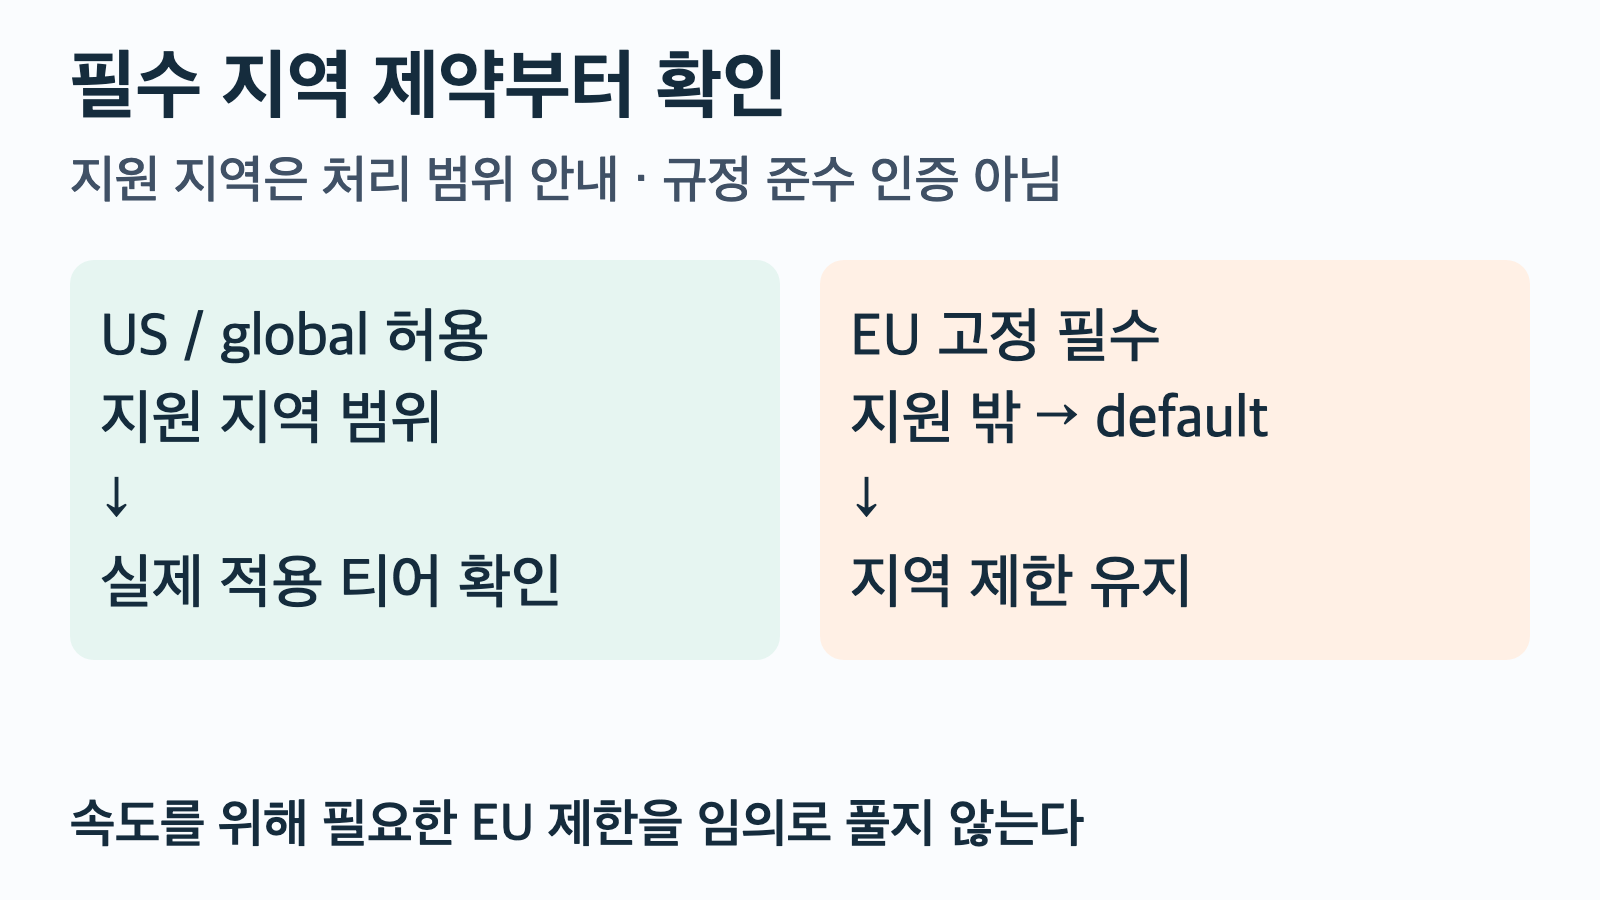
지원 지역 설명과 규정 준수 판단은 별개다. EU 고정 요청의 default 처리는 공식 설명이며 필수 제한 유지는 이 글의 운영 권고다. 출처: vercel.com/changelog/openai-ultrafast-mode-now-available-on-ai-gateway.
| 현재 제약 또는 관측 | 공식 근거로 말할 수 있는 것 | 다음 판단 |
|---|---|---|
| US/global 처리가 허용됨 | Ultrafast의 지원 지역 범위에 들어간다 | 요청 후 적용 티어를 확인한다. 성공·속도 보장은 아니다 |
| EU 고정이 필수임 | 해당 고정 요청은 default 처리 대상이다 | 지역 제한을 유지하고 기본 티어를 기준으로 계획한다 |
| 처리 지역 요건이 불명확함 | 지원 지역 문구만으로 규정 준수를 판단할 수 없다 | 먼저 조직의 처리·레지던시 조건을 확인한다 |
| Ultrafast를 요청했지만 응답 메타데이터가 없음 | 요청 값만으로 실제 적용 티어를 증명할 수 없다 | 요청 로그를 확인하고 미확인 요청을 분리한다 |
3. 6배의 분모는 속도가 아니라 토큰 단가다
공지는 실제로 Ultrafast에서 처리된 요청에 표준 토큰당 요금의 6배를 적용한다고 설명한다. 다른 티어로 처리된 요청은 실제 적용된 티어의 요금을 따른다. 따라서 ‘Ultrafast를 요청했으니 모든 요청에 6배를 적용한다’는 계산도, ‘6배 요금이니 6배 빠르다’는 해석도 근거가 없다. 이 배율은 같은 모델의 표준 토큰당 단가를 기준으로 읽어야 하며, 고정 달러 가격이 아니다.
아래 도식은 표준 단가를 1로 정규화한 상대 비교다. 달러 견적도 실측 비용도 아니다. 입력·출력 등 실제 청구 항목의 단가와 사용량을 확인해야 작업 비용을 산정할 수 있다. 도구 호출, 재시도, 출력 길이처럼 작업 전체에 영향을 주는 요소도 있으므로 토큰 단가 배율을 전체 워크플로 비용의 확정 배율로 옮겨 적지 않는다. 실제 단가는 공지가 연결한 모델 가격 안내에서 별도로 확인해야 한다. 이 글은 최신 달러 단가를 추정해 넣지 않았다.
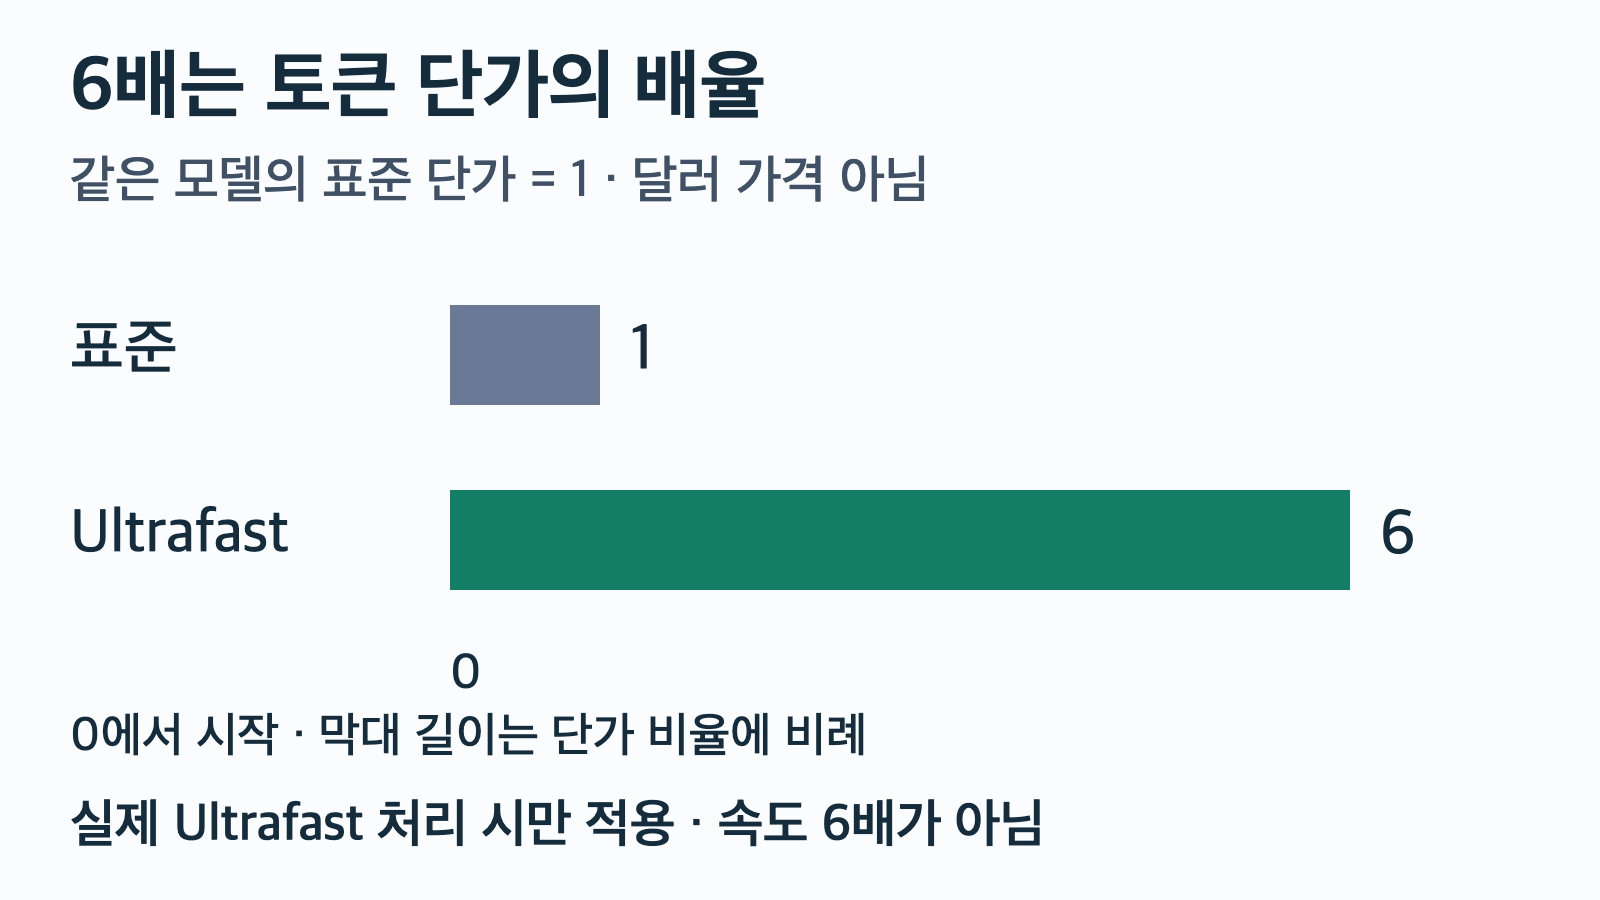
동일 모델 표준 토큰당 단가 대비6배를 정규화한 비교다. 달러 가격·전체 작업 비용·속도의6배를 뜻하지 않으며, 실제 Ultrafast 처리에 적용된다. 출처: vercel.com/changelog/openai-ultrafast-mode-now-available-on-ai-gateway.
비용 비교를 준비할 때 요청 설정값만으로 표본을 묶지 말고 실제 처리 티어별로 나눈다. 같은 모델·비슷한 작업 조건에서 사용 토큰과 관측 지연시간을 함께 남겨야 추가 요금이 독자의 대기시간 문제를 해결했는지 판단할 수 있다. 이는 향후 측정 설계 제안이며, 이 글에서 벤치마크를 수행했다는 뜻은 아니다.
4. 응답 필드가 없을 때의 진단 순서
서비스 티어 문서는 요청 티어를 최선 노력 방식의 라우팅 힌트로 설명한다. 제공자가 요청한 티어를 부여하지 않으면 기본 티어로 처리할 수 있고, 티어 설정이 제공자 오류를 막거나 요청 성공을 보장하지도 않는다. 설정 화면에 Ultrafast가 표시되는 것만으로 운영 결과를 판단해서는 안 된다.
AI SDK의 적용 티어 확인 경로는 providerMetadata.gateway.serviceTier다. 호환 원시 API 응답의 Gateway 메타데이터는 provider_metadata.gateway.serviceTier이며, OpenAI 호환 응답에는 service_tier도 포함될 수 있다. 스트리밍에서는 스트림이 완료된 뒤 기다려 얻는 결과의 메타데이터를 읽는다. 요청의 service_tier와 응답의 같은 이름 필드를 섞어 쓰지 않도록 기록의 방향을 명시한다.
문서는 제공자가 표준 티어를 보고하면 Gateway의 티어 필드를 생략한다고 설명한다. 동시에 클라이언트가 제공자 메타데이터 자체를 누락할 수도 있다고 경고한다. 따라서 필드가 없다는 사실만으로 Ultrafast가 실행됐다고도, 클라이언트에서 관측한 모든 요청이 반드시 default라고도 단정하지 않는다. 요청 로그로 확인하는 경로를 남겨야 한다.
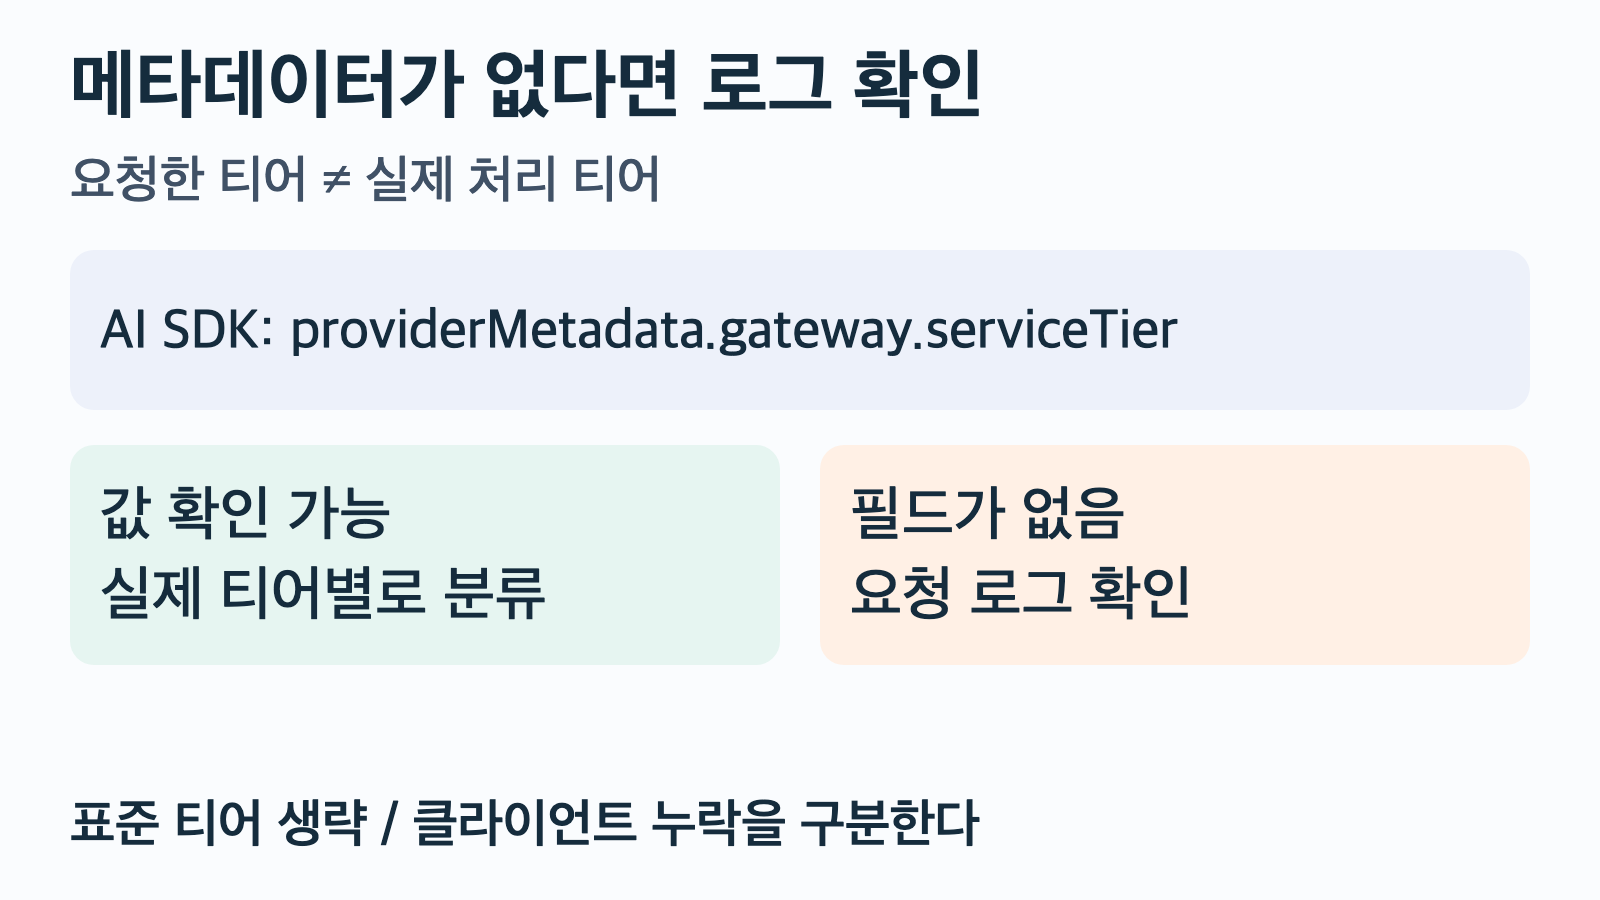
표준 티어에서는 필드가 생략될 수 있고 클라이언트가 메타데이터를 누락할 수도 있다. 요청값만으로 실제 티어를 확정하지 않는다. 실행 로그가 아닌 진단 절차다. 출처: vercel.com/docs/ai-gateway/models-and-providers/service-tiers.
실제 운영에 적용할 진단 순서는 다음과 같다. 이 순서는 공식 응답 필드와 제약을 바탕으로 작성한 독자용 절차다.
- 모델과 사용 SDK 버전을 확인하고 올바른 제공자별 옵션 또는 원시 요청 필드를 썼는지 점검한다. 통합 Gateway 옵션과 중복해 적지 않는다.
- 필수 지역 제한을 확인한다. EU 고정이 있다면 이를 먼저 기록하고 속도 설정 때문에 몰래 제거하지 않는다.
- 요청 티어와 실제 처리 티어를 서로 다른 기록 항목으로 남긴다. 실제 처리 티어를 확인하지 못했다면 비용·속도 비교에서는 미확인 표본으로 분리한다.
- 메타데이터가 없으면 요청 로그를 확인한다. 본문이나 프롬프트 전체를 무조건 저장하는 대신 팀의 개인정보·비밀정보 보존 정책에 맞춰 진단에 필요한 항목을 정한다.
- 실제 처리된 티어와 사용량을 요금 판단에 연결한다. 처리 티어가 불명확한 상태에서는 Ultrafast 적용 비율이나 추가 요금을 확정 보고하지 않는다.
요청 티어, 실제 처리 티어, 모델, 지역 제한, 토큰 사용량, 관측 지연시간을 구분해 두면 ‘옵션을 켰는데 왜 효과가 없지?’라는 질문을 설정 오류·지역 fallback·관측 누락·실제 성능 차이로 나눠 조사할 수 있다. 위 항목은 작성자가 제안한 기록 구조이지 공급자가 보장하는 자동 로그 필드 목록은 아니다.
5. 잦은 도구 호출은 연결 오버헤드와 따로 본다
공지는 도구를 자주 호출하는 워크플로에서 지속 WebSocket 연결을 사용하는 Responses API를 권고한다. 목적은 턴 사이의 오버헤드를 줄이는 것이다. 더 높은 처리 티어를 선택하는 것과 연결을 재사용하는 것은 서로 다른 조정 수단이다. 티어를 바꿨는데도 전체 대기가 길다면 모델 출력 시간 외에 턴 사이 연결 비용도 조사할 후보가 된다.
다만 보존한 근거에는 이 변경의 실측 지연시간, 개선율, 독자의 환경에서의 손익분기점이 없다. WebSocket을 도입하면 반드시 일정 비율 빨라진다는 문장을 붙이지 않는다. 먼저 실제 처리 티어를 관측할 수 있는 작은 호출 경로를 만들고, 그다음 연결 방식의 변화와 티어 변화를 분리해 비교하는 편이 원인을 해석하기 쉽다는 것이 이 글의 권고다.
결국 Ultrafast 도입의 질문은 ‘더 빠른 옵션이 있나?’에서 끝나지 않는다. 내 지역 제약에서 사용할 수 있는지, 실제 어떤 티어에서 처리됐는지, 추가 토큰 단가가 대기시간 문제를 해결하는지 순서대로 확인해야 한다. 요청한 값보다 실제 처리 결과를 기준으로 운영 기록과 비용 판단을 연결하자.
출처와 확인 범위
- Vercel 연동 공지 — 2026년 10월 8일: 대상 모델, SDK 요청 예시, US/global 및 EU fallback, 실제 Ultrafast 처리 시 표준 토큰당 단가 대비 6배, 지속 WebSocket 권고.
- Vercel AI Gateway Service Tiers: 제공자별 설정, AI SDK 6 이상 조건, 통합 옵션의 허용값, 최선 노력 라우팅, 적용 티어 메타데이터와 요청 로그 확인.
공식 본문은 2026년 10월 9일 오전 수집·검증 시점의 보존본을 사용했다. 이후 변경을 확인한 실시간 제품 안내가 아니라 해당 근거에 묶인 분석이다. 제공자의 설명과 이 글의 운영 권고를 구분했으며, 독립적인 모델 성능 검증은 포함하지 않는다.


댓글
댓글 쓰기