AI 테스트가 없는 모듈을 부르지 못하게 하려면: CBDL의 import 제약과 남는 오류
AI가 만든 테스트가 본문에 들어가기 전에 존재하지 않는 모듈이나 잘못된 클래스 경로를 import하다 멈춘다면, 오류 메시지를 다시 보내는 것만이 해법일까? 여기서 다루는 것은 ‘테스트가 없는 모듈’을 금지하는 정책이 아니라, 테스트 실행 환경에 없는 이름을 생성하지 못하게 하는 문제다. CBDL은 환경에서 추출한 허용 import를 생성 과정에 연결한다. 그러나 import가 유효하다는 보장과 테스트가 버그를 잡는다는 보장은 전혀 다르다.
먼저 결과의 크기를 보자. 논문의 Java GPT-OSS F→P 초기 생성 조건에서 기능적으로 올바른 테스트는 비제약 생성 34/103개, CBDL 38/103개였다. import 오류가 사라졌다는 결과를 103개 테스트가 모두 정확해졌다는 뜻으로 읽으면 안 된다. 이 글의 목적은 반복 수리 횟수를 늘리기 전에 어떤 실패를 생성 제약으로 옮길 수 있고, 무엇을 실행 검증으로 남겨야 하는지 구분하는 것이다.
2026년 10월 30일 제출된 arXiv v1 「No More Import Errors: Constrained Decoding for Guaranteed Valid Imports in LLM-Generated Tests」가 기준이다. 검토한 기록만으로 동료심사 통과를 확인하지 않았다. 이 글은 논문 본문과 표를 검토한 해설이며 CBDL 구현이나 모델 실험을 독립 재현한 결과가 아니다.
1. 프롬프트에 목록을 넣는 것과 선택지를 막는 것은 다르다
논문의 CBDL은 Constrained Beam Decoding with Lookup의 약자다. Java와 Python 실행 환경에서 허용 가능한 import 문장을 추출하고, 생성 모델이 잘못된 이름을 선택할 때 이를 교정하거나 제약한다. 프롬프트로 ‘있는 모듈만 써라’고 부탁하는 것이 아니라, 디코딩 단계에서 허용되지 않는 토큰의 확률을 막는 방식이다.
동작 순서를 단순화하면 다음과 같다. 먼저 일반 생성으로 import를 시도한다. 잘못된 경로지만 클래스 이름이 추출 목록의 다른 패키지에 존재하면 lookup으로 패키지 접두부를 교정한다. 해결되지 않으면 잘못된 import를 버리고 constrained beam decoding으로 넘어간다. import 영역에서는 여러 후속 후보를 보존하고, 본문으로 넘어간 뒤에는 비제약 생성을 계속한다. 기본 beam 크기는 2다. 따라서 전 문장에 동일한 제약을 거는 방식도, 모든 상황에서 처음부터 beam search를 쓰는 방식도 아니다. [근거: §IV-A–F, §V]
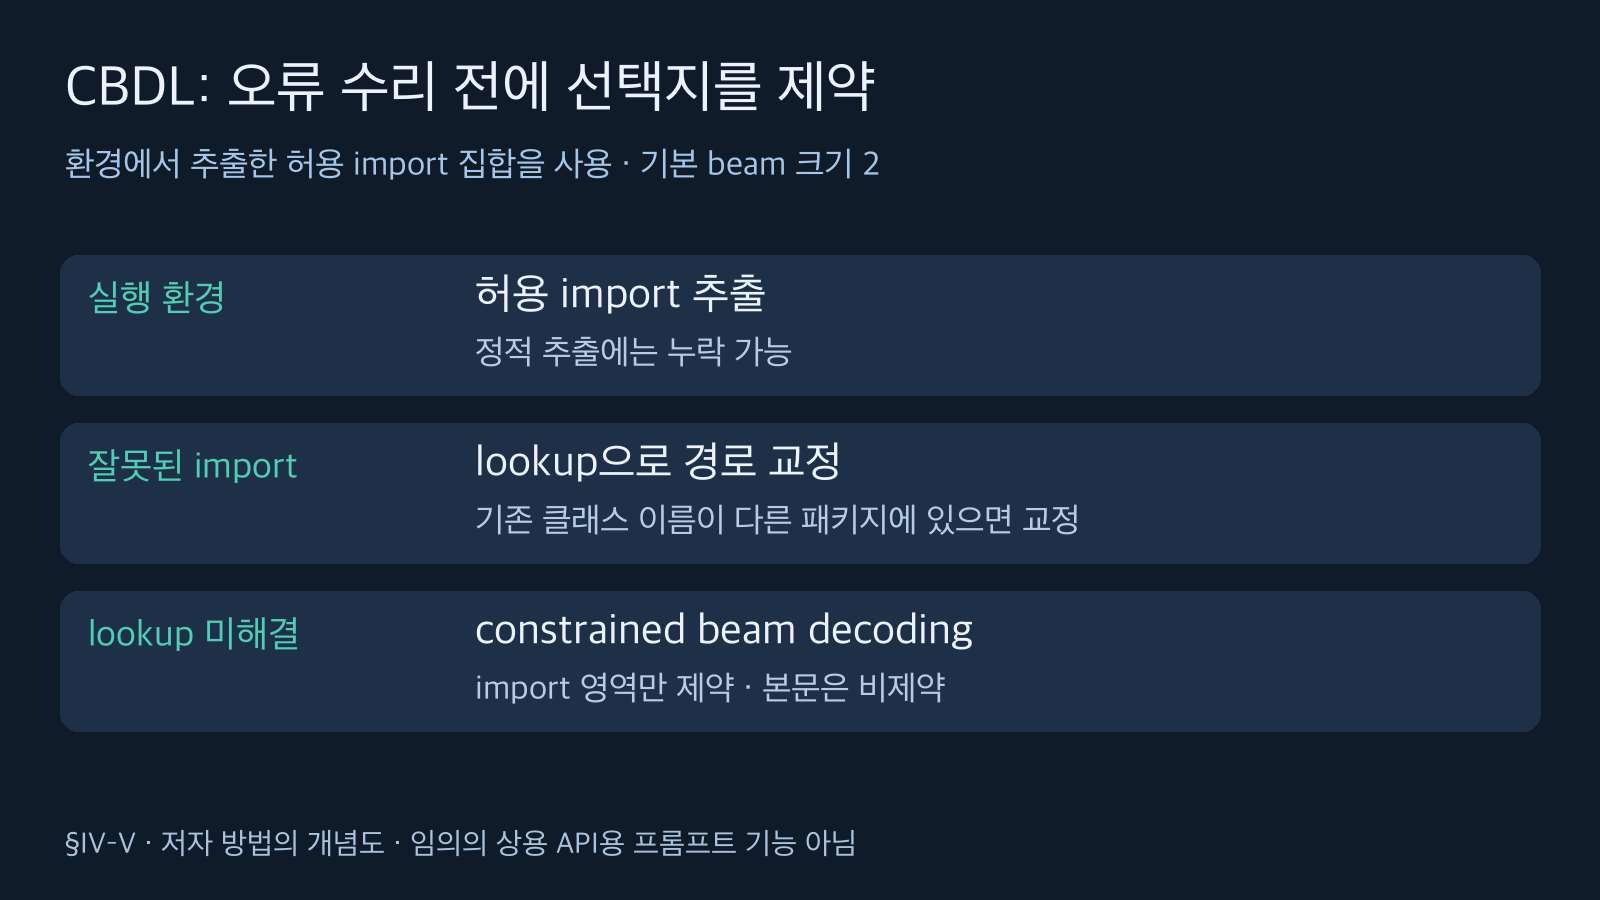
환경 목록, lookup, beam 제약은 서로 다른 역할이다. 본문 의미의 정확성까지 제약하지 않는다. 출처: arxiv.org/abs/2610.41878v1.
이 구분은 도입 가능성을 결정한다. 연구 구현은 llama.cpp completion API를 수정해 토큰별 허용 여부를 제어하고 Python 클라이언트가 후보를 계산한다. 실행 환경에 대한 정적 접근과 모델의 logits 제어가 필요하므로, 임의의 상용 API에 프롬프트 한 줄을 더해서 같은 보장을 얻는 기능으로 소개할 수 없다.
또한 허용 목록은 환경 자체의 완벽한 사본이 아니다. 논문의 Python 정적 추출은 C 확장이나 동적 export를 놓칠 수 있다. Java의 단일 static member import는 static wildcard 형태로 다룬다. ‘추출된 허용 집합 안에 있다’는 성질과 ‘실제 작업에 필요한 이름을 빠짐없이 담았다’는 성질을 분리해야 한다. 환경이나 의존성이 바뀌면 목록의 최신성도 별도 점검 대상이다. 마지막 문장은 이 구조에서 도출한 운영상 판단이지, 논문이 측정한 갱신 비용이 아니다.
2. 오류 0과 생성 종료, 기능적 정답을 따로 읽기
Table II에서 CBDL의 import 오류는 로컬 모델·작업·언어를 조합한 8개 조건 모두 0이었다. 하지만 단순 greedy constrained decoding도 import 오류 자체는 0이었다. CBDL의 기여를 ‘유일하게 오류 0을 만든 방법’으로 요약하면 비교를 잘못 읽게 된다.
중요한 차이는 import streak다. 유효한 import만 반복하다 토큰 예산을 다 써서 본문을 만들지 못하는 퇴행 현상을 뜻한다. Java GPT-OSS F→P 조건에서 원래 import 오류는 22개였고, greedy 제약에서는 streak가 16개, CBDL에서는 1개였다. 이때 1개가 남았다는 점도 중요하다. 존재하지 않는 이름을 막아도 유용한 테스트까지 반드시 도달하는 것은 아니다. [근거: Table II, §VI-B]
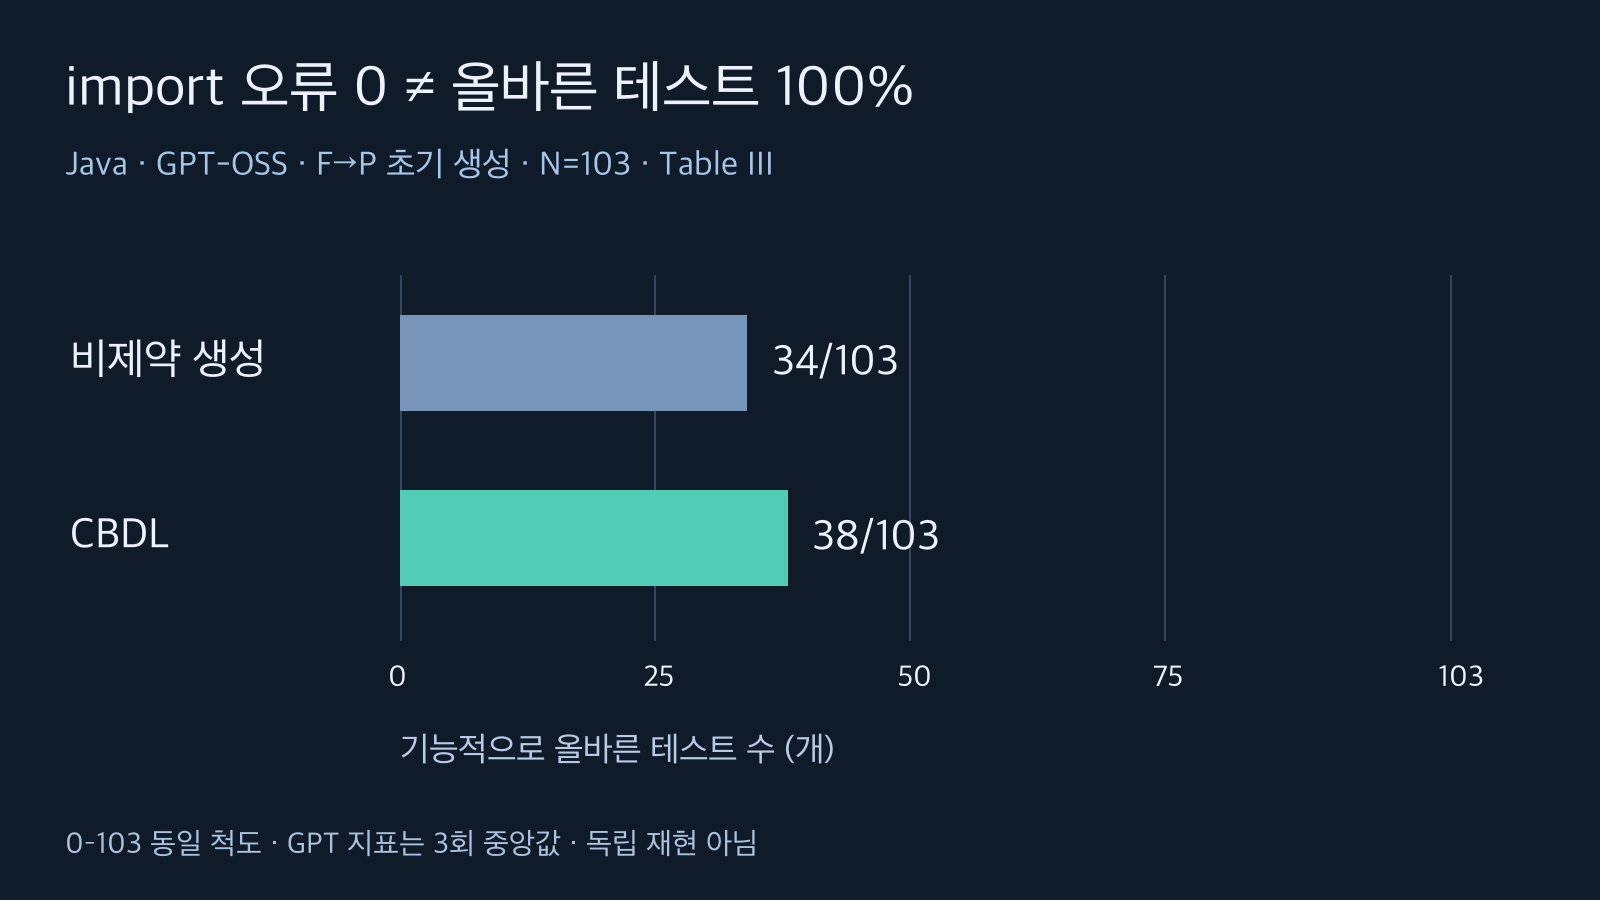
F→P는 패치 전 실패·패치 후 통과다. 동일한 103건 조건에서 34개와 38개이며, 모든 테스트의 정답이나 커버리지 향상을 뜻하지 않는다. 출처: arxiv.org/abs/2610.41878v1.
기능적 성공의 정의도 작업마다 다르다. F→P는 패치 전에는 실패하고 패치 후에는 통과해야 한다. 회귀 테스트 생성은 현재 버전에서 통과하면 성공으로 계산하며 커버리지는 성공 판정에 포함하지 않는다. 따라서 Python GPT-OSS 회귀 조건의 144/323→157/323을 버그 탐지율이나 커버리지 향상으로 바꿔 부를 수 없다. Java Llama 회귀 조건은 10/103으로 변화가 없었다. [근거: §II, Table III, §VI-C]
분모와 반복 방식도 결과 해석의 일부다. Java는 빌드 실패 18건을 제외한 103건, Python은 원래 449건에서 astropy 18건, 설정 실패·시간 초과 53건, x86 필요 55건을 제외한 323건이다. 8개 실험 조건이 8개의 독립 데이터셋인 것은 아니다. GPT 계열 지표는 세 번 반복한 중앙값이고, 주된 GPT-OSS 비교에서는 원래 reasoning trace를 재사용했다. 연구진도 작은 정확도 차이를 기술적으로 해석하며 모든 기준선에 대한 통계적 우월성을 주장하지 않는다.
3. 내 파이프라인에 적용할 실패 분류표
아래 표는 논문의 관측과 보장 범위를 바탕으로 작성한 편집상 진단 도구다. CBDL 설치 가이드나 실행한 벤치마크가 아니다. 지금 가진 로그에서 어느 단계가 실패했는지 먼저 분류하면, import 제약을 검토할 이유와 남겨야 할 평가가 달라진다.
| 로그에서 보이는 상태 | 먼저 구분할 문제 | 다음 평가·판단 |
|---|---|---|
| 모듈이나 클래스 경로를 못 찾고 중단 | 환경 밖 이름인지, 추출 목록이 낡았는지 | 허용 집합의 범위·추출 누락을 확인하고 디코더 제어 가능성을 판단 |
| 유효한 import가 반복되고 본문이 없음 | import 유효성과 생성 진행은 별개 | import 오류 수와 streak·본문 도달률을 분리해 비교 |
| 본문까지 생성됐지만 assertion 실패 | 이름 제약으로 해결되지 않는 의미 오류 | 입력·기대값·타입·속성 오류를 실제 실행 결과로 분류 |
| 현재 버전에서는 통과함 | 회귀 통과와 버그 재현은 다른 목표 | F→P 목적이면 패치 전 실패도 별도로 확인 |
| 상용 모델이 본문에서 새 import를 추가 | 제약 이후의 생성 단계가 경계를 이탈 | 최종 전체 코드의 import와 실행 결과를 다시 검증 |
import 오류가 줄었어도 본문 도달률과 패치 전 실패·패치 후 통과를 따로 기록해야 한다. 여기에 프로젝트가 요구하는 커버리지나 결함 탐지 기준을 붙이는 것은 독자의 평가 설계다. 논문의 회귀 통과 수치가 그 기준을 대신 충족했다는 뜻은 아니다.
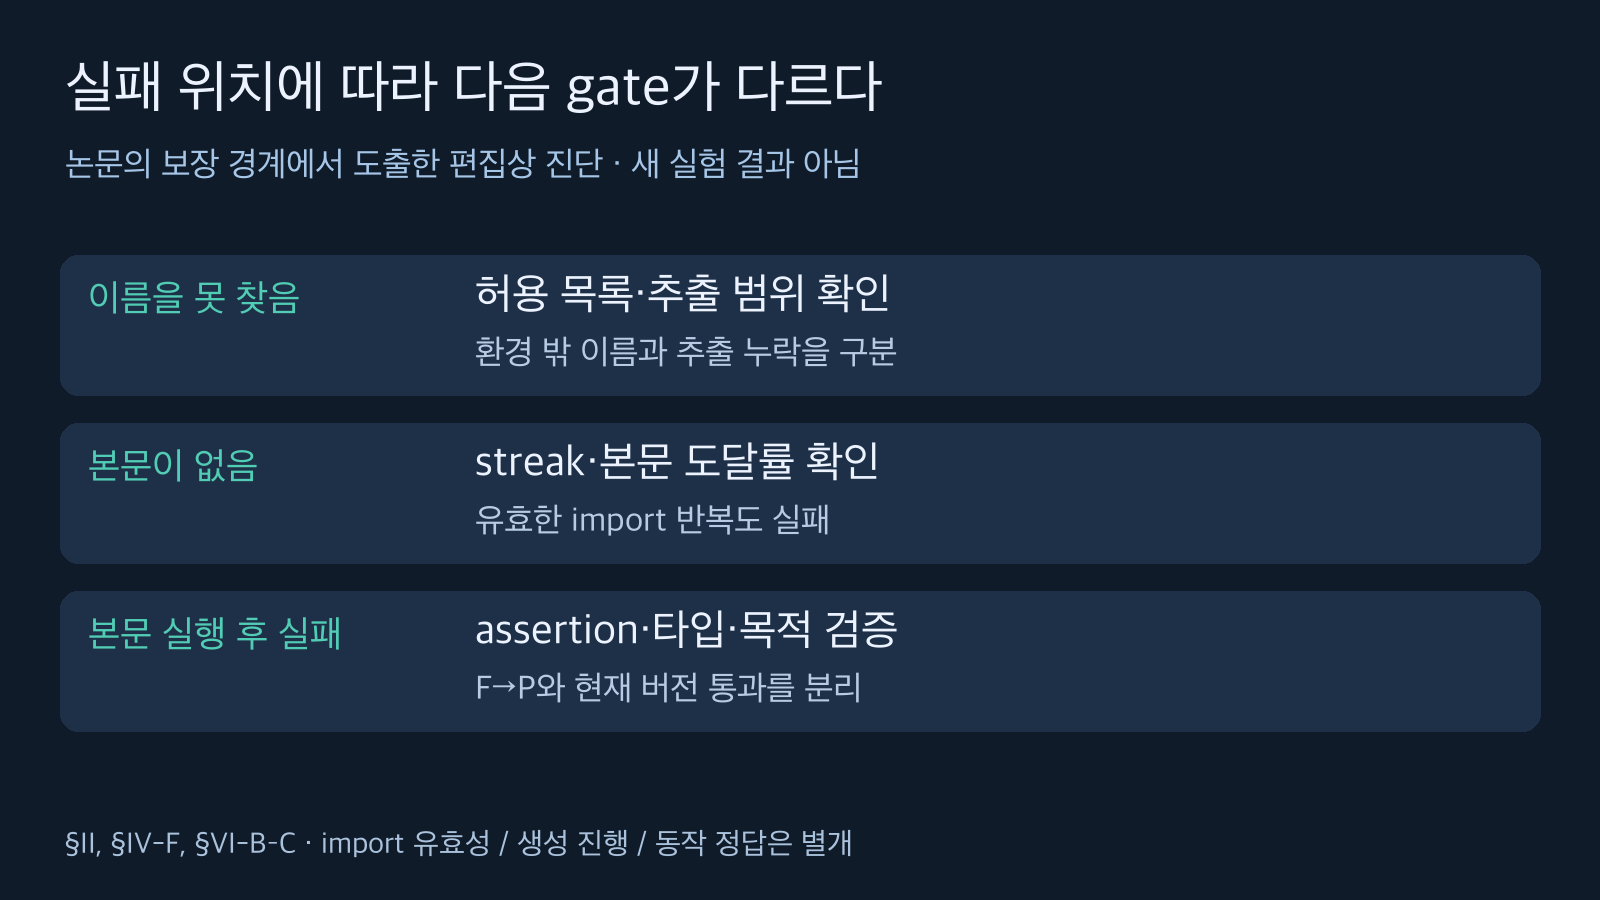
실패 단계를 분류해야 제약을 검토할 지점이 드러난다. 본문 도달과 동작 검증을 import 성공으로 대체하지 않는다. 출처: arxiv.org/abs/2610.41878v1.
최대 시도 횟수가 같은 비교도 남겨야 한다. Table III의 Python GPT-OSS F→P에서 최대 총 3회 조건은 Agentic Repair가 146/323, CBDL 초기 생성 뒤 수리가 144/323이었다. CBDL이 항상 더 정확한 것은 아니다. 반대로 이 한 셀만으로 전체 제약 방식이 불필요하다고 결론 내릴 수도 없다. 같은 최대 호출 수는 실제 호출 횟수나 소요 시간이 같다는 뜻도 아니다. 실패 종류와 최종 성공률을 함께 비교하는 것이 이 글의 제안이다.
4. 로컬 import를 상용 본문으로 넘기면 보장 경계가 열린다
하이브리드 구성에서는 로컬 GPT-OSS-CBDL이 import를 만들고, gpt-5.2-2025-12-11이 본문을 만든다. Table V의 Java F→P 성공 수는 전체 GPT-5.2 생성 47/103에서 하이브리드 50/103으로 늘었다. 하지만 하이브리드의 Java F→P import 오류는 2개, Java 회귀 조건은 1개 남았다. 상용 본문 모델이 제공받은 목록 밖의 새 import를 추가한 경우다.
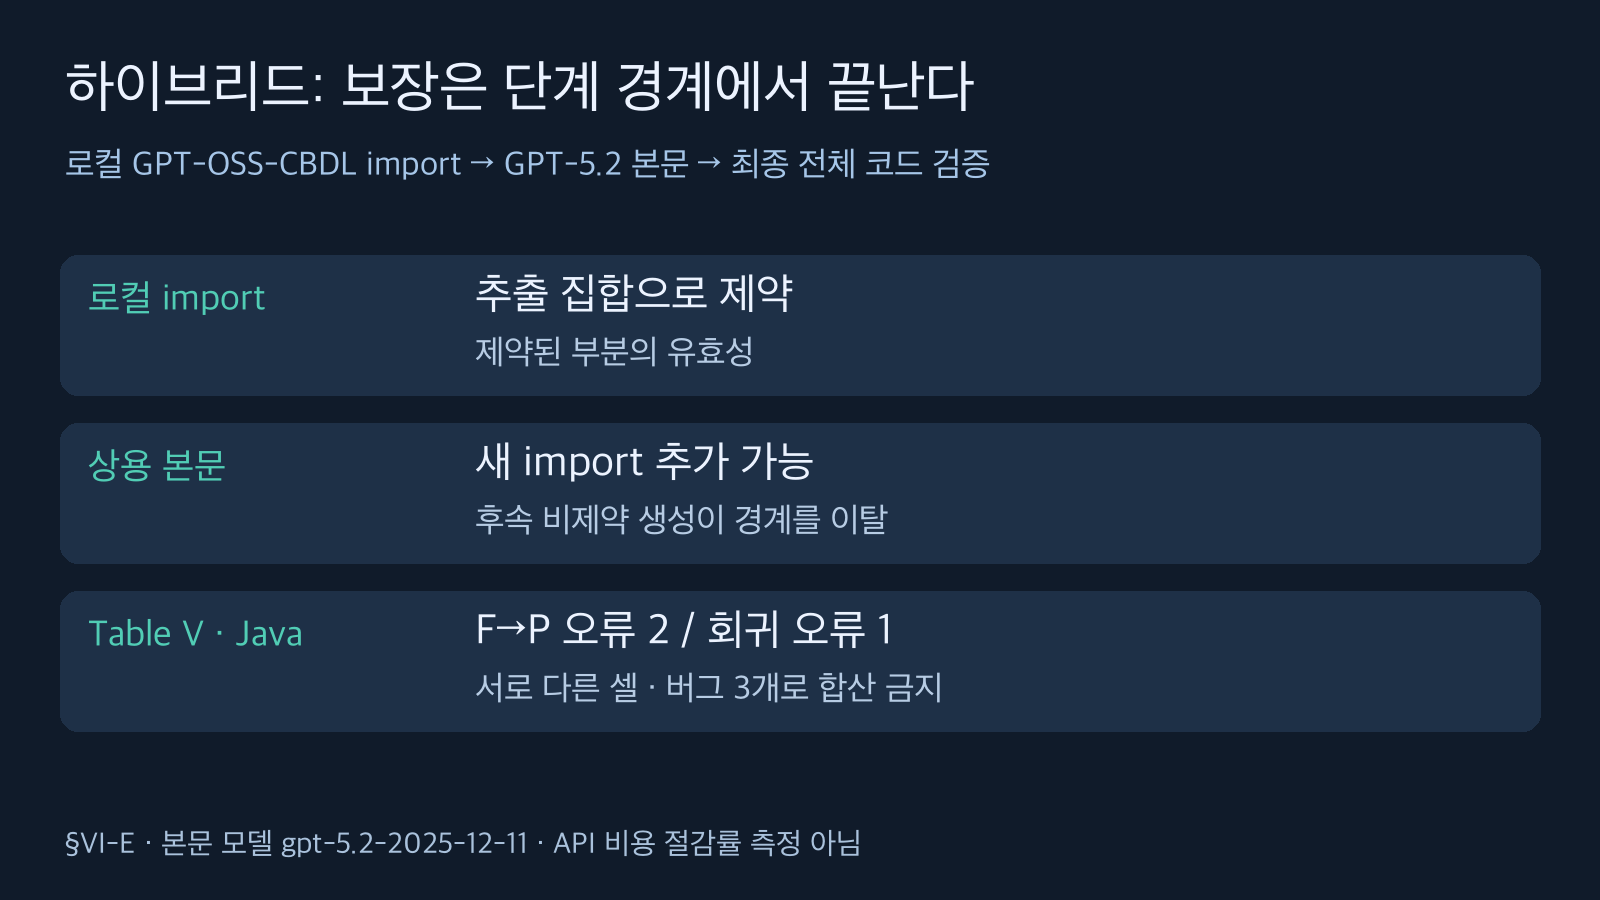
Table V의 Java F→P와 회귀 조건에는 각각 import 오류 2와 1이 남았다. 로컬 단계의 보장을 전체 하이브리드 코드에 확장할 수 없다. 출처: arxiv.org/abs/2610.41878v1.
이것은 앞선 로컬 제약 결과와 모순이라기보다 보장 적용 지점의 차이다. import를 제약한 단계의 결과가 뒤의 비제약 생성에 의해 바뀔 수 있다. 따라서 ‘로컬에서 검증했다’는 상태를 전체 코드의 최종 승인으로 승격하지 않는 편이 타당하다. 위 2와 1은 서로 다른 실험 셀이므로 이를 합쳐 서로 다른 버그 3개라고 세지도 않는다. [근거: Table V, §VI-E]
로컬 import 생성은 전체 워크플로의 기밀성 보장도 아니다. 본문 생성을 상용 API에 맡기면 작업 맥락이 그 경로로 전달된다. 이는 구성상 함의이며 실제 데이터 유출을 측정했다는 말이 아니다. 비용 역시 정확도 개선만으로 환산할 수 없다. 이 표는 API 청구액이나 일반적인 비용 절감률을 입증하지 않는다.
5. 추가 시간은 어떤 조건에서 나온 수치인가
Table VI의 Java F→P 전체 103건 평균에서 GPT-OSS 생성 시간은 205→221초, Llama는 151→172초였다. 해당 조건의 증가가 각각 16초와 21초다. 전체 처리 시간 평균은 각각 228→244초와 169→190초였다. 이것을 Python이나 다른 하드웨어의 지연 보장으로 옮겨서는 안 된다.
Java 실험 장비는 AMD Ryzen AI Max+ Pro 395와 통합 메모리 128GB였고, 일회성 허용 import 추출 시간은 이 측정에서 제외했다. 시간 실험은 주된 비교와 달리 reasoning trace를 다시 생성했다. 표의 ± 값은 표준편차이지 신뢰구간이 아니다. 따라서 ‘아무 환경에서나 테스트당 16초만 추가하면 된다’거나 ‘그만큼 API 비용을 절약한다’는 구매 판단은 이 근거로 할 수 없다. [근거: §V, Table VI, §VI-F]
결론: 이름의 유효성은 닫고, 동작의 정답은 검증한다
CBDL에서 가져갈 실무 원칙은 모든 오류를 더 긴 프롬프트와 더 많은 수리로 처리하지 말자는 것이다. 환경에서 닫힌 선택 집합을 만들 수 있고 디코더를 통제할 수 있다면, 이름의 유효성을 생성 단계에서 제한할 수 있다. 그러나 추출 누락, import 반복, 본문 의미 오류, F→P 충족 여부, 상용 후속 생성의 경계 이탈은 별도 문제로 남는다.
도입 검토의 출발점은 ‘오류 0’이라는 문구보다 현재 파이프라인의 실패 분류다. 환경 밖 이름이 반복되는 팀에는 제약이 검토 대상이지만, assertion 의미나 테스트 품질이 병목인 팀에는 import 성공만으로 충분하지 않다. 보장할 수 있는 작은 영역을 명확히 하고, 나머지는 실제 최종 코드 실행과 목적별 평가로 확인하는 것이 이 논문에서 얻을 수 있는 제한적이지만 구체적인 교훈이다.
출처와 검증 범위
- 논문 버전 기록: arXiv:2610.41878v1
- 원문 HTML: §II 작업 정의, §IV 방법과 추출 한계, §V 구현, §VI 실험과 Tables II·III·V·VI, §VII 타당성 위협.
- 원문 PDF: pp. 3–5 방법, pp. 6–8 분모·반복·정확도, pp. 9–10 하이브리드와 시간 측정.
수치와 방법은 저자 보고다. 원시 결과 재집계나 모델 실행은 하지 않았고, 자체 CBDL 구현 저장소·재현 아카이브도 검증하지 않았다. 검토한 본문 링크에서 확인하지 못했다는 뜻이지, 저장소가 어디에도 없다는 뜻은 아니다. 본문의 진단표와 그림은 이 증거 경계를 보존해 새로 구성한 설명 자료이며 제품 화면이나 새 실험 결과가 아니다.


댓글
댓글 쓰기