LLM 응답 길이 예측기를 바꾸기 전: 출력 변동과 평가 대상부터 확인하기
응답 길이 예측기의 MAE를 비교할 때 먼저 물을 것은 “이번 한 번의 출력 길이를 맞혔나, 여러 번 생성한 길이의 평균을 맞혔나?”다. 공개된 저자 코드에는 평균 길이 필드를 먼저 고르는 분기가 있다. 다만 이것만으로 논문에 실린 성능표가 평균을 정답으로 사용했다고 단정할 수는 없다. 실제 실험에 들어간 메타데이터의 필드와 집계 방식은 별도로 확인해야 한다.
이 차이는 예측기 교체의 우선순위를 바꾼다. 정답의 정의가 다르면 더 낮은 오차를 얻어도 같은 문제에서 더 좋아진 것인지 알 수 없기 때문이다. 이 글은 2026년 10월 29일 제출된 arXiv v1 프리프린트 「On the Fundamental Limits of Prefill-Based Decoding Length Prediction」과 저자 저장소의 고정 커밋을 바탕으로, 숫자를 읽는 방법과 비교 전 점검 순서를 정리한다. 동료 심사 통과나 실서비스 효과를 확인한 연구로 소개하지 않는다.
1. 단일 출력과 평균 출력은 다른 평가 대상이다
prefill은 입력 프롬프트를 처리하는 단계이고, decode는 실제 응답 토큰을 생성하는 단계다. 이 연구가 다루는 예측기는 생성이 시작되기 전의 정보, 특히 모델 내부의 hidden state를 이용해 앞으로 나올 토큰 수를 추정한다. 이미 생성된 응답을 보면서 갱신하는 예측기와는 정보 조건이 다르다. 일반적인 텍스트 전용 API를 쓰는 독자는 내부 상태를 얻을 수 있는 런타임인지부터 확인해야 한다.
같은 프롬프트라도 샘플링으로 여러 응답을 생성하면 길이가 달라질 수 있다. 한 번 나온 길이를 정답으로 삼으면 그 변동도 평가에 들어간다. 반복 생성의 경험적 평균을 정답으로 삼으면 여러 결과를 요약한 중심값을 맞히는 문제가 된다. 평균을 쓰는 것이 잘못은 아니다. 무엇을 맞히려는지 공개하지 않은 채 두 점수를 같은 성능으로 읽는 것이 문제다.
고정 커밋 306dbf0ce3795cdb1ea9744da87a7ea4bf6d29c2의 prediction/train_regression.py를 보면 로컬 파일용 collate_fn은 new_tokens_avg를 먼저 읽고, 없으면 new_tokens로 넘어간다. 두 값이 모두 없으면 해당 샘플을 건너뛴다. WebDataset용 분기는 target, new_tokens_avg, new_tokens 순서이며 필수 메타데이터나 특성이 없을 때도 건너뛸 수 있다. 이는 공개 코드의 조건부 동작에 대한 관찰이지, 논문 표의 입력을 복원한 결과가 아니다. 저자 코드: 대상 선택 분기
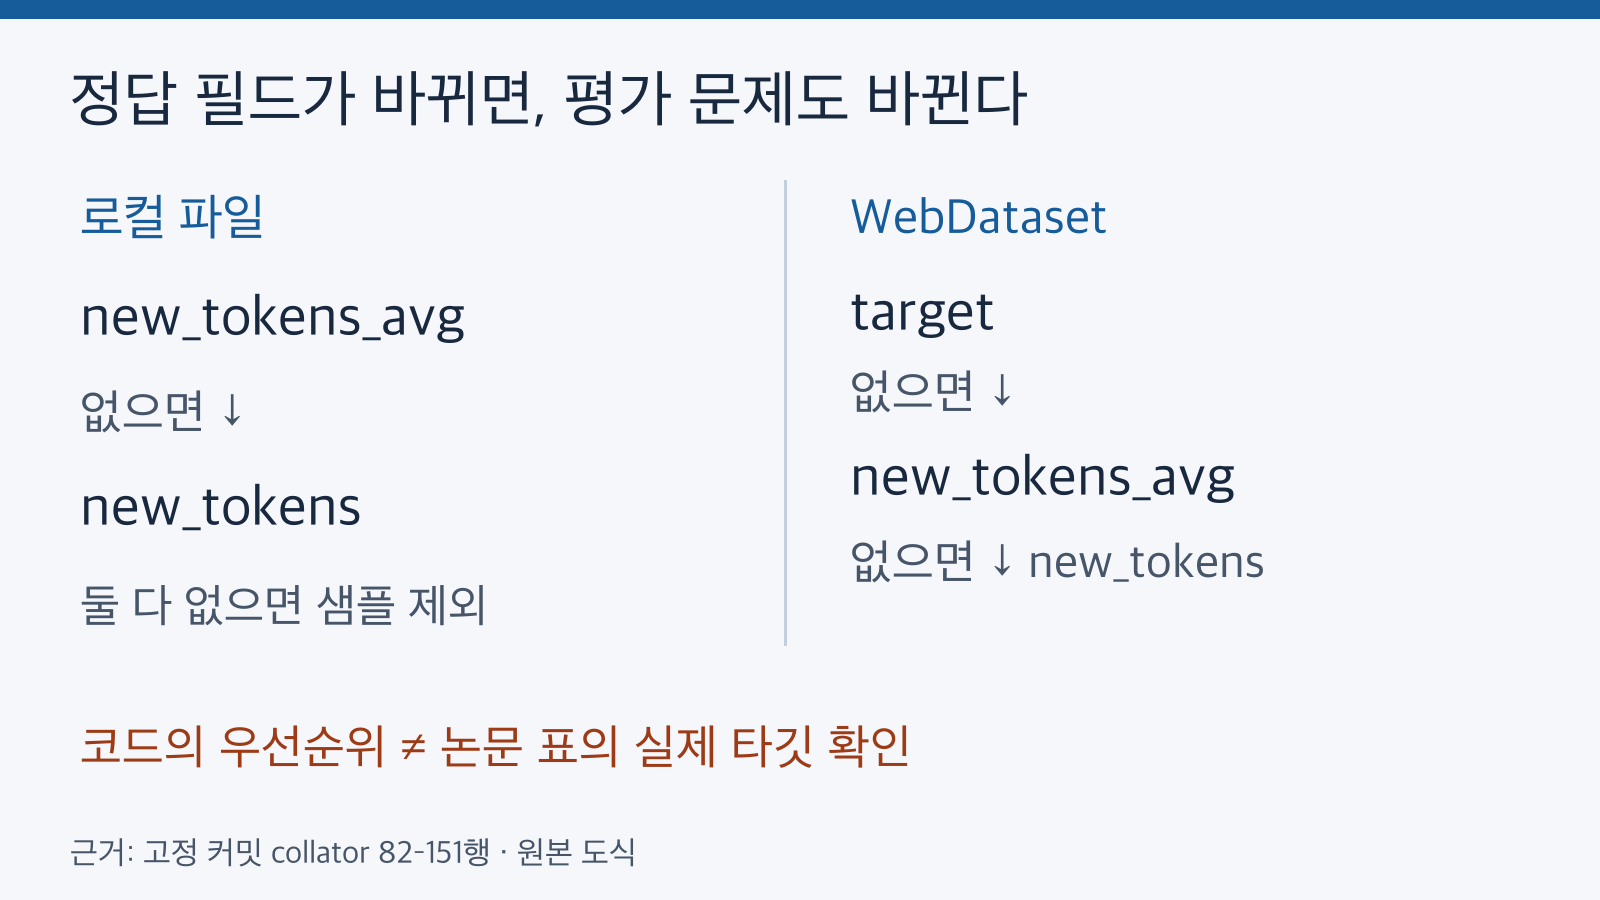
로컬 파일은 new_tokens_avg → new_tokens, WebDataset은 target → new_tokens_avg → new_tokens 순으로 고릅니다. 공개 코드의 분기이며 논문 성능표의 실제 필드 선택은 확인되지 않았습니다. 출처: github.com/ShwStone/DecodingPredict/blob/306dbf0ce3795cdb1ea9744da87a7ea4bf6d29c2/prediction/train_regression.py.
따라서 평가 로그에 target_field와 그 값의 생성 방식을 남겨야 한다. target이라는 이름만 있어서는 단일 결과인지 평균인지 알 수 없다. 평균이라면 반복 횟수와 결측 처리도 필요하다. 실제 값의 의미는 필드 이름이 아니라 데이터 생성 기록으로 확인한다.
2. 연구의 반복 횟수를 독립 질문 수로 읽지 않기
논문 4.1절에서 저자들은 ShareGPT 프롬프트 300개를 각각 200회 생성했다고 보고한다. 주요 설정은 Qwen3-32B의 no-thinking 모드, temperature 0.6, top-k 20, top-p 0.95다. 여기서 반복 결과가 많다는 사실은 서로 다른 질문을 그만큼 많이 평가했다는 뜻이 아니다. 한 질문 아래 여러 길이가 묶인 구조다.
300개 중 두 프롬프트는 매번 동일한 8토큰 답변을 냈다고 한다. 분산이 없는 이 두 사례를 제외하고, 정규성 진단은 나머지 298개 프롬프트 각각의 길이 분포를 대상으로 한다. “프롬프트 수”, “프롬프트당 생성 횟수”, “진단에 남은 프롬프트 수”를 따로 기록해야 분모를 혼동하지 않는다. 논문 v1: 4.1절과 5.1절
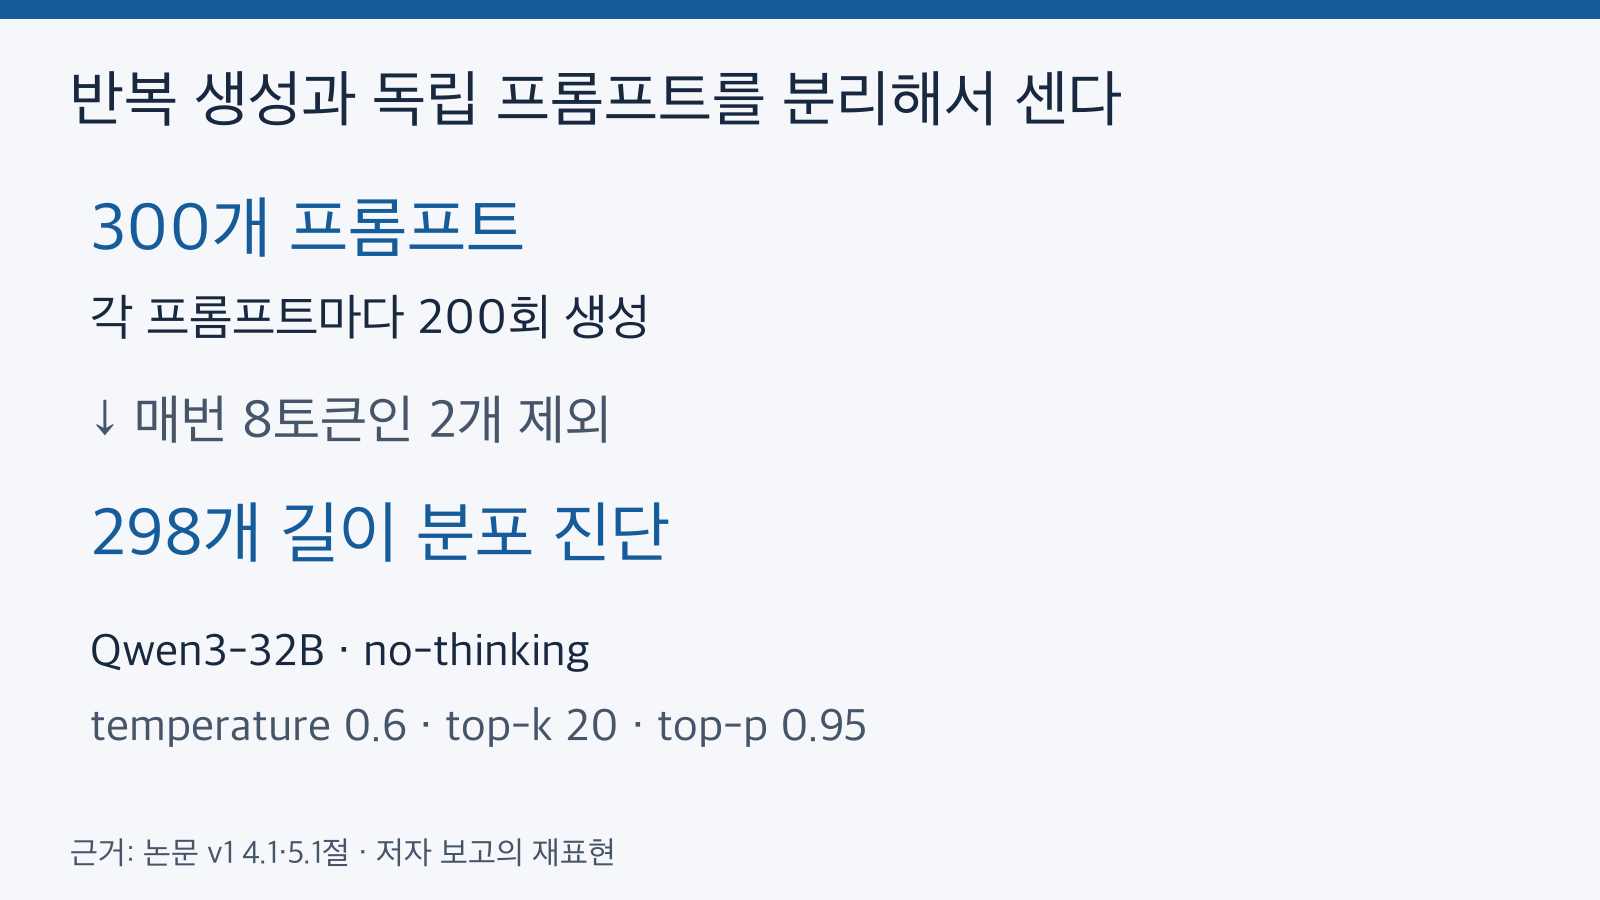
저자 보고 설계: ShareGPT 프롬프트 300개에 각 200회 생성. 매번 동일한 8토큰을 낸 두 프롬프트를 제외한 298개가 정규성 진단의 분모입니다. 독립 재현은 아닙니다. 출처: arxiv.org/html/2610.40541v1.
이 설계에서 얻을 수 있는 실무적 질문은 “우리 서비스의 고정된 입력도 길이가 얼마나 흔들리는가?”다. 반면 특정 모델과 데이터의 관찰을 모든 LLM의 보편적인 오차 바닥으로 옮기는 것은 범위를 벗어난다. 프롬프트 구성이나 샘플링을 바꾸면 예측해야 할 분포 자체가 달라진다.
3. 정규성 검정 비율은 예측 정확도가 아니다
저자 보고에서 유의수준 0.05일 때 Shapiro–Wilk 검정이 정규성을 기각하지 않은 프롬프트는 298개 중 79개, 표기 비율은 26.5%다. Kolmogorov–Smirnov 검정에서는 226개, 75.8%다. 두 값 모두 “길이 예측에 성공한 비율”이 아니다. 같은 프롬프트의 반복 길이가 정규분포라는 가설을 해당 검정이 기각하지 않은 빈도다. 기각하지 않았다는 사실이 정규분포임을 증명하지도 않는다.
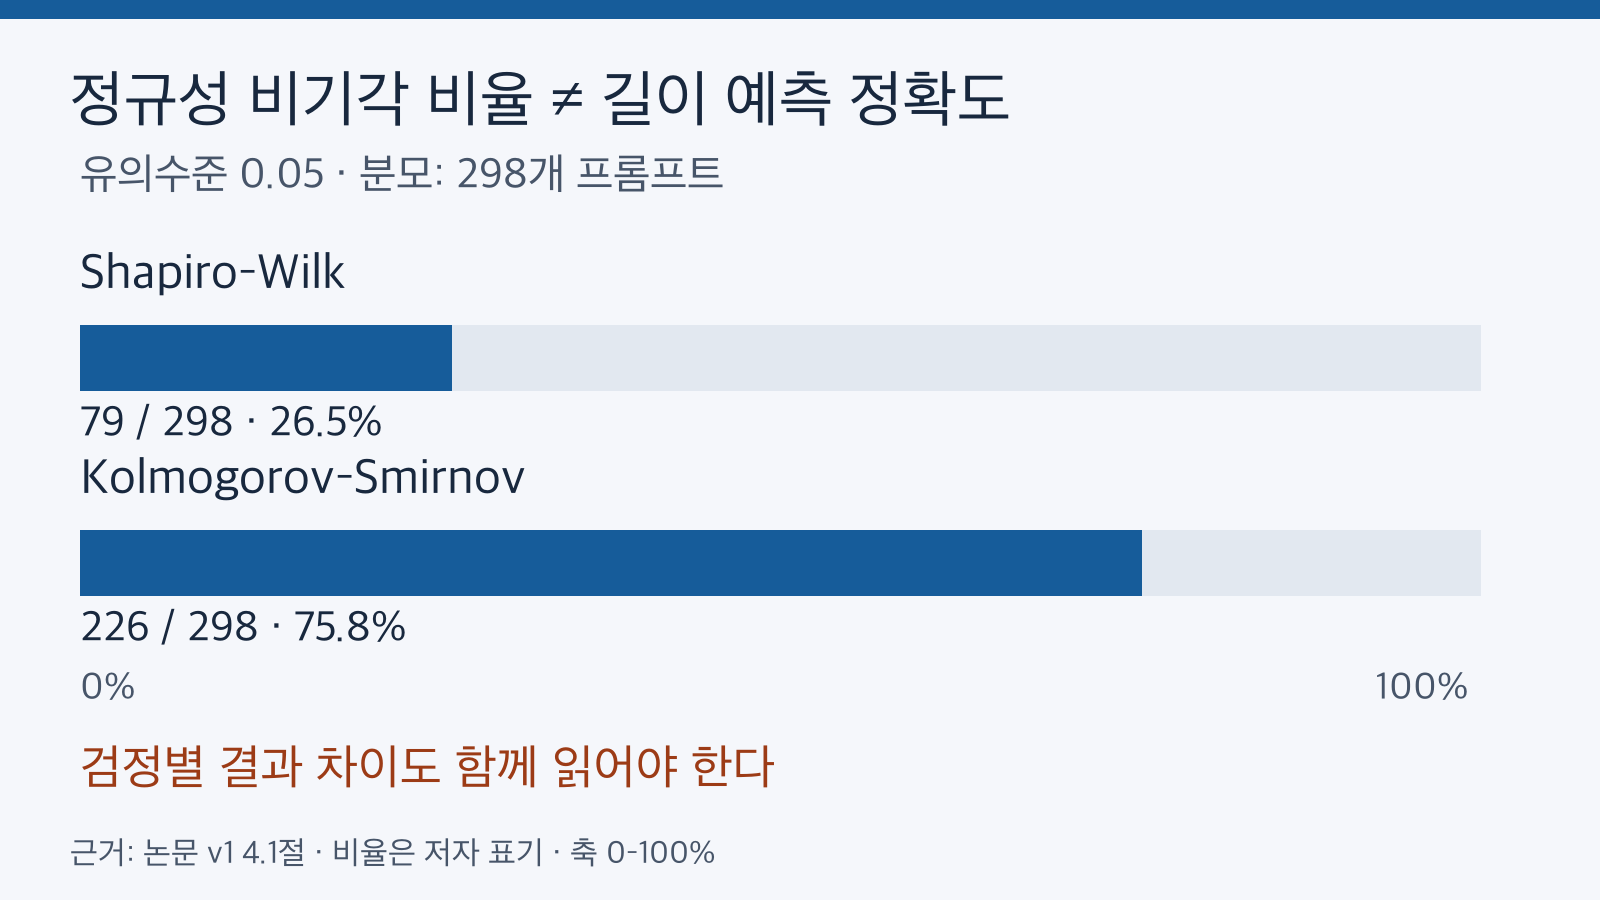
유의수준 0.05, 분모 298개 프롬프트. Shapiro–Wilk는 79개(26.5%), Kolmogorov–Smirnov는 226개(75.8%)에서 비기각을 보고했습니다. 비기각은 정규성의 증명이 아닙니다. 출처: arxiv.org/html/2610.40541v1.
검정에 따라 결과가 크게 다른 만큼, 중앙부를 근사하는 모델이 유용할 수 있다는 해석과 모든 꼬리·모든 프롬프트에 맞는 법칙이라는 주장은 구분해야 한다. 이 글은 논문의 이론적 상한이나 성능표 백분율을 보편적 정확도 한계로 재인용하지 않는다. 원시 반복 길이를 내려받아 검정값을 재계산한 것도 아니다. 수치는 저자가 보고한 범위로만 읽는다. 논문 v1: 4.1절
또한 논문 성능표의 실제 평가 타깃과 집계 가중치를 독립적으로 확인하지 못했다. 공개 collator의 평균 필드 우선순위만으로 그 표를 무효라고 선언하거나, 표의 비율에 임의의 분모를 곱해 성공 건수를 만드는 것은 피한다.
4. 예측기 교체 전 결정표: 무엇부터 고칠까
아래 표는 논문의 실험 결과가 아니라, 본문과 코드에서 확인한 조건을 개발자의 비교 실험에 적용한 편집적 판단 도구다. 평균 필드와 단일 출력 필드가 섞였다면, 모델을 바꾸기 전에 평가 대상을 분리한다.
| 지금 확인한 상태 | 먼저 할 일 | 비교를 재개할 조건 |
|---|---|---|
new_tokens_avg와 new_tokens가 함께 있거나 입력별로 다르다 |
실제 선택된 필드와 생성 의미를 기록하고 평가셋을 분리한다 | 두 예측기의 정답 정의가 같다 |
target 필드의 의미가 기록되지 않았다 |
데이터 생성 기록에서 단일 출력인지 평균인지 확인한다 | 타깃 의미와 반복 횟수를 설명할 수 있다 |
| 샘플 누락이 있는데 원래 입력 수만 보고한다 | 입력 수·누락 사유·실제 채택 타깃 수를 따로 센다 | 지표 분모가 실제 채택 건수와 일치한다 |
| 모델·샘플링·프롬프트 집합이 다르다 | 조건을 맞춘 비교를 별도로 만든다 | 조건 차이와 예측기 차이를 분리한다 |
| 조건은 같지만 반복 길이가 크게 흔들린다 | 프롬프트별 평균·표준편차와 절대·상대 오차를 함께 본다 | 변동과 예측 오차를 혼동하지 않는다 |
| prefill과 decode의 실행 조건이 다르다 | 배치·커널·결정성 설정과 특성/라벨 생성 경로를 기록한다 | 통제한 조건과 미통제 조건이 드러난다 |
고정 커밋의 prediction/train_utils.py는 절대오차 항목 수인 abs_err.numel()을 누적해 실제 평가 분모로 사용한다. MAE는 절대오차 합을 그 수로 나누며, Acc@100은 오차가 100토큰 미만인 항목의 비율이다. 정확히 100토큰인 경우는 포함하지 않는다. 200과 500도 같은 엄격한 비교를 쓴다. 이는 지표 구현의 정의이며, 이 글에서 예측기를 돌려 얻은 정확도는 아니다. 저자 코드: 지표 누적과 집계
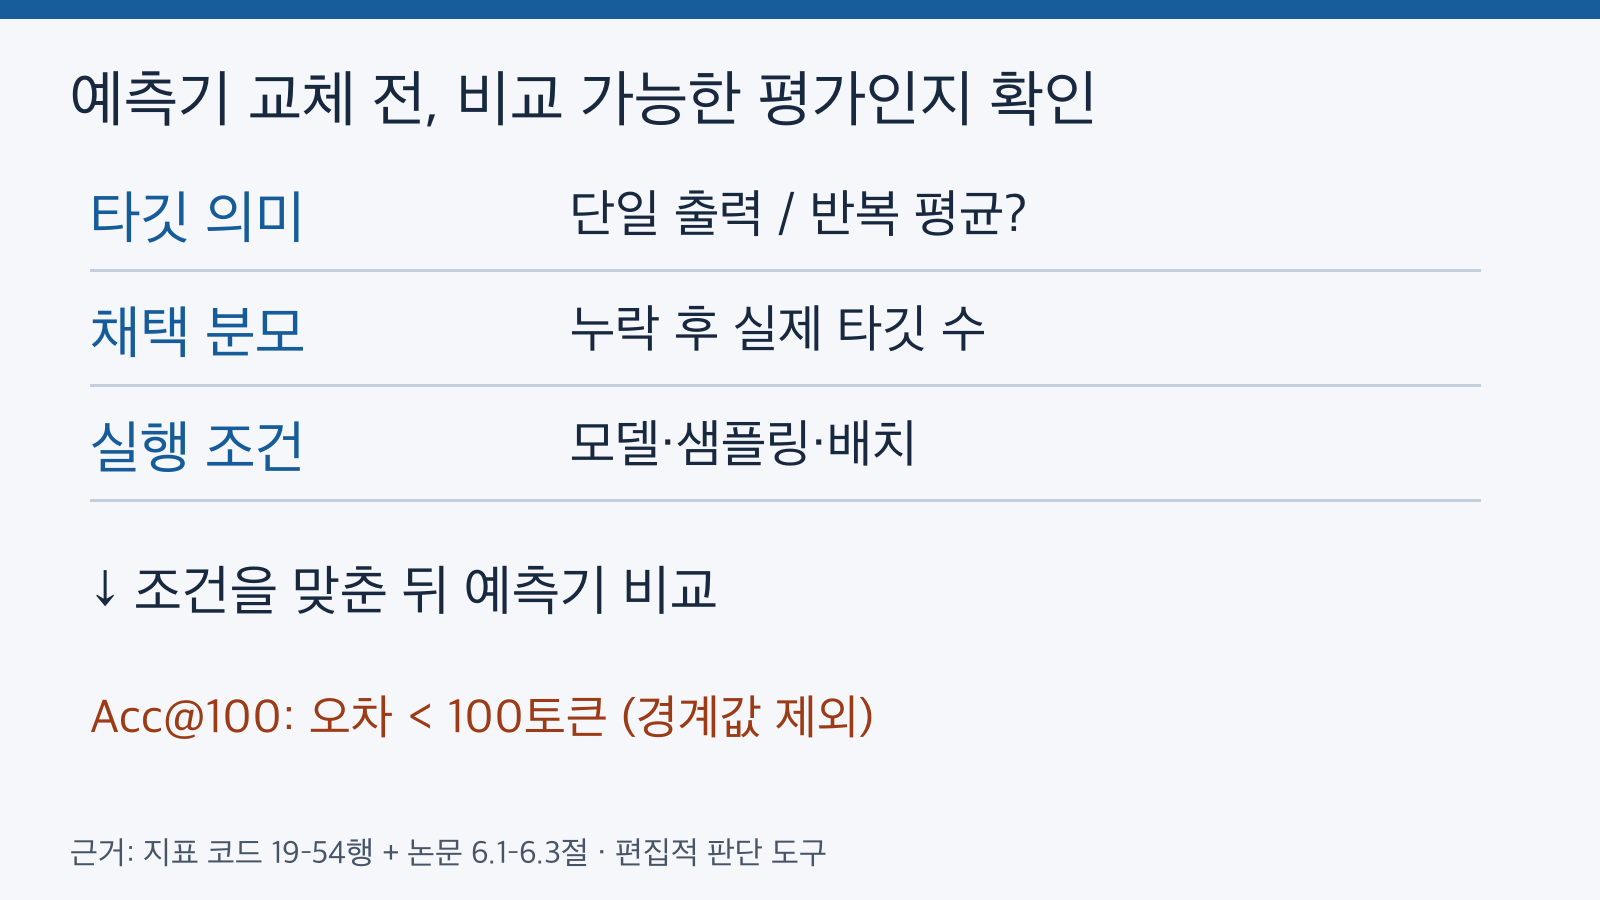
편집적 적용: 타깃 의미 → 채택 분모 → 실행 조건을 먼저 맞춥니다. 지표 코드는 abs_err.numel()을 누적하고 Acc@100에 오차 < 100을 사용합니다. 새 성능 측정 결과가 아닙니다. 출처: github.com/ShwStone/DecodingPredict/blob/306dbf0ce3795cdb1ea9744da87a7ea4bf6d29c2/prediction/train_utils.py.
팀 기록에는 최소한 프롬프트 ID, 타깃 생성 방식, 선택 필드, 반복 횟수, 모델과 샘플링 설정, 채택 여부, 제외 사유, 길이 단위가 있어야 한다. 평균 타깃 실험과 단일 출력 타깃 실험을 나란히 보여줄 수는 있지만, 어느 한쪽의 점수가 낮다는 이유만으로 같은 문제에서 우월하다고 결론 내리지 않는다. 상대 오차를 추가할 때도 무엇으로 나눴는지와 길이가 0인 사례의 처리 규칙을 적어야 한다.
5. 이 연구가 아직 말해 주지 않는 것
논문 6.1절은 예측기를 비교할 때 대상 모델·데이터·샘플링을 고정하고, 프롬프트별 변동과 상대 지표를 절대 오차와 함께 보고하자고 권한다. 동시에 5.1절과 6.2–6.3절은 prefill 특성과 decode 라벨을 서로 다른 작업자에서 생성했고, 배치 크기·CUDA 커널·결정성 설정을 엄격히 통제하지 못했다고 밝힌다. 저자 스스로 공개한 이 한계는 복잡한 예측기의 장단점과 별도로 남는다. 논문 v1: 5.1절, 6.1–6.3절
이 글은 보존된 논문 본문과 고정 커밋의 코드 분기를 검토한 해설이며, 모델 학습·반복 생성·논문 성능 재현을 실행한 결과가 아니다. 실서비스 스케줄러를 배포하거나 처리량·GPU 에너지·API 비용 절감도 측정하지 않았다. 응답 길이를 더 잘 예측한다는 것과 운영 비용이 줄어든다는 것은 별도의 검증 문제다.
관련 내부 글은 이번 패키지에서 추가하지 않았다. 평가 타깃의 의미와 반복 출력의 분모라는 좁은 주제에 직접 연결되는 기존 본문을 검증하지 않은 상태에서, 운영·에너지 절감 글을 억지로 연결하면 이 연구의 효용 범위가 넓어 보일 수 있기 때문이다.
결론은 “복잡한 예측기는 필요 없다”가 아니다. 무엇을 정답으로 삼았는지, 반복 결과가 어느 질문에 묶이는지, 실제 평가에 몇 개가 들어갔는지가 먼저 드러나야 예측기를 바꾼 효과도 읽을 수 있다는 것이다. 타깃과 비교 조건이 정리된 뒤의 모델 개선 실험이 비로소 해석 가능한 비교가 된다.
출처와 확인 범위
- 논문 v1 및 제출 이력: 2026년 10월 29일 제출된 프리프린트. 본문 4.1·5.1·6.1–6.3절을 중심으로 수치·조건·한계를 확인했다.
- 대상 선택 코드 — 고정 커밋: 로컬 파일 및 WebDataset collator의 우선순위와 누락 처리.
- 지표 코드 — 동일 고정 커밋: 실제 타깃 수 누적, MAE, 허용 오차의 엄격한 비교.
본문 그림은 위 근거를 바탕으로 새로 그린 설명용 도식과 저자 보고 수치의 재표현이다. 원 논문 그림·제품 화면·실행 결과 화면을 복제하거나 독립 재현으로 표시하지 않았다.


댓글
댓글 쓰기