PyTorch 코드를 TPU로 옮겼다면: XStack의 새 환경 재실행·원 실험·가중치 검증
GPU에서 쓰던 PyTorch 학습 저장소를 TPU용으로 바꿨고, 학습 로그에 목표 점수까지 찍혔다. 이제 이관을 끝냈다고 받아도 될까? XStack을 읽을 때 가장 유용한 질문은 어떤 모델이 코드를 많이 바꿨느냐가 아니라, 그 점수가 새 환경에서 원 실험을 수행한 결과인지, 마지막 가중치를 원 모델이 받아들이는지다.
먼저 숫자의 단위를 분리하자. 논문 v1의 최종 결과는 20개 저장소와 일곱 모델–하네스 구성을 조합한 140개 평가 칸 중 44개 통과다. 약 31.43%이며, 140개 서로 다른 저장소나 AI 코딩 전체의 성공률을 뜻하지 않는다. 이와 별개인 ‘수치 기준을 넘긴 102개 결과’는 두 평가 단계에서 나온 결과의 수다. 이 둘을 같은 분모의 퍼널처럼 연결하면 연구가 말하지 않은 성공률을 만들게 된다. [1, §3.1–3.2, Table 4]
이 글의 결과물은 이관 인수용 승인표다. 환경 재실행, 원 실험의 결과 출처, 원 모델 가중치 로딩을 서로 다른 승인 칸으로 남긴다. 논문의 순위를 현재의 구매 추천으로 바꾸거나 TPU 실험을 직접 재현했다고 주장하지 않는다.
1. 이관 결과물을 파일 묶음이 아닌 재실행 계약으로 받기
저자 저장소의 설명에 따르면 제출물에는 환경을 만드는 setup_env.sh, 학습·평가와 지표 출력을 맡는 run_train.py, 원 PyTorch 모델의 파라미터 이름으로 가중치를 내보내는 export_torch.py가 들어간다. 채점에는 새로 초기화한 TPU를 쓰며, 목표 수치와 모델 판정, 원 모델 가중치 로딩을 따로 확인한다. [2, How it works]
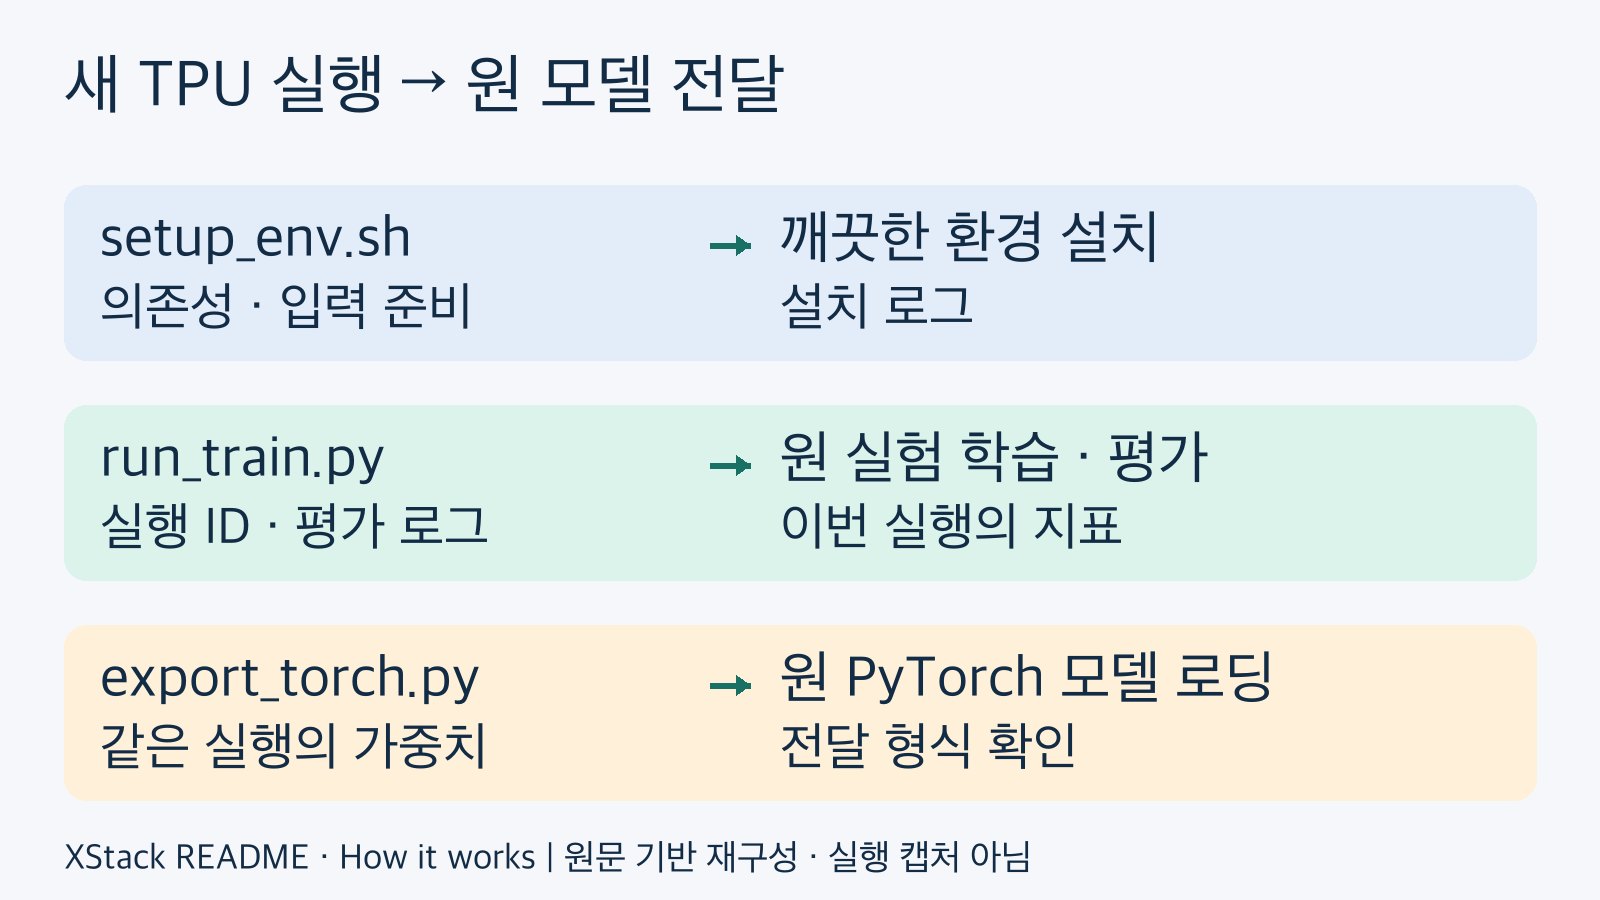
제출 파일 세 개와 인수 증거의 연결. 새 환경의 학습·평가와 원 모델 가중치 로딩은 같은 확인이 아니다. 저자 README를 바탕으로 재구성했다. 출처: github.com/zlab-princeton/XStack/blob/b779f82fc0af90ff6032db9dd45bd3fcbf43fcbd/README.md.
이 구조를 실무에 적용한다면 ‘내 작업용 VM에서 한 번 됐다’와 ‘다른 사람이 제출물만으로 다시 돌렸다’를 구별하는 것이 출발점이다. 전자는 개발 중 관찰이고 후자는 인수 가능한 재실행 증거다. 캐시된 데이터, 셸에만 남은 환경 변수, 다른 디렉터리의 체크포인트가 결과를 도왔는지 제출물만 보고는 알 수 없기 때문이다. 이것은 이 글의 위험 분석이지, 특정 XStack 통과 결과가 그런 결함을 가졌다는 주장은 아니다.
인수 요청에는 실행 시작 디렉터리와 입력 데이터 식별자, 의존성 버전, 실행 명령, 종료 상태를 함께 적는 편이 낫다. 지표 파일만 받으면 무엇을 실행했는지 역으로 추적해야 한다. 반대로 모델 코드의 변경 줄 수만 받아도 실제 평가가 끝났는지는 알 수 없다. 새 환경 로그와 결과 파일의 관계를 보존하면 ‘코드는 준비됨’과 ‘원 실험 평가까지 끝남’을 서로 다른 상태로 표현할 수 있다.
여기서 새 환경은 새 클라우드 자원을 무작정 구매하라는 뜻이 아니다. 접근 권한과 비용 한도를 먼저 정하고, 기존 승인 환경 안에서 재실행 조건을 명시하는 설계다. 이 글에서는 TPU를 생성하거나 학습을 실행하지 않았다.
2. 44/140과 102개 결과는 다른 질문에 답한다
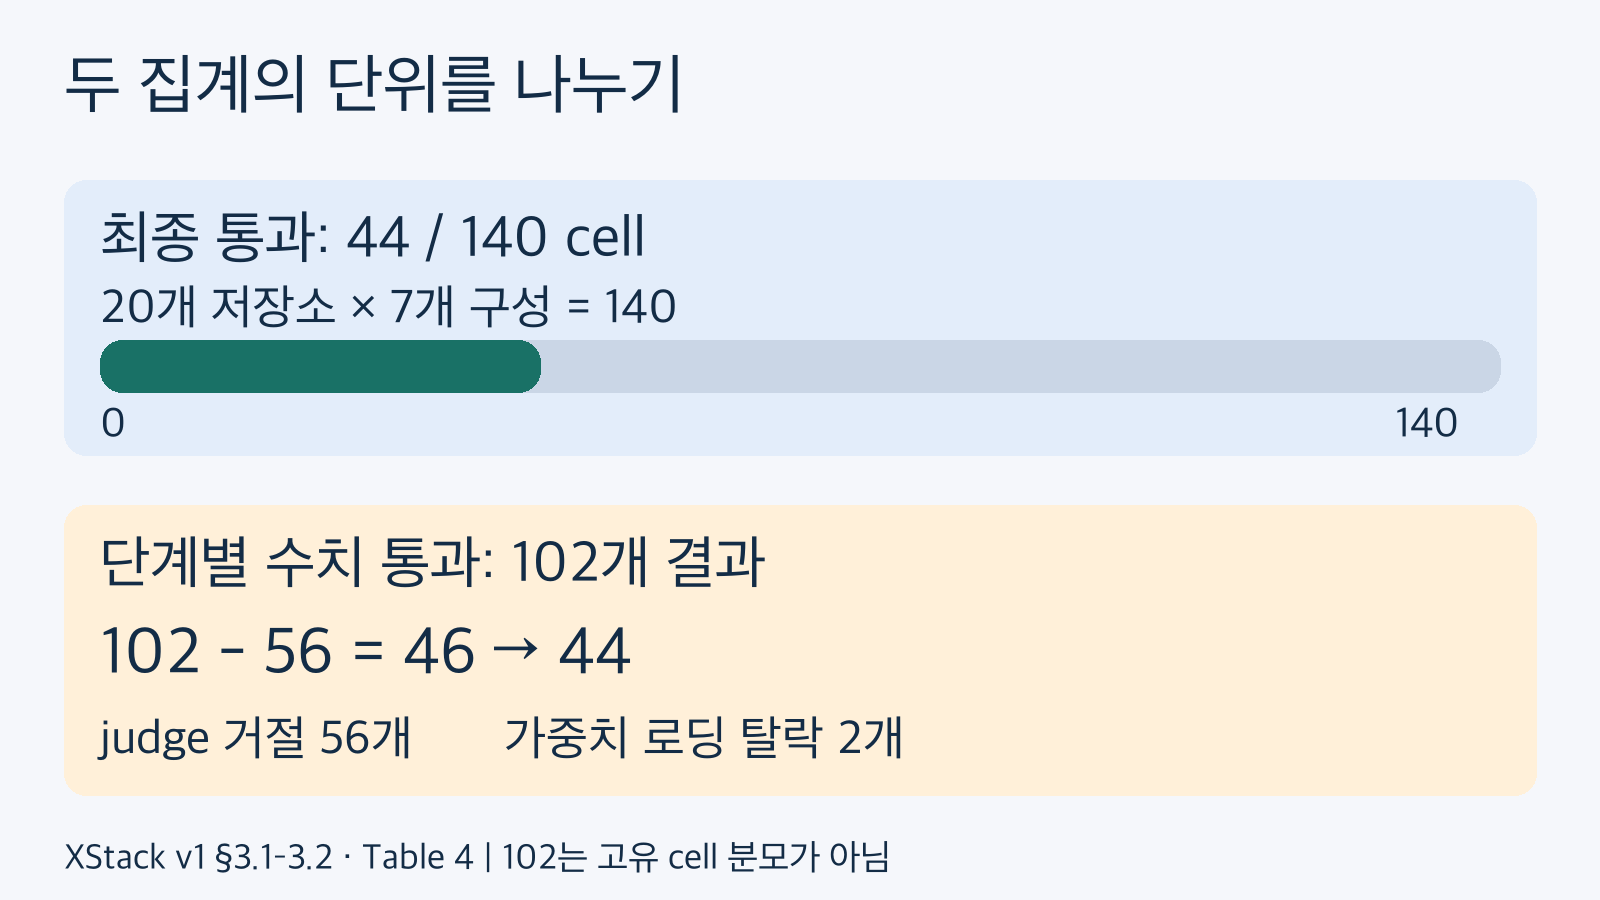
위 막대는 44/140 평가 칸, 아래 산식은 두 단계의 수치 통과 결과 102개다. 서로 다른 집계 단위를 하나의 성공률 퍼널로 합치지 않았다. 출처: arxiv.org/abs/2611.08472v1.
논문이 보고한 최종 통과 수를 구성별로 합치면 15+9+8+5+4+2+1=44다. 일곱 구성은 같은 20개 저장소를 평가한다. 따라서 분모는 20×7=140이고, 44÷140×100을 반올림하면 31.43%다. 이것은 공개 표에 대한 산술 교차검산이며, 원시 실행 궤적을 재집계하거나 독립 학습을 한 결과가 아니다. [1, Table 4]
다른 쪽 계산은 두 단계의 수치 통과 결과 102개에서 시작한다. 모델 judge가 56개를 거절해 46개가 남고, 원 모델 가중치 로딩에서 두 개가 빠져 최종 44개가 된다. 102는 고유 저장소 수가 아니고, 동일 평가 칸의 단계별 결과를 포함한다. 56개 거절 전부를 고의 부정행위라고 읽어서도 안 된다. 실험 레시피나 동결 규칙 위반, 수치의 출처 문제를 구별해야 한다. [1, §3.1–3.2]
이 구분은 보고서 양식에도 그대로 필요하다. 이관 프로젝트 대시보드에 ‘시도 횟수’와 ‘대상 저장소 수’를 한 열로 쓰면, 재시도를 많이 한 프로젝트의 분모가 달라진다. 최소한 대상 식별자, 단계, 실행 식별자를 나눠야 숫자를 비교할 수 있다. 예를 들어 같은 저장소의 첫 제출과 레시피 정렬 후 제출을 두 개의 독립 저장소처럼 세면 안 된다.
또한 마지막 가중치 확인을 앞선 수치 검사에 흡수하지 않는 편이 좋다. 목표 지표를 넘긴 상태와 소비자가 원하는 모델 형식으로 전달된 상태는 서로 다른 인수 조건이다. 숫자만 표시하는 보고서에는 완료처럼 보여도, 다음 작업자가 체크포인트를 열 수 없다면 전달 작업은 남아 있다.
3. 두 번째 기회는 자유 재작성 단계가 아니다
XStack의 phase 2는 실패 뒤 실험 레시피를 알려주되, 수치 목표는 숨긴다. 제출 코드는 동결하고 run_train.py만 바꿀 수 있다. 대표 최종 결과에는 이 두 번째 단계가 포함된다. 따라서 ‘아무 힌트 없이 한 번에 44개를 옮겼다’고 설명하면 평가 조건을 지워버린다. [1, §2.2, Table 2; 3]
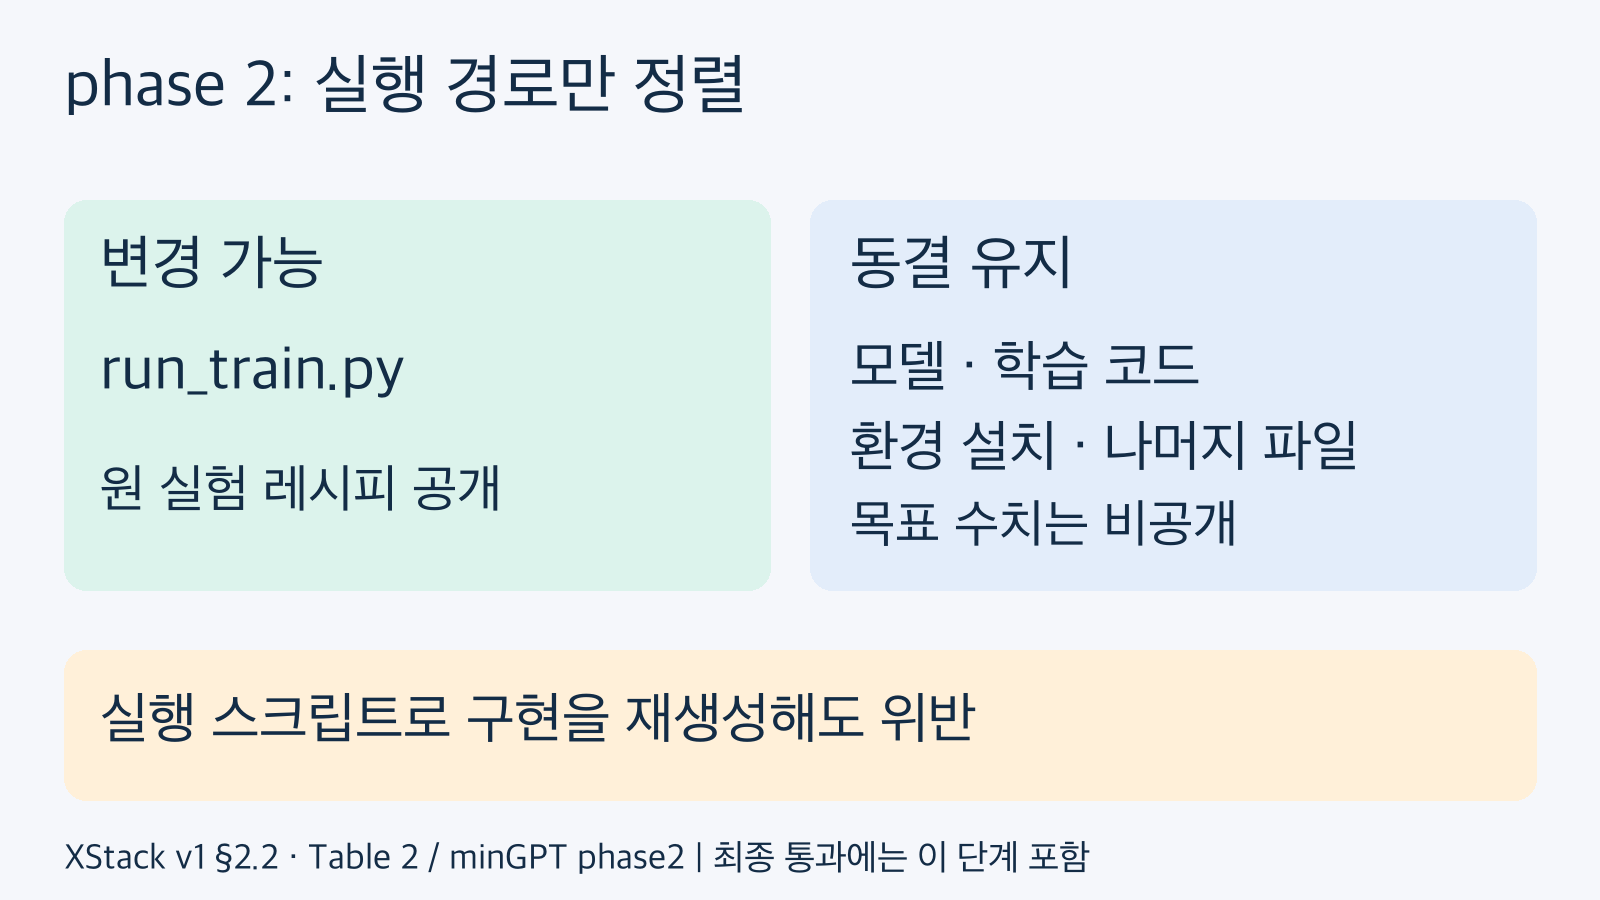
phase 2는 실험 레시피를 알려주는 제한적 정렬 단계다. 구현·설치까지 자유롭게 다시 만드는 기회가 아니며, 수치 목표는 계속 숨긴다. 출처: github.com/zlab-princeton/XStack/blob/b779f82fc0af90ff6032db9dd45bd3fcbf43fcbd/README.md.
이를 인수 회의에 적용할 때는 두 종류의 수정 요청을 구분할 수 있다. ‘다른 데이터 분할을 평가했으니 원 실험을 실행해 달라’는 요청과 ‘모델 구조를 다시 구현해 달라’는 요청이다. 둘 다 결과를 바꾸지만 해결하는 문제는 다르다. 첫 번째는 실행 경로 정렬이고, 두 번째는 이관 구현의 수정이다.
실무용 변경 기록에는 변경 가능한 파일, 고정한 커밋, 알려준 레시피, 여전히 감춘 평가 조건을 각각 남길 수 있다. 실행 스크립트 안에서 모델 파일을 다시 생성한다면 파일 이름만 허용 범위에 있어도 동결의 취지를 지키지 못한다. 따라서 허용 파일 목록만 확인하기보다 그 파일이 실제로 어떤 동작을 했는지 함께 검토해야 한다. 이것은 연구의 동결 규칙을 해석한 인수 설계이며, 보안 인증이나 자동 부정행위 탐지 도구를 제안하는 것은 아니다.
저자 judge 구현은 correctness와 cheat 판정을 각각 세 번 요청하고, 하나라도 실패하면 거절하는 보수적 결합을 사용한다. [4, module docstring 및 decide] 반복 호출은 세 번의 독립 이관이나 인간 검토 세 명을 뜻하지 않는다. 판정 모델에 의존한다는 한계도 유지된다. 팀의 승인표에서는 자동 판정 결과와 사람이 실제로 확인한 범위를 다른 열에 두는 것이 정직하다.
4. minGPT 예시: 같은 495라도 출처가 다르면 답이 다르다
고정된 저자 criteria.json에서 minGPT 기준은 두 자리 덧셈의 보류 test 500문항 중 495개 이상 정답이다. 특히 bar_provenance.kind는 rule이다. 원 minGPT 저장소가 공개한 성능값을 그대로 복제한 숫자가 아니라, 벤치마크 저자가 설정한 규칙이라는 뜻이다. [5, bar 및 bar_provenance]
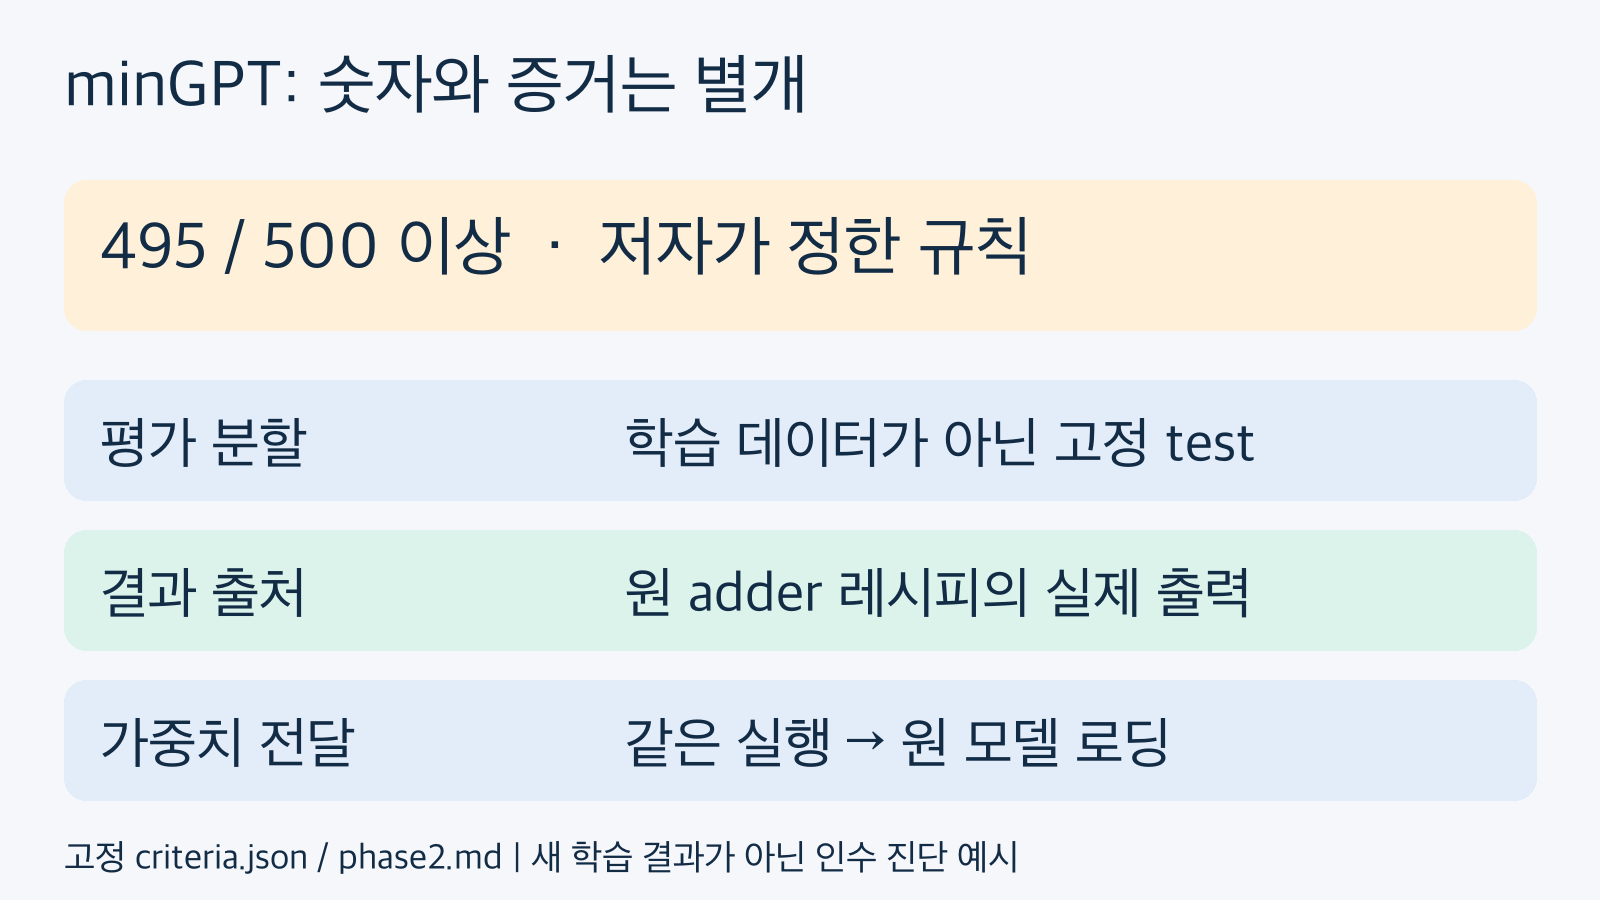
495/500은 벤치마크 저자가 정한 규칙이다. 아래 세 가지 확인은 숫자가 어떤 실행에서 나왔고 어떻게 전달되는지 묻는 편집상 진단 항목이다. 출처: github.com/zlab-princeton/XStack/blob/b779f82fc0af90ff6032db9dd45bd3fcbf43fcbd/tasks/mingpt/criteria.json.
다음 표는 실제 새 실험 결과가 아니라, 이 기준을 보고 이관 산출물을 인수할 때 쓸 수 있도록 만든 판단 예시다.
| 받은 증거 또는 상황 | 지금 말할 수 있는 것 | 추가로 필요한 증거 |
|---|---|---|
| 지표 JSON에 정답 495, 전체 500만 있음 | 제출자가 그 값을 기록했다 | 해당 실행 로그, 평가 분할 식별자, 실제 평가 경로 |
| 원 adder 레시피와 고정 test 평가 경로가 확인됨 | 평가 대상과 결과 출처가 연결됐다 | 새 환경 재실행의 완료 상태와 출력 연결 |
| 새 TPU 재실행이 끝났지만 export를 안 해봄 | 학습·평가 실행은 확인됐다 | 같은 실행에서 나온 가중치의 export 및 원 모델 로딩 |
| 원 모델이 가중치를 읽었으나 다른 모델 변형을 학습함 | 파일 형식 호환을 일부 확인했다 | 원 실험의 모델·데이터·학습 규모 일치 검토 |
저자 phase2 문서는 데이터 생성, test 분할, 평가 방식과 중단 규칙까지 명시한다. [3] 독자에게 중요한 것은 설정 항목을 외우는 일이 아니다. ‘정답 495’라는 한 값이 어느 분할에서, 어떤 모델과 평가 절차로 나왔는지 묻는 것이다. 학습 데이터 평가를 test 결과로 표시했다면 숫자 자체가 기준 이상이어도 같은 검증을 통과한 것이 아니다.
이 표에서 어떤 행도 원 모델 가중치가 실제로 로드됐다는 새 실험 증거는 아니다. 실제 실행 결과를 쓰려면 명령, 환경, 입력, 로그와 산출물의 연결이 필요하다. 여기서는 공개 저자 파일의 정적 확인과 원문 수치의 산술 검산만 했다.
5. 바로 옮겨 쓸 수 있는 인수 기록
연구의 세 가지 증거를 한 줄의 완료 표시로 축약하지 않고 다음처럼 나눠 적을 수 있다. 빈칸은 미확인이며, 실패를 숨기기 위한 ‘대체 통과’ 칸이 아니다.
| 승인 칸 | 남길 내용 | 승인 범위 밖인 것 |
|---|---|---|
| 새 환경 재실행 | 원본·이관 커밋, 환경 설치 로그, 실행 ID, 종료 상태 | 작성자의 작업용 환경에서만 한 관찰 |
| 원 실험과 결과 출처 | 레시피, 데이터 분할, 학습 규모, 평가 로그, 지표 파일 연결 | 출처가 끊긴 숫자 또는 다른 변형의 점수 |
| 원 모델 가중치 | 같은 실행의 체크포인트, export 명령, 원 모델 로딩 결과 | 파일 존재만 확인하거나 다른 실행의 가중치 사용 |
| 수정 범위 | 동결한 파일·커밋, 허용한 변경, 실제 diff | 실행 스크립트를 통한 우회 재구현 |
예를 들어 학습과 평가가 끝났더라도 export를 확인하지 않았다면, 기록은 ‘학습·평가 확인 / 가중치 호환 미확인’이 된다. 모델을 로드했더라도 새 환경 로그가 없으면 ‘호환 확인 / 환경 재실행 미확인’이다. 이 방식은 결과를 무조건 실패로 몰기보다, 다음 담당자가 무엇을 이어서 확인할지 드러낸다.
아래 승인표는 연구 절차를 실무 인수 조건으로 바꾼 편집 분석이며, 실제 이관 성공률을 높였다는 실험 결과가 아니다. 모든 라이브러리 옵션의 동작 동등성, 장기 안정성, 운영 보안이나 비용 최적화까지 승인한다는 뜻도 아니다.
읽을 때 남겨둘 한계
근거는 2026년 11월 5일 제출된 arXiv v1 프리프린트와 고정 커밋의 저자 파일이다. 동료심사 승인 여부는 확인하지 않았다. 선정된 20개 저장소와 PyTorch/GPU→JAX/TPU 방향의 평가이며, 모델과 하네스가 함께 달라 현재 모델의 순수 성능 비교로 일반화할 수 없다. 저자 설명의 수치 통과와 judge 판정, 최종 가중치 검사는 서로 다른 관측 범위다. [1; 2]
원문에는 phase 2 대상 수의 108/110, 도메인 수의 14/10 차이가 있고, 프로젝트 페이지의 간략 요약과 상세 구성별 통과 수에도 차이가 있다. 이 글은 이를 임의로 화해시키지 않고, 최종 상세표와 본문이 일치하는 44/140 및 단계별 102개 결과만 핵심 계산에 썼다. 해당 불일치가 해소되었다고 주장하지 않는다. 선정 증거에는 원문 판본과 미해결 항목을 그대로 보존했다.
기존 GPU 전용 부록과의 차이를 TPU 하드웨어만의 인과 효과로 읽거나, 구성별 비용 상관을 ‘같은 모델에 돈을 더 쓰면 반드시 개선된다’로 바꾸지 않는다. 원시 궤적 전수 감사, 데이터셋 가용성 감사, 독립 TPU 재실행도 수행하지 않았다.
이 글은 AI를 활용해 작성·편집했다. 그림은 출처의 관계를 설명하기 위해 새로 제작한 도식이며 실제 제품 화면이나 학습 실행 캡처가 아니다. 관련 기존 글의 링크는 이번 검토에서 별도의 공개 본문 확인을 추가하지 않아 넣지 않았다. 동결된 주제와 직접 관련된 원문·저자 산출물로 범위를 제한했다.
결론: 인수 단위를 점수에서 증거 연결로
TPU 이관을 끝냈다는 말에는 세 가지 질문이 숨어 있다. 제출물만으로 새 환경에서 다시 실행됐는가, 원 실험이 실제로 만든 숫자인가, 그 실행의 가중치를 원 모델이 받아들이는가. XStack의 실용적 메시지는 한 점수를 더 좋은 점수로 바꾸는 요령보다, 이 세 질문의 답을 따로 남기는 데 있다. 점수는 중요한 결과지만, 이관 완료의 전체 영수증은 아니다.
참고 자료
- XStack 논문 v1 전체 본문 — §2.1–2.3, §3.1–3.2, Table 4, Appendix G–H. arXiv 판본 기록.
- 저자 README, 고정 커밋 — How it works, Layout.
- minGPT phase2 지시, 고정 커밋 — 허용 변경과 원 adder 레시피.
- 저자 judge 구현, 고정 커밋 — 판정 반복과 결합 규칙.
- minGPT criteria, 고정 커밋 — bar, bar_provenance, phase2_recipe.


댓글
댓글 쓰기