Imagine3D-LLM 공간 추론 7.6pp 향상, 재구성 학습의 효과를 어디까지 믿을까
여러 방향에서 찍은 방 사진을 보고 “책상 뒤 의자는 어느 쪽에 있는가”를 묻는 일은, 사진 한 장의 물체 이름을 맞히는 것과 다릅니다. 시점이 달라도 같은 물체를 묶고 서로의 위치를 이해해야 하기 때문입니다. Imagine3D-LLM은 이미지 표현에 외부 기하 정보를 더하는 대신, 언어모델 내부의 요약 토큰이 거친 3차원 장면을 재구성하도록 함께 학습시키는 접근을 제안합니다.
눈길을 끄는 결과는 같은 백본·자료·학습 일정으로 맞춘 기준선 대비 SPAR-Bench 평균 60.9% → 68.5%, 7.6퍼센트포인트(pp) 향상입니다. 그러나 이를 “3D를 상상하면 모든 공간 문제를 해결한다”거나 “추론 비용 없이 정확도가 오른다”로 바꿔 읽으면 핵심을 놓칩니다. 이 글의 목적은 연구 도입을 검토할 때 어떤 증거가 어떤 주장까지 뒷받침하는지 나누는 것입니다.
검토 대상은 Jung 외 연구팀의 arXiv:2609.38177v1입니다. 최초 제출일은 2026년 9월 29일이며, 저자 측 프로젝트는 NeurIPS 2026을 표기합니다. 이 글에서는 학회 proceedings나 심사 기록을 별도로 확인하지 않았으므로, 실제로 읽은 arXiv v1의 결과와 한계를 기준으로 설명합니다. 이 글은 보존된 논문 본문과 저자 저장소를 읽어 만든 분석이며, 모델 학습·추론을 독립 재현한 결과가 아닙니다.
1. ‘상상’은 인간의 인지가 아니라 재구성 학습이라는 설계다
논문 §3.2와 Figure 1에서 입력 순서는 이미지 토큰, 학습 가능한 Gaussian summary tokens, 텍스트 토큰입니다. 요약 토큰은 여러 이미지의 정보를 모읍니다. 중간 층의 요약 토큰 상태를 가우시안 디코더로 읽어 거친 3D Gaussian Splatting 표현을 만들고, 이를 입력 시점에서 렌더링한 이미지가 실제 입력과 닮도록 학습합니다. 언어모델의 답변 예측 손실, 광학적 재구성 손실, 교사 증류 손실을 함께 사용합니다.
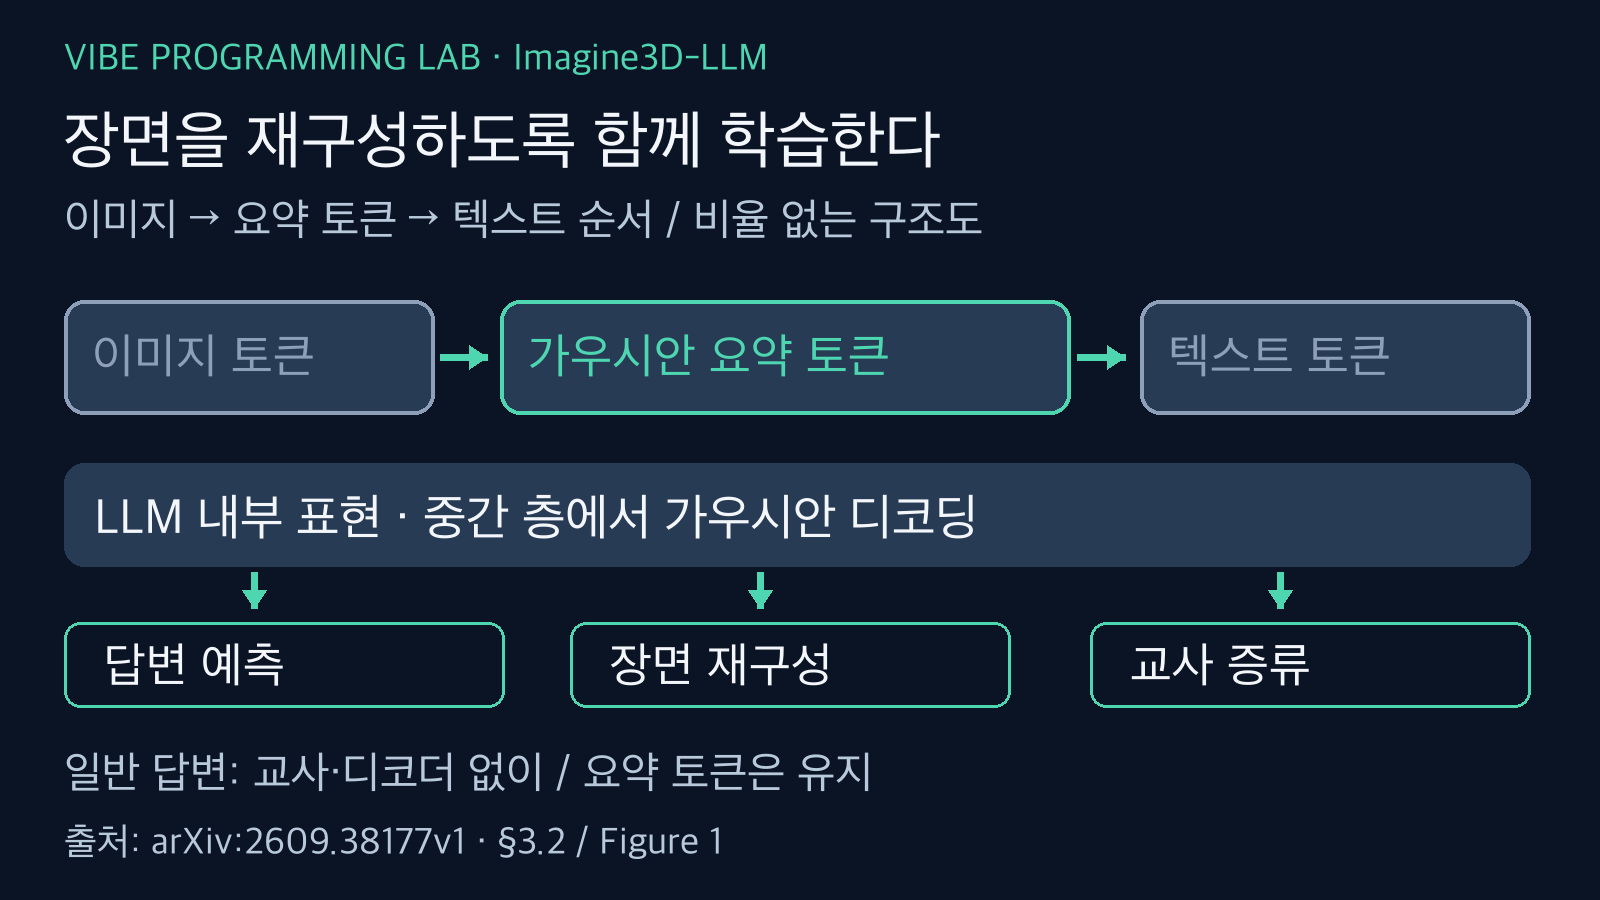
§3.2·Figure 1을 새로 그린 개념 도식. 상자 크기는 토큰 수나 계산량 비율이 아니다. 일반 답변에서 교사·디코더는 필요하지 않지만 요약 토큰은 유지된다. 출처: arxiv.org/html/2609.38177v1#S3.SS2.
동결된 ZipSplat 교사는 학습 때만 사용하며 수렴을 돕습니다. 일반 답변을 생성할 때는 교사를 실행하지 않고, 별도로 재구성 결과를 요청하지 않으면 가우시안 디코더도 실행할 필요가 없습니다. 그렇다고 요약 토큰이 사라지는 것은 아닙니다. 답변은 여전히 추가된 토큰을 포함하는 입력을 처리합니다. 여기서 “상상”은 장면 재구성을 학습 목표로 둔다는 비유이지, 인간과 같은 정신 작용이나 의식이 확인됐다는 뜻이 아닙니다.
주된 32시점 설정에서 이미지 토큰은 6,720개, 요약 토큰은 2,592개이며 요약 토큰 하나에서 가우시안 32개를 디코딩합니다(§4, Appendix A). 요약 토큰이 이미지 토큰보다 적다는 병목을 두어 시점마다 같은 물체를 별개로 복사하기보다 정보를 모으게 한다는 것이 저자의 설계 의도입니다. 다만 SPAR 입력은 장면에 따라 2·3·32시점이므로 모든 평가 입력이 32장이라고 일반화하면 안 됩니다.
2. 비교 기준을 먼저 맞추면 제목의 숫자가 달라진다
다른 논문의 표에서 가져온 모델 순위와, 같은 조건으로 훈련한 기준선과의 비교는 서로 다른 질문에 답합니다. 이 글은 후자인 §4.2 Table 4의 통제 비교를 중심에 둡니다. 백본은 LLaVA-Video-7B이며 훈련 자료와 일정도 같습니다. 기준선에는 가우시안 요약 토큰, 재구성 목표, 증류 목표가 함께 빠져 있습니다.
| 지표 | 같은 조건 기준선 | 전체 설계 | 차이 |
|---|---|---|---|
| SPAR-Bench 과제 정확도의 전체 평균 | 60.9% | 68.5% | +7.6pp |
| SQA3D test 정답 정확 일치(EM) | 56.5% | 63.8% | +7.3pp |
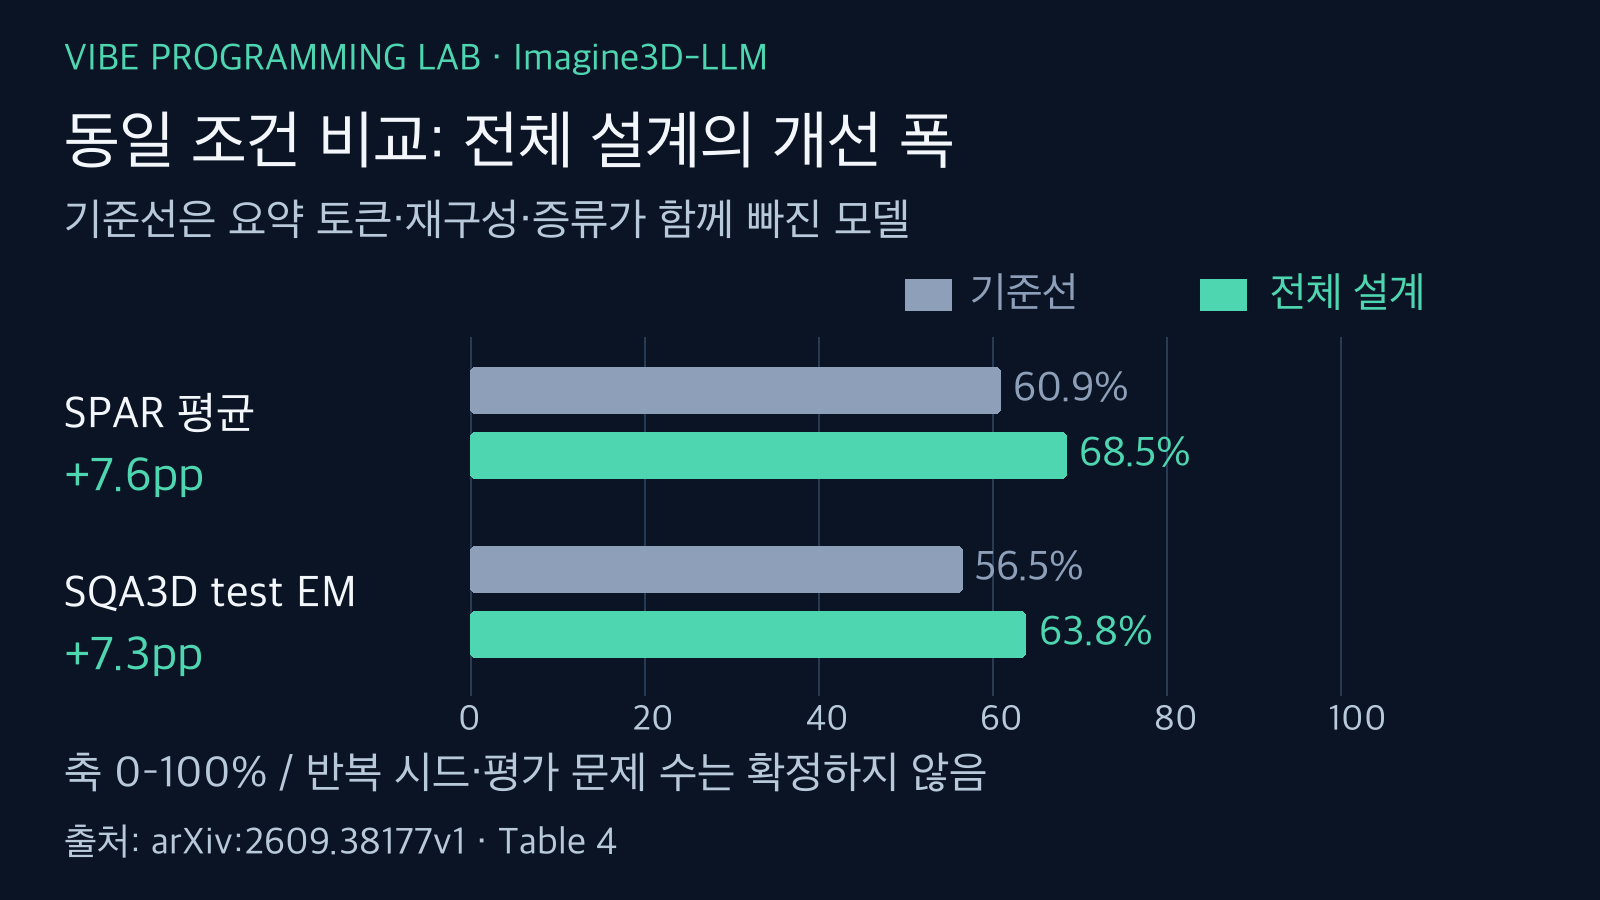
Table 4 저자 보고값을 0–100% 축으로 재작성했다. SPAR은 과제 정확도의 전체 평균, SQA3D는 test EM이다. 각각 +7.6pp·+7.3pp이며 독립 재현이나 통계적 유의성 판정이 아니다. 출처: arxiv.org/html/2609.38177v1#S4.T4.
7.6pp는 백분율 두 값의 차이입니다. “정확도가 상대적으로 7.6% 올랐다”는 표현과 같지 않습니다. SPAR 값은 논문이 보고한 과제 정확도의 전체 평균이며, 반올림된 평균에 임의의 문제 수를 곱해 전체 정답 개수를 만들 수 없습니다. SQA3D는 test 질문에 대한 EM입니다. 검토한 표와 평가 설명에서는 정확한 평가 질문 수와 반복 시드·오차 범위를 확정할 수 없었으므로, 이 글도 정답 개수나 통계적 유의성을 만들지 않습니다.
같은 백본·자료·학습 일정의 비교는 전체 설계의 이득을 보여주지만, 재구성 손실 하나의 효과를 따로 증명하지는 않습니다. 토큰 추가와 두 학습 목표가 함께 바뀌었기 때문입니다. Table 1의 제로샷 2D 모델 행을 Table 4 기준선으로 바꿔 끼우면 학습 효과까지 섞이므로 같은 의미의 개선 폭이 아닙니다.
3. 제거 실험은 ‘표현을 주기만 하면 된다’는 해석을 약하게 만든다
다음은 Table 7의 결과를 독자가 판단하기 쉽도록 다시 정리한 표입니다. 아래 모든 수치는 저자 보고값이고, 두 열은 앞 절과 같은 SQA3D test EM과 SPAR-Bench 평균입니다.
| 변형 | SQA3D (%) | SPAR (%) | 읽을 때 남겨야 할 조건 |
|---|---|---|---|
| 기준선 | 56.5 | 60.9 | 전체 설계의 비교 출발점 |
| 교사 토큰을 직접 입력 | 56.4 | 60.8 | 이 방식의 표현 주입만으로는 향상이 보이지 않음 |
| 증류만 사용 | 56.6 | 60.5 | 요약 토큰이 있어도 재구성 목표가 없으면 기준선 근처 |
| 재구성만, 4 epoch | 63.7 | 67.9 | 더 긴 학습으로 전체 설계에 근접 |
| 전체 설계, 1 epoch | 63.8 | 68.5 | 재구성과 증류를 함께 학습 |
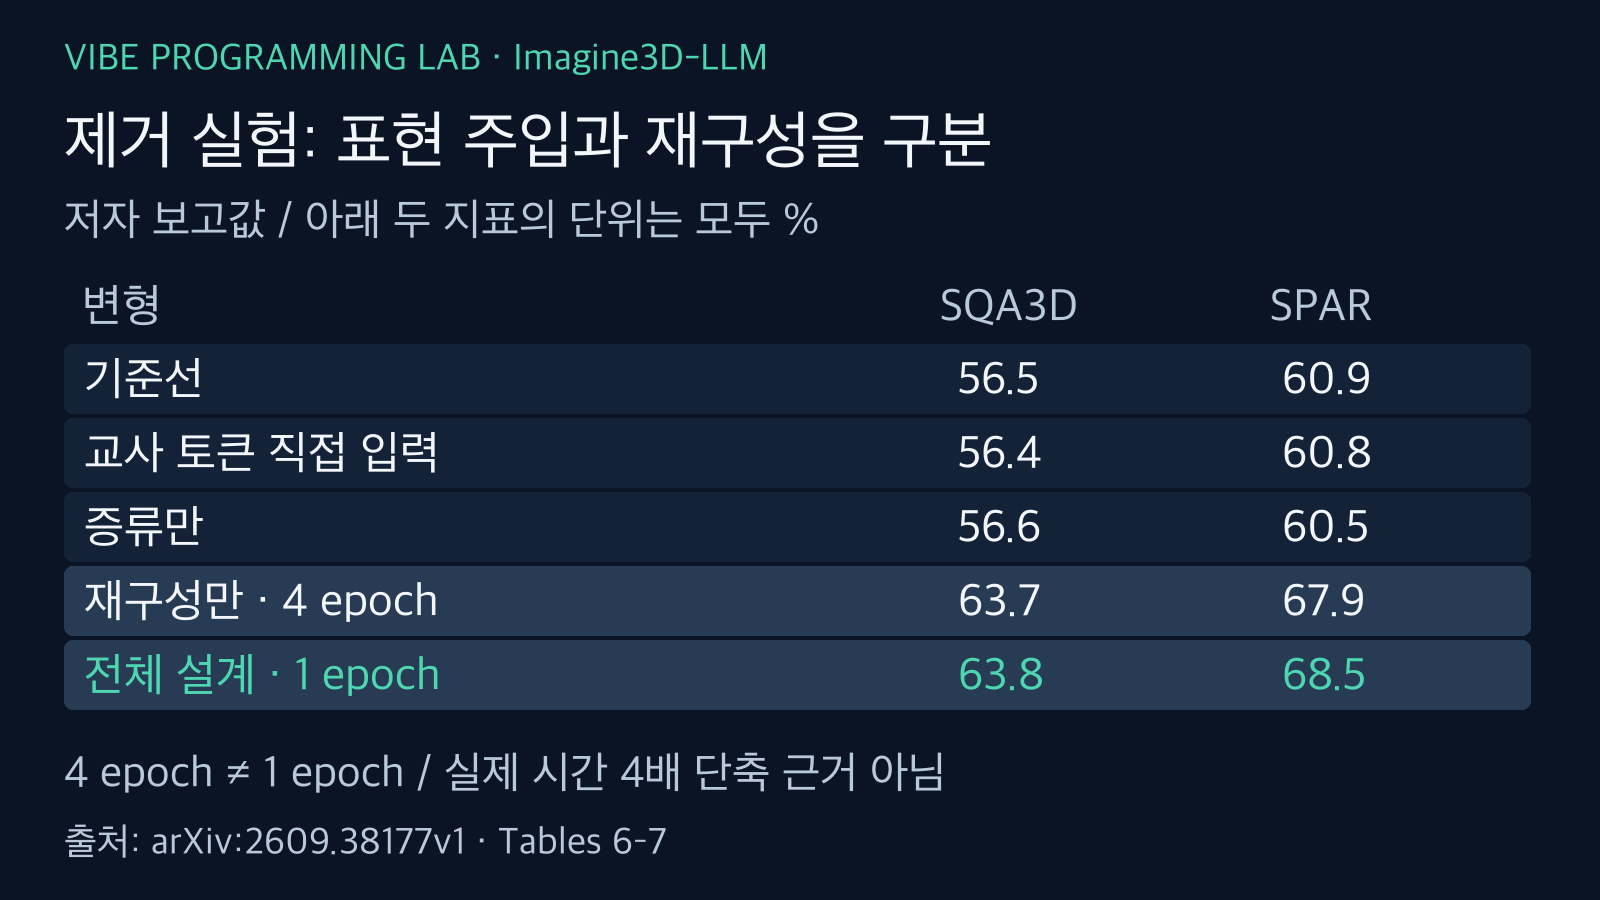
Tables 6–7의 제거 실험을 새로 정리했다. 두 열 단위는 %이다. 재구성만 4 epoch와 전체 설계 1 epoch는 학습 길이가 달라 실제 시간 4배 단축을 증명하지 않는다. 출처: arxiv.org/html/2609.38177v1#S4.T7.
이 결과는 해당 모델과 학습 구성에서 재구성 목표가 중요하다는 저자의 해석을 뒷받침합니다. “좋은 3D 특징을 붙이기만 해도 된다”는 단순한 설명은 두 제거 실험과 맞지 않습니다. 하지만 모든 특징 융합 방식이 무효라는 결론은 아닙니다. 교사 표현을 어떤 방법으로 연결했는지가 다르면 다른 결과가 나올 수 있습니다.
학습 길이도 분리해서 봐야 합니다. Table 6의 재구성만 사용한 변형은 1 epoch에서 57.7/57.6, 2 epoch에서 61.9/65.1, 4 epoch에서 63.7/67.9입니다. 전체 설계는 1 epoch에서 63.8/68.5입니다. 따라서 증류가 수렴을 돕는다는 해석에는 근거가 있지만, 4 epoch와 1 epoch를 비교해 실제 학습 시간이 4배 빨라졌다고 말할 수는 없습니다. epoch당 계산 비용과 총 벽시계 시간이 같은지 확인하지 않았기 때문입니다.
논문 §3.3의 attention·PCA·클러스터 그림은 내부 표현이 시점 간 물체를 더 일관되게 묶는다는 분석입니다. 이 시각화 자체가 질문의 정답률이나 로봇 안전을 증명하는 것은 아닙니다. 표현 분석은 메커니즘의 단서, 같은 조건의 과제 결과는 행동의 증거로 따로 읽는 편이 정확합니다.
4. 교사를 제거해도 추론 비용은 남는다
Appendix C.6의 Table 12는 SPAR 평가에서 피크 GPU 메모리와 샘플당 추론 시간을 보고합니다.
| 구성 | 피크 GPU 메모리 | 샘플당 추론 시간 |
|---|---|---|
| 기준선 7B | 17.09 GB | 112.1 ms |
| Imagine3D-LLM 7B | 20.43 GB | 176.9 ms |
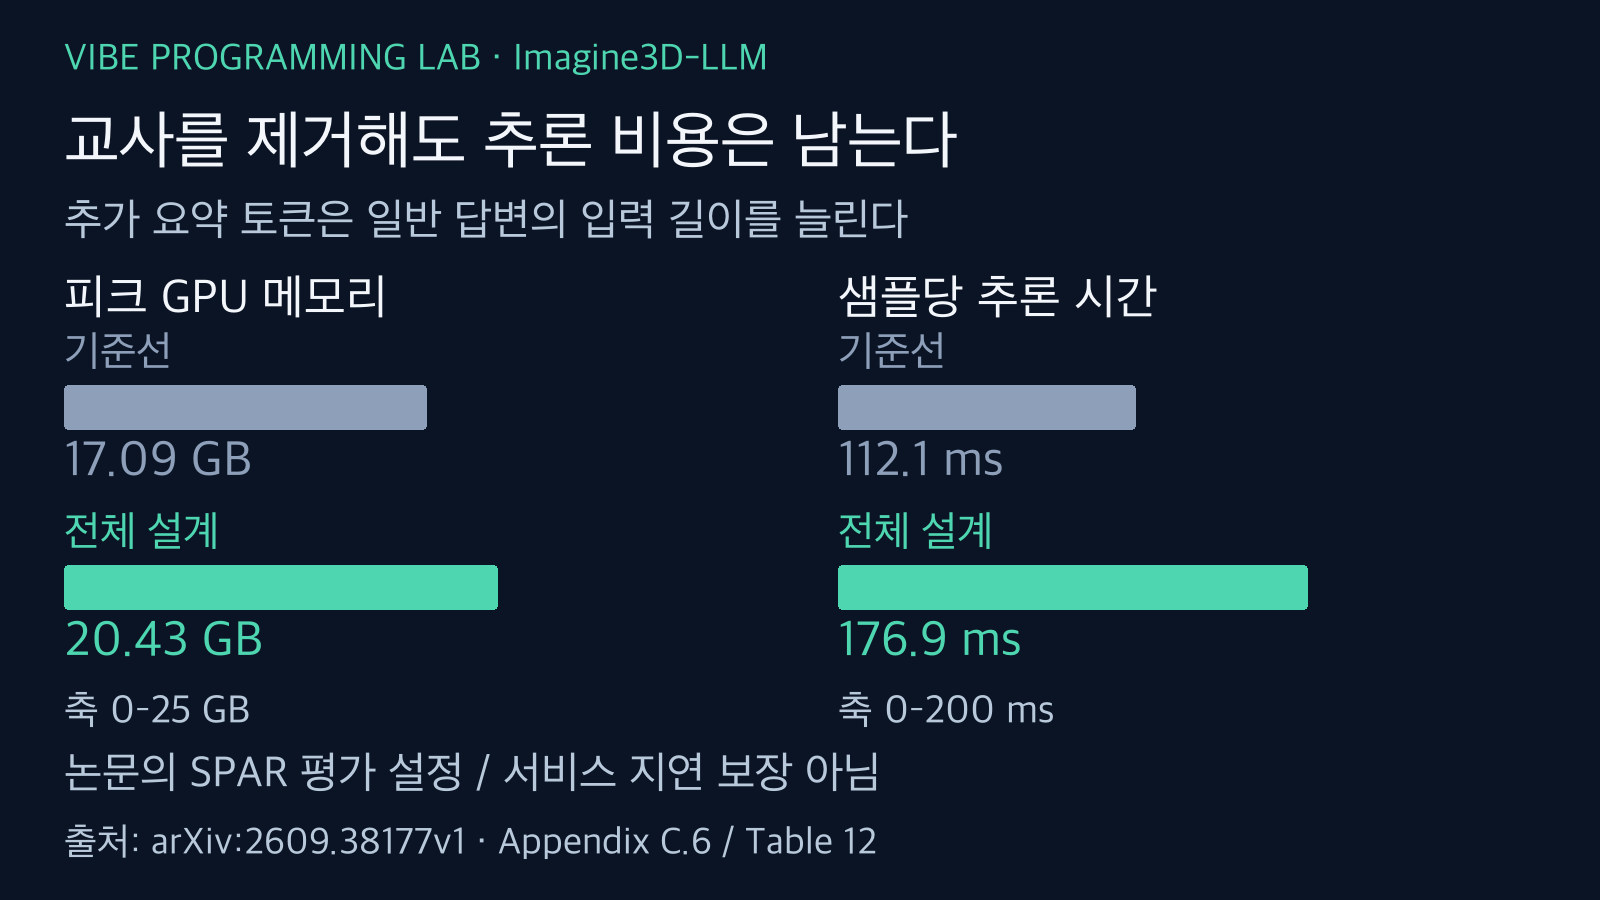
Appendix C.6·Table 12의 SPAR 평가 비용. 메모리 축은 0–25 GB, 시간 축은 0–200 ms로 단위를 분리했다. 추가 토큰의 비용을 보여주며 실제 서비스 지연이나 이 글의 실측을 뜻하지 않는다. 출처: arxiv.org/html/2609.38177v1#A3.T12.
교사와 재구성 디코더가 일반 답변 경로에서 빠진다는 설명과, 기준선보다 추론 비용이 크다는 표는 동시에 참일 수 있습니다. 추가 요약 토큰으로 입력이 길어지기 때문입니다. “외부 3D 모델이 필요 없다”를 “오버헤드가 없다”로 바꾸지 마세요.
이 표는 논문의 SPAR 평가 설정에서 측정한 값이지 이 글에서 측정한 지연이 아닙니다. 해당 비용 설명만으로 하드웨어·반복 횟수·온라인 요청 분포를 충분히 확정할 수 없으므로, 서비스 응답 시간이나 동시 처리량을 보장하지 않습니다. 배포를 검토한다면 같은 입력 시점 수와 출력 조건으로 정확도, 입력 처리 시간, 전체 지연, 메모리를 함께 비교해야 한다는 것이 이 글의 편집상 제안입니다.
5. 연구 채택 판단표: 무엇이 확인됐고 무엇을 더 물어야 하나
아래는 논문 결과를 운영·연구 검토 질문으로 재구성한 편집상 판단 도구입니다. 저자의 공식 인증 절차도, 새로 수행한 벤치마크도 아닙니다.
| 내 판단 질문 | 이번 증거가 말하는 것 | 아직 필요한 확인 |
|---|---|---|
| 우리 공간 질의에 재구성 학습을 검토할 가치가 있나? | 같은 조건 기준선 대비 두 지표가 개선됨 | 우리 장면·질문 분포에서도 같은 효과인지 |
| 3D 특징을 주입하는 것과 무엇이 다른가? | 직접 교사 토큰·증류만 변형은 기준선 근처 | 연결 방식·목표별 통제와 반복 측정 |
| 학습이 얼마나 빨라지나? | 긴 재구성-only와 짧은 전체 학습이 근접 | 동일 장비의 총 학습 시간과 자원 사용량 |
| 일반 답변 비용이 사라지나? | 교사는 제거되지만 Table 12 비용은 증가 | 같은 서비스 조건의 지연·메모리·처리량 |
| 지금 바로 재현할 수 있나? | 읽은 저자 저장소는 코드 공개 예고 단계 | 실제 학습·평가 코드, 가중치, 환경·입력 명세 |
주된 실험은 16 GH200 GPU, 유효 배치 64, 1 epoch라는 조건입니다(§4). 이를 개인 장치에서 곧바로 훈련할 수 있는 설치 안내로 받아들이지 마세요. 저자 저장소의 확인한 커밋 5956eaef5c935e864f79fba848c878f711fea70b에는 README와 이미지·배지 자산이 있으며, 학습·평가 코드와 데모는 README의 미완료 체크 항목입니다. 논문 배지에는 자리표시자 arXiv ID도 남아 있습니다. 저장소가 열린다는 사실은 재현 준비가 끝났다는 뜻이 아닙니다. 여기서는 실제 설치나 모델 실행을 시도하지 않았습니다.
실내 장면 중심의 훈련과 고정된 가우시안 예산은 저자가 적은 한계입니다(Appendix E). 더 크고 복잡한 실외 장면에 같은 성능이 보장되지 않습니다. 또한 본문 §4는 SPAR 훈련 부분집합을 100K, Appendix A는 104K라고 기술하므로 정확한 훈련 샘플 수는 미해결입니다. 어느 한 값을 확정된 분모로 채택하지 않았고, 핵심 비교의 성능값과 학습 샘플 수를 혼동하지 않습니다.
논문 Table 3에는 경쟁 모델 3DThinker의 인지 수준별 칸이 비어 있습니다. 그래서 “모든 인지 수준에서 모든 경쟁 모델을 이겼다”는 본문 문구를 검증된 결론으로 반복하지 않습니다. 이 글의 제목과 비교는 숫자와 기준선이 함께 확인되는 Table 4에 한정합니다.
결론적으로, Imagine3D-LLM은 이 설정에서 장면을 재구성하도록 학습하는 목표가 공간 질의 성능 개선과 연결된다는 유용한 근거를 제공합니다. 연구 채택의 다음 단계는 ‘상상하는 AI’라는 이름을 믿는 것이 아니라, 같은 조건 비교·목표별 제거·추론 비용·실제 공개 자산을 나란히 확인하는 것입니다. 일반 지능이나 실제 환경 안전까지 확인됐다고 넓히지 않는 것이 이 결과를 제대로 활용하는 방법입니다.
연결해서 읽을 글
- PA gap의 쓰임과 한계: 내부 표현의 기하와 질문 정답의 근거를 분리하는 읽기 방법이 연결됩니다. 같은 재구성 방법의 재현 연구라는 뜻은 아닙니다.
- DSpark의 디코드와 전체 지연 구분: 정확도 연구와는 다른 주제이지만, 특정 계산 경로의 절약을 전체 응답 비용으로 일반화하지 않는 운영 판단에 도움이 됩니다.
원문과 확인 위치
- Imagine3D-LLM, arXiv:2609.38177v1 초록·버전
- 논문 HTML 본문: §3.2·Figure 1(구조·손실·교사), §3.3(표현 분석), §4·Table 4(설정·통제 비교), Tables 6–7(제거·학습 길이), Appendix A(입력·훈련 부분집합), Appendix C.6·Table 12(추론 비용), Appendix E(한계).
- 저자 프로젝트: 논문과 저자 저장소의 연결.
- 확인한 저자 저장소 커밋: README의 공개 계획과 실제 트리 범위. 이후 변경이 있을 수 있으므로 재현 시 현재 자산을 다시 확인해야 합니다.
본문 그림은 위 근거의 구조·공개 수치를 독자용으로 새로 그린 도식과 표입니다. 저자 Figure나 모델 화면을 복제한 것이 아니며, 독립 실험의 결과 이미지도 아닙니다.


댓글
댓글 쓰기