AutoCompact: 오류를 기억한 요약이 왜 작업을 끝내 버릴까
코딩 에이전트의 긴 작업이 압축된 뒤 멈췄다. 요약을 읽어 보니 문제가 된 파일도 있고, 아직 해결하지 못한 구문 오류도 있다. 그런데 마지막 줄은 “추가 작업 없이 마무리”다. 정보를 잊은 것이 아니라, 기억한 정보가 다음 행동을 제약하지 못한 것이다. 요약에 필요한 항목이 들어 있는지만 검사하면 이런 실패를 놓칠 수 있다.
AutoCompact는 이 간극을 다룬 연구다. 언제 문맥을 압축할지, 작업 상태를 어떻게 남길지, 그 상태에서 어떻게 이어서 행동할지를 함께 학습시킨다. 독자에게 유용한 질문도 “요약이 얼마나 짧은가”보다 “요약 이후 행동이 기록된 미해결 상태와 맞는가”다. 이 글은 그 질문을 실제 작업 기록 검토에 쓸 수 있는 진단표로 바꾼다.
근거는 Xuan Zhang 외 연구진의 「AutoCompact: Learning When to Compact Context in Long-Horizon Coding Agents」, 2026년 10월 1일 제출된 arXiv v1 프리프린트다. 동료심사 통과는 확인하지 않았다. 보존된 원문 본문과 표를 읽은 분석이며, 모델을 학습하거나 성능을 독립 재현한 글이 아니다.
1. 압축은 저장 방식만이 아니라 행동 정책이다
논문 §2.1의 에이전트는 파일 읽기·수정·테스트처럼 compact()를 스스로 선택할 수 있다. 문맥 한도에 가까워져서만 작동하는 고정 임계값 방식과 달리, 버그 원인을 좁히고 구현 단계로 넘어가는 등 작업의 진전에 따라 압축할 수 있게 한다. 기존 과제는 그대로 두고 앞선 상호작용 이력을 작업 상태 요약으로 바꾼 뒤 이어서 실행한다.
여기서 학습 대상은 셋이다. 시점은 지금 탐색을 접어도 되는지, 상태는 확정한 결론·코드와 작업공간의 현황·남은 일을 제대로 남겼는지, 후속 행동은 그 기록을 실제로 따르는지다. 정확한 요약을 써도 이미 완료한 검색을 반복하거나 미해결 오류를 무시하고 종료하면 마지막 연결이 끊어진다. 큰 컨텍스트 창을 제공하는 것만으로 이 연결의 신뢰성이 확보되지는 않는다.
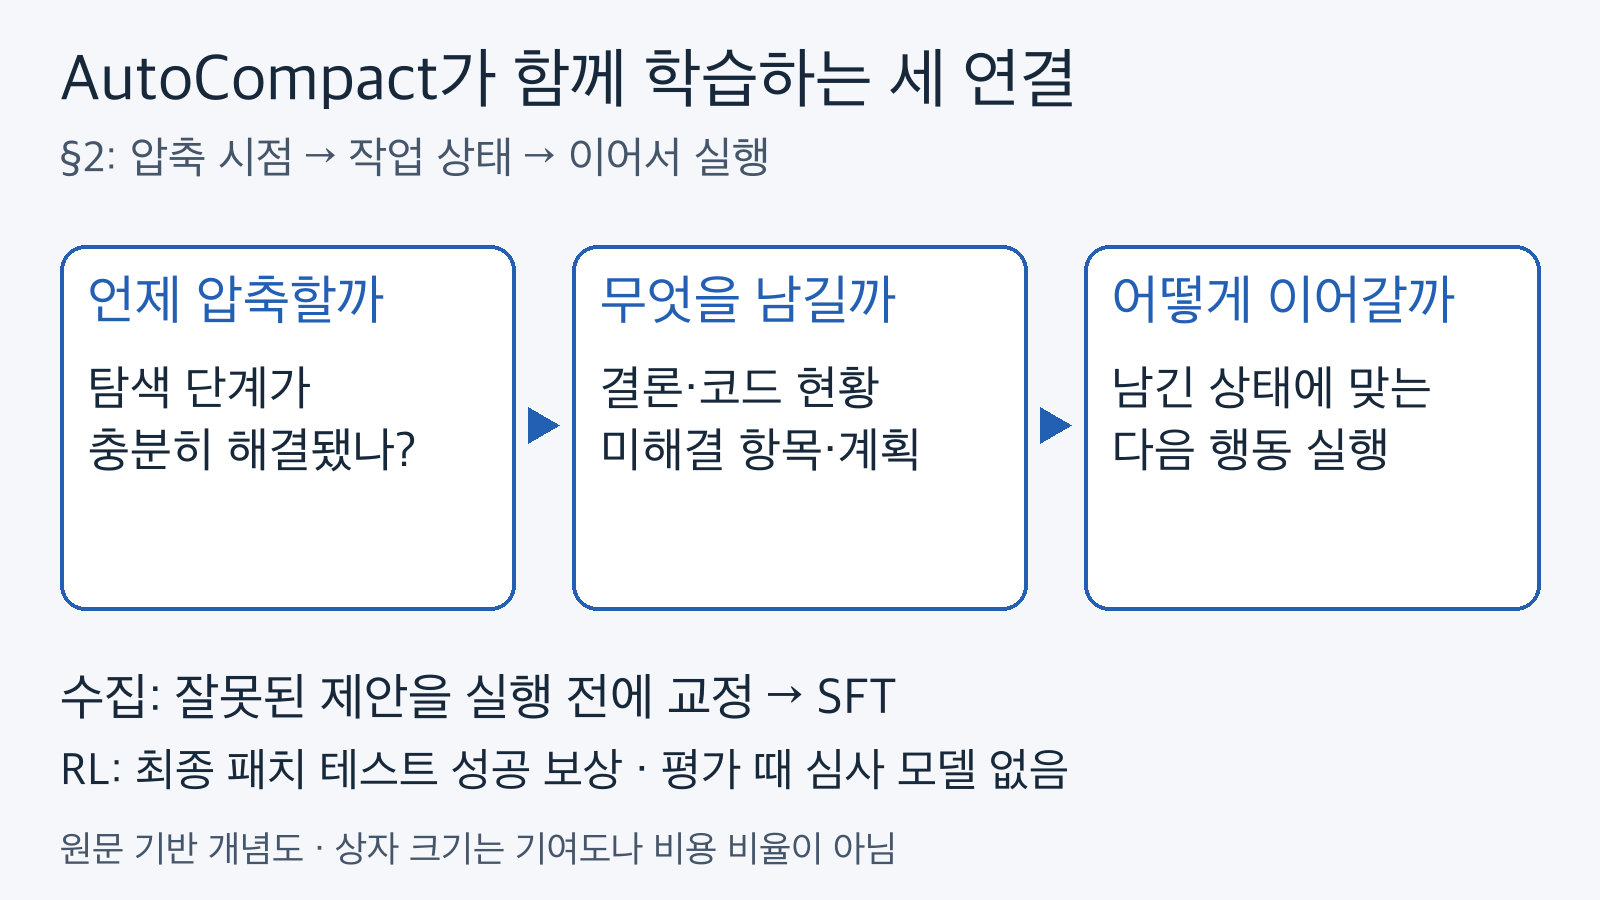
§2의 원문 기반 개념도. 학습 수집 중 실행 전에 교정하고 SFT·최종 과제 성공 보상 RL을 적용한다. 평가 때 심사 모델은 없으며 상자 크기는 기여도나 비용 비율이 아니다. 출처: arxiv.org/html/2610.02163v1#S2.
§2.2에서는 학습 데이터를 모을 때 심사 모델이 제안된 압축 시점, 요약, 압축 직후 행동을 검토한다. 잘못된 출력은 환경에서 실행되기 전에 교정된 출력으로 대체한다. 그러면 다음 행동도 교정된 이력 위에서 생성된다. 이미 끝난 실행 기록의 중간에 요약만 끼워 넣고 원래의 후속 행동을 유지하는 방식과 구별되는 부분이다.
기반 모델은 Qwen3-Coder-30B-A3B-Instruct이고 공통 터미널 REPL 하네스를 쓴다. 데이터 수집 중 심사는 GPT-5.5-Codex가 맡지만 평가 때는 심사 모델이 없다. SWE-rebench 379개 과제에서 필터링 후 남긴 1,052개 교정 궤적으로 지도 미세조정(SFT)을 한다. 1,052는 서로 독립적인 과제 수가 아니다. 이후 GRPO 기반 강화학습(RL)에서는 최종 패치가 과제별 테스트를 통과했는지에 따른 이진 보상을 사용한다. 별도의 압축 전용 보상 설계 없이 코드 작업과 문맥 관리를 함께 최적화한다.
2. 39.6%는 무엇의 성공률인가
Table 1의 SWE-bench Verified 결과는 다음과 같다. 같은 기반 모델과 하네스에서 출발하지만, 비교 모델들의 학습 상태는 다르다.
| 조건 | 과제 통과율 | 읽어야 할 범위 |
|---|---|---|
| Base | 30.4% | 전체 이력을 사용하는 기준선 |
| AutoCompact-SFT | 32.2% | 교정 궤적으로 지도 학습한 모델 |
| AutoCompact | 39.6% | SFT 이후 최종 과제 성공 보상으로 RL까지 적용 |
표는 추론 비용 상한을 두지 않은 전체 에이전트 실행의 결과다. SWE-bench Verified의 500개 과제를 평가하고, 정량 결과는 세 번 실행한 평균이다. 세 번 반복했다고 독립 과제가 늘어난 것은 아니다. 반올림된 평균에서 한 번의 실행에 정확히 몇 개를 해결했는지 역산해 확정할 수도 없다.
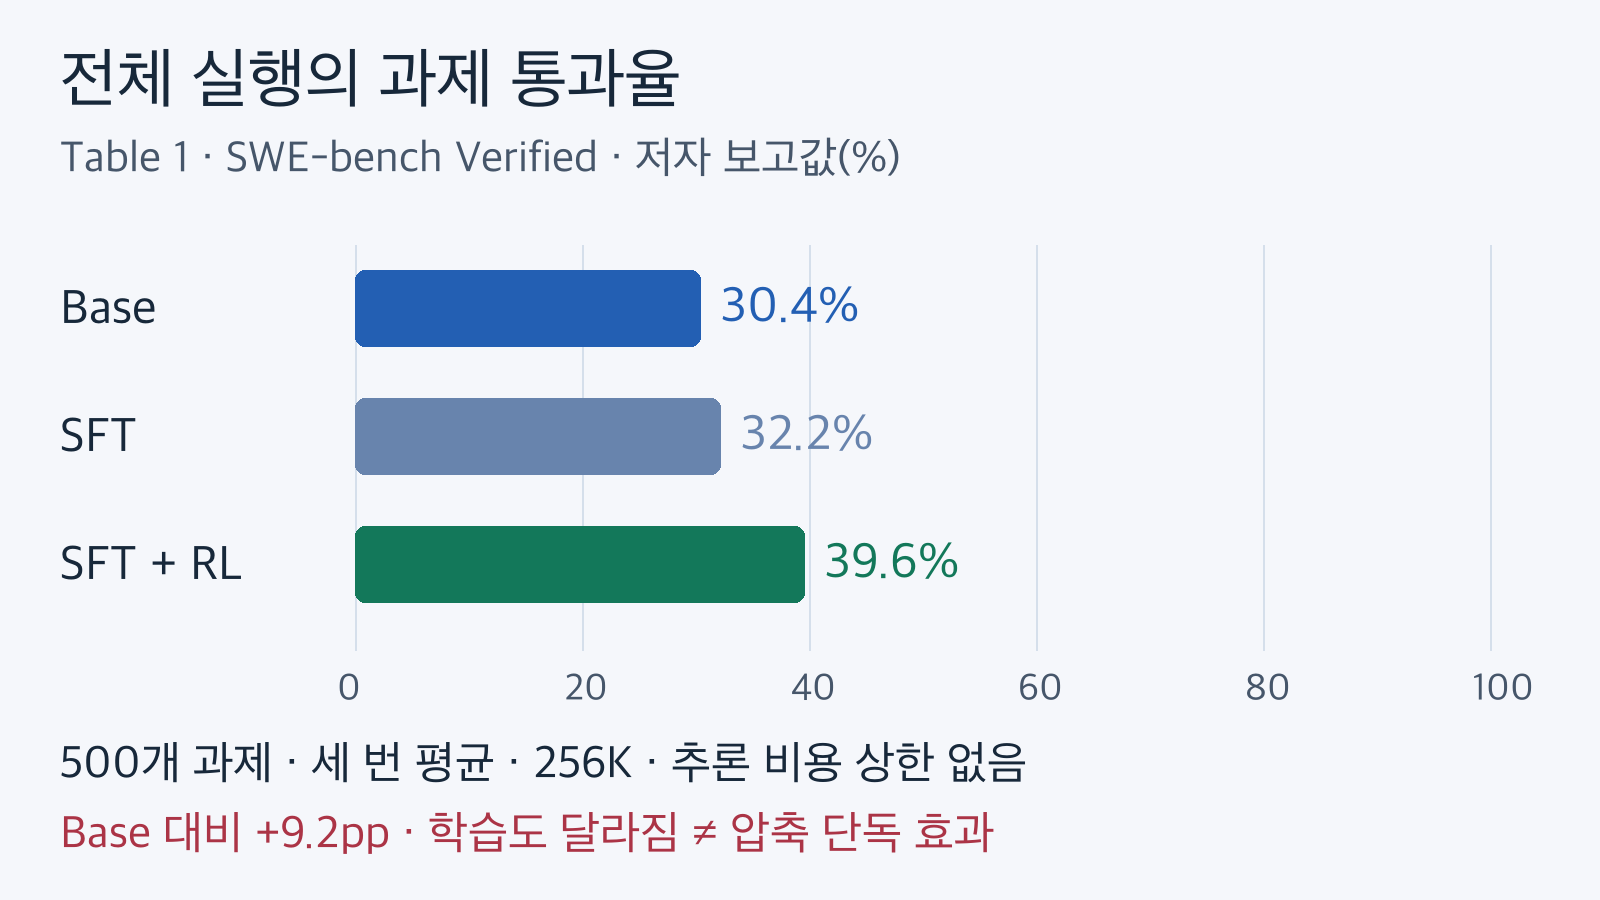
Table 1 저자 보고 통과율. 500개 과제·세 번 평균·256K·추론 비용 상한 없는 전체 실행이다. Base 대비 9.2pp는 학습도 달라진 비교이며 압축 단독 효과나 상대 개선율이 아니다. 출처: arxiv.org/html/2610.02163v1#S3.T1.
두 표시값의 차이는 9.2퍼센트포인트(pp)다. 상대 개선율 9.2%라는 뜻이 아니다. 더 중요한 주의점은 이 차이를 전부 “요약 기능을 켠 효과”라고 부를 수 없다는 것이다. Base에서 완성된 AutoCompact로 넘어가면서 모델 학습도 달라졌다. 요약 버튼 하나만 같은 모델에 붙여 비교한 실험이 아니다. 논문이 확정적으로 보여 주는 것은 해당 모델·하네스·평가 구성에서 완성된 학습 시스템의 통과율이 더 높았다는 점이다.
다른 모델이나 실제 업무 저장소에서 같은 향상을 보장하지 않는다. 이 글은 신뢰구간이나 통계적 유의성을 새로 주장하지 않는다. PolyBench의 수치를 별도 핵심 지표로 더하지 않은 이유도 선택한 근거에서 평가 과제 수를 명시적으로 확인하지 못했기 때문이다. 좋은 숫자를 많이 옮기는 것보다 지표의 분모를 보존하는 편이 낫다.
3. 같은 체크포인트에서 압축을 빼면 무엇을 알 수 있나
학습 자체의 효과와 실행 중 압축의 기여를 구별하기 위해 §3.3·Figure 3(d)는 같은 학습된 체크포인트를 비교한다. 정상 조건은 compact()를 실행하고, Summary-ignored 조건은 호출을 무시하여 요약을 생성하지 않은 채 기존 이력으로 계속한다. 학습된 매개변수는 양쪽에 그대로 남는다.
논문은 시험한 여섯 작업당 추론 예산에서 정상 압축 쪽의 통과율이 더 높다고 보고한다. 예산은 0.10·0.20·0.40·0.80·1.20·4.00달러이며, 누적 추론 비용이 예산에 도달하면 실행을 중단한다. 여기서 비용은 토큰 사용량과 Alibaba Model Studio 요율로 추정한 값이다. 캐시 입력은 일반 입력 단가의 20%로 계산했다. 실제 장비 운영비나 작업 완료까지의 벽시계 시간을 측정한 결과가 아니다.
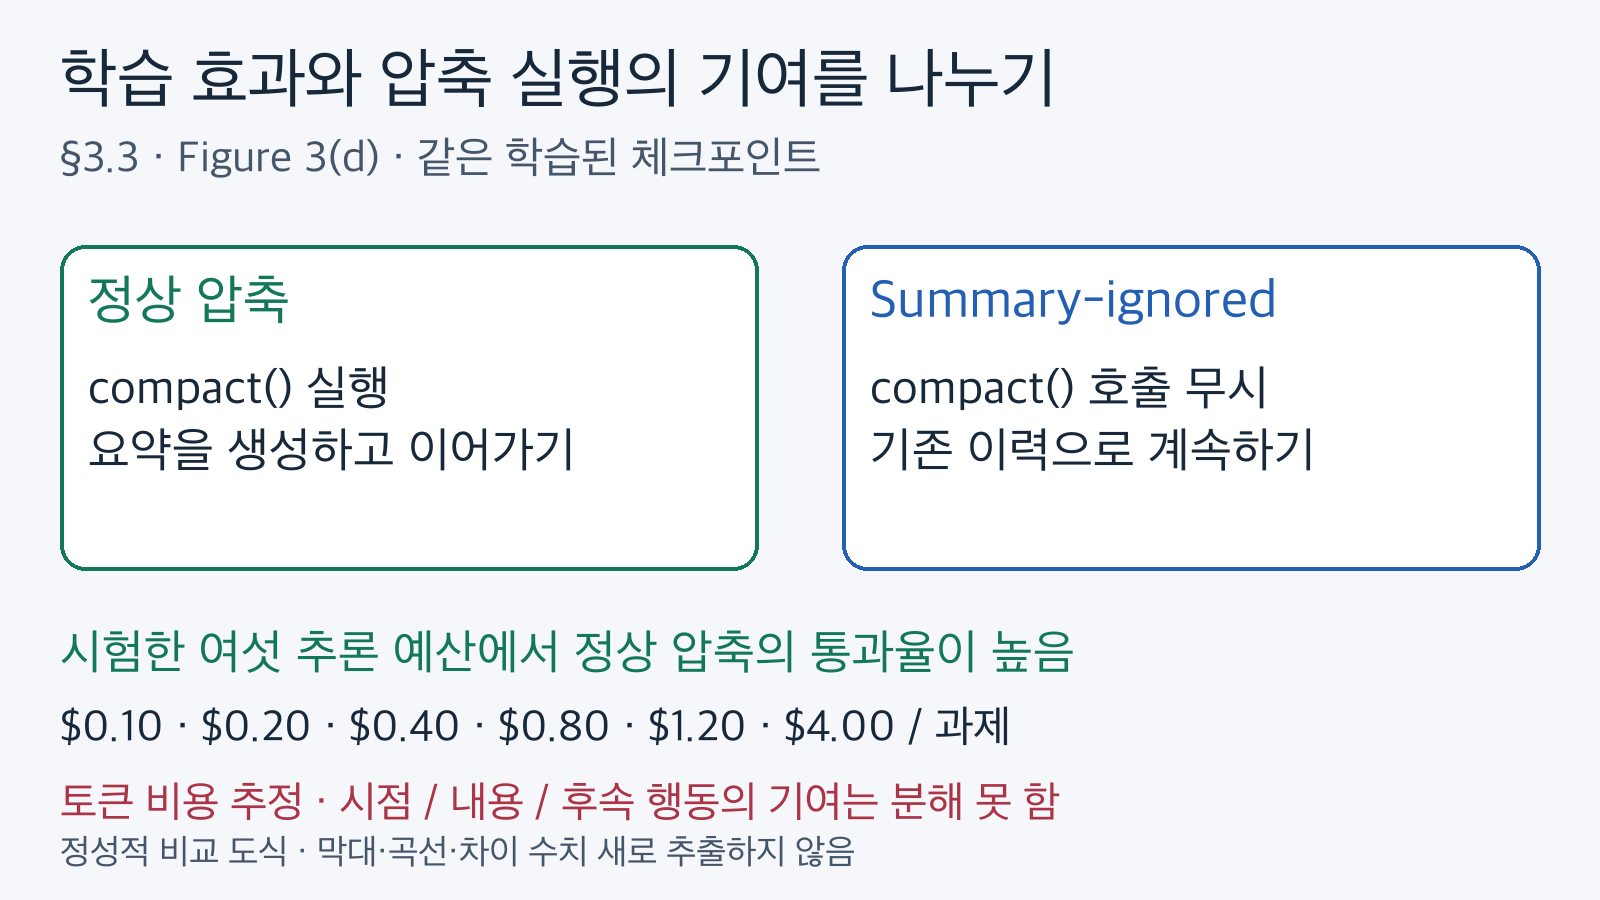
§3.3·Figure 3(d)의 비교 설계와 정성적 방향만 도식화했다. 여섯 예산은 작업당 추론 토큰 비용 추정이며 장비 비용·벽시계 속도가 아니다. 시점·내용·후속 행동의 개별 기여는 분해하지 않는다. 출처: arxiv.org/html/2610.02163v1#S3.SS3.
이 비교는 학습된 매개변수만으로는 설명되지 않는 압축 실행의 기여를 뒷받침한다. 하지만 시점 선택, 요약의 내용, 요약 이후 행동 가운데 어느 하나가 얼마를 기여했는지까지 분해하지 않는다. 유한 예산의 곡선과 비용 상한 없는 Table 1을 섞어 해석하지 않는 것도 중요하다. 본문은 곡선의 차이를 새 숫자로 추출하거나, 이를 전체 9.2pp의 구성 비율로 바꾸지 않는다.
실무에서 비슷한 원인 분리를 하고 싶다면 “학습한 모델과 학습하지 않은 모델” 비교와 “같은 모델에서 특정 동작만 허용하거나 막은 비교”를 서로 다른 실험으로 기록해야 한다. 이는 이 연구의 비교 설계에서 얻은 편집상 제안이지, 제품에서 이미 검증된 운영 절차라는 뜻은 아니다.
4. 오류를 보존했는데도 실패한 한 사례
Figure 5는 SWE-bench Verified의 django-13809 과제에서 두 모델의 요약과 최종 결과를 보여 준다. 원문은 이 요약들을 재서술한 사례라고 명시한다. SFT 모델은 해결하지 못한 구문 오류를 기록하고도 추가 조치 없이 끝내자고 제안했고, 해당 실행은 SyntaxError로 실패했다. RL까지 학습한 모델의 요약은 매개변수와 조건 로직 변경이 끝났다고 기록하고 제출 전에 검증하자고 제안했으며, 해당 실행은 테스트를 통과했다.
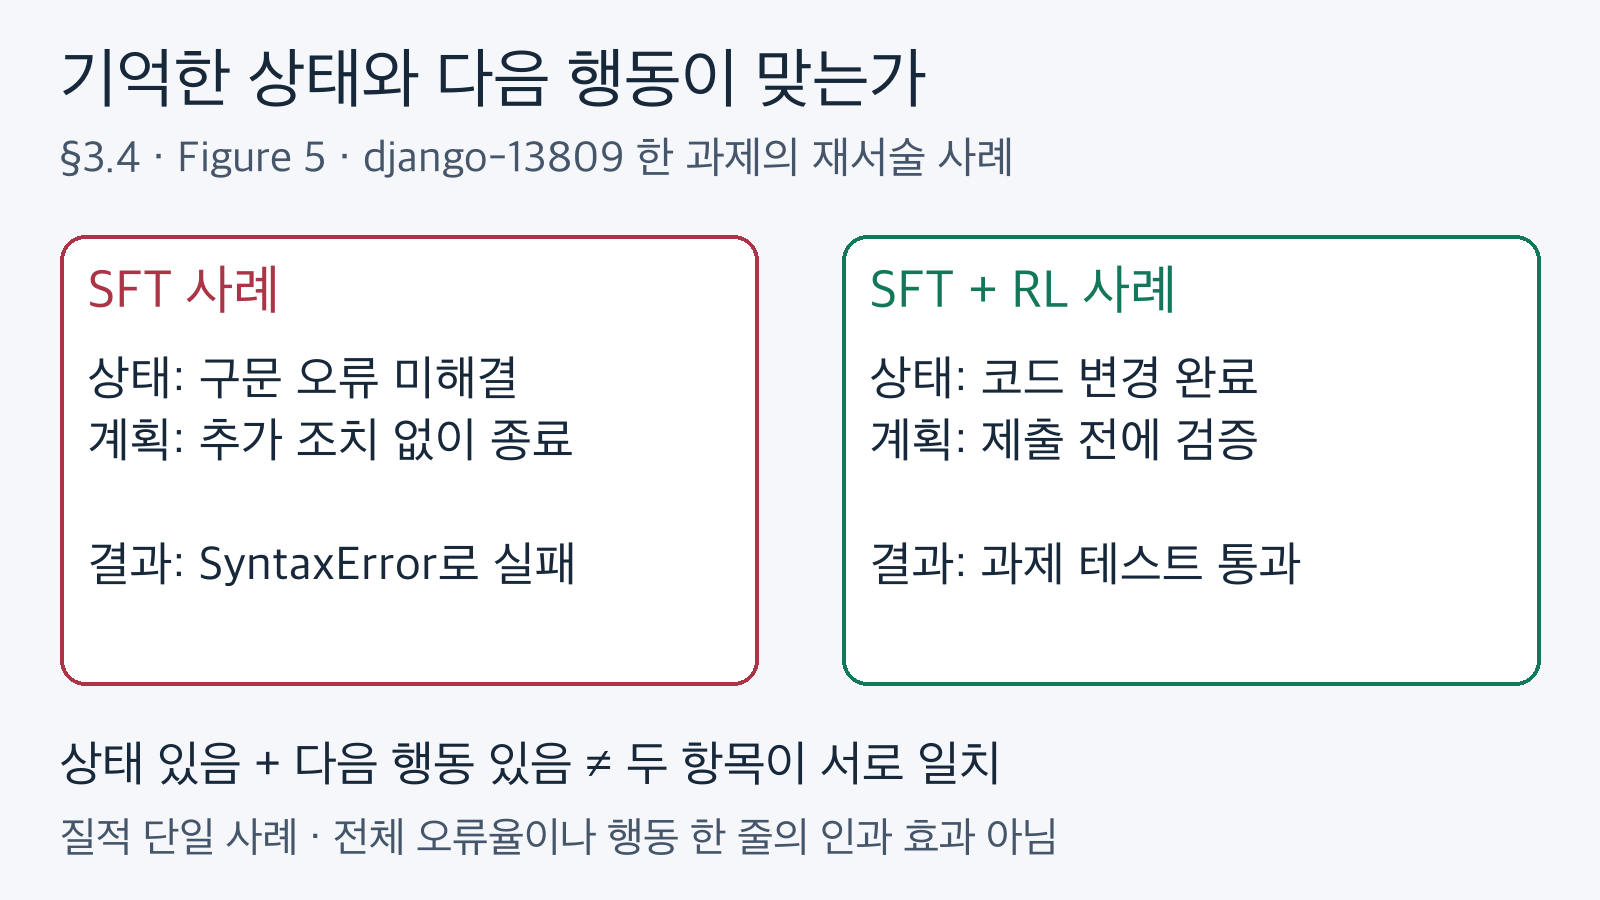
§3.4·Figure 5의 저자 제시 재서술 사례. SFT는 오류를 남기고도 종료를 계획해 실패했고 RL 변형은 변경 완료 후 검증을 계획해 통과했다. 단일 질적 사례이며 원시 독립 실행 기록·전체 오류율·한 행동의 인과 효과가 아니다. 출처: arxiv.org/html/2610.02163v1#S3.SS4.
이것은 이름이 있는 한 과제의 질적 사례다. 전체 과제에서 이런 모순이 얼마나 자주 발생하는지 나타내는 오류율도, 같은 난수 시드로 반복해 원인을 확정한 실험도 아니다. 두 경로의 작업 상태도 다르므로 단지 다음 행동 한 줄만 바꾸면 실패가 성공으로 바뀐다는 주장을 할 수 없다.
그래도 검토 관점은 얻을 수 있다. “상태 항목 있음”과 “다음 행동 항목 있음”을 각각 통과시켜도, 두 항목이 서로 모순되면 쓸 수 없는 요약이다. 미해결 상태가 남아 있다면 다음 행동은 그 상태를 해결하거나 검증하는 방향이어야 한다. 정보 보존 검사에 상태와 행동 사이의 관계 검사를 더해야 한다.
5. 압축 직후 실행을 검토하는 진단표
아래 진단표는 논문의 사례에서 도출한 편집자 제안이며, 실제 에이전트에서 효과를 측정한 결과가 아니다. 압축 전후 기록을 읽는 팀이 실패를 한데 묶지 않도록 구성했다. 특정 제품의 설정 튜토리얼이나 실행 가능한 자동 채점 규칙이 아니다.
| 기록에서 발견한 상황 | 구별할 문제 | 다음에 확인할 증거 |
|---|---|---|
| 오류는 요약에 있는데 다음 계획이 종료다 | 상태–계획의 자기 일관성 | 오류 해결 또는 검증을 가리키는 계획이 있는지, 최종 테스트 결과가 무엇인지 |
| 파일과 미해결 오류가 요약에서 사라졌다 | 작업 상태 보존 | 압축 직전의 실제 파일·오류 기록과 요약의 대응 |
| 요약은 수정을 지시하는데 직후 같은 검색을 반복한다 | 계획–실행의 후속 행동 일치 | 압축 이후 첫 도구 호출과 새 검색을 정당화할 추가 정보 |
| 아직 원인 탐색 중인데 결정적 출력이 버려졌다 | 압축 시점의 적절성 | 압축 당시 단계가 정말 해결됐는지, 버린 출력이 다음 판단에 필요했는지 |
| 검증하겠다는 계획은 있지만 테스트 반환값이 없다 | 검증 증거의 부재 | 실행한 명령, 반환 코드, 최종 산출물의 상태; 없으면 판정 보류 |
여기서 계획과 실행은 다른 열이다. 요약에 “테스트하겠다”고 적힌 것을 테스트 수행으로 채점하면 논문이 문제 삼는 간극을 다시 만든다. 반대로 같은 검색이 반복됐다는 이유만으로 무조건 실패로 판정해서도 안 된다. 파일이 바뀌었거나 기존 검색이 불충분했다면 반복이 필요할 수 있다. 다음 행동이 기록된 현재 상태와 왜 맞는지 설명할 수 있는지를 확인하는 도구로 써야 한다.
예를 들어 팀의 버그 수정 기록에는 압축 직전 상태, 요약의 미해결 항목, 제안된 다음 행동, 직후 실제 도구 호출, 최종 테스트 결과를 나란히 남길 수 있다. 이 묶음은 오류가 삭제됐는지, 보존됐지만 무시됐는지, 계획은 맞는데 실행이 벗어났는지를 나누는 데 쓰인다. 새로운 오류율이나 생산성 개선 수치를 이 표만으로 만들 수는 없다.
6. 지금 제품 설정으로 바로 옮길 수 없는 이유
저자들은 자원 제약 때문에 RL을 32K 토큰 시퀀스로 학습했고, 평가에는 256K 컨텍스트 창을 사용했다고 밝힌다. 또한 모델과 하네스를 함께 설계한 결과를 하나의 스캐폴드에서 연구했다. Codex나 Claude Code 같은 하네스로 학습된 선제 압축을 옮기는 것은 향후 과제다. 이 논문을 해당 제품의 새 옵션 출시나 지금 설치 가능한 플러그인 안내로 읽으면 안 된다.
확인한 v1 본문에는 AutoCompact 전용 저자 코드·체크포인트·원시 결과 저장소 링크를 찾지 못했다. 이것은 어디에도 그런 저장소가 없다는 증명이 아니다. 본문에 나온 관련 터미널 에이전트 글이나 요금 링크를 AutoCompact 재현 패키지로 대신 소개하지 않는다. 현재 독자가 바로 활용할 수 있는 것은 모델을 바꾸는 설치 절차가 아니라, 기록된 상태와 그 뒤의 행동을 함께 평가하는 관점이다.
함께 읽기
- 요약을 다시 요약하지 않는다: CliffCompaction을 적용하기 전에 남겨야 할 상태: 임계값 기반 삭제와 재독의 문제를 다룬다. 이 글의 학습된 압축 정책·후속 행동과는 비교의 층이 다르다.
- 코딩 에이전트 하네스는 만능 설정이 아니었다: 176개 조건이 보여 준 설계의 조건부 효과: 외부에서 정한 하네스 조건의 효과를 읽을 때 참고할 수 있다. 학습된 시점·상태·이어가기의 분리 검증으로 확대 해석하지 않는다.
원문과 근거 범위
- 논문 v1 초록·저자·제출 정보: 프리프린트 신원과 버전.
- §2 Method: 압축 행동, 실행 전 교정, SFT와 과제 성공 보상 RL.
- §3.1·Table 1: 기반 모델·공통 하네스·훈련 궤적·세 번 평균과 전체 실행 통과율.
- §3.3 Further Analysis: 같은 체크포인트의 압축 실행 여부 비교와 비용 조건.
- §3.4·Figure 5: 재서술 요약의 상태–다음 행동 자기 일관성 사례.
- §5 Conclusion / Limitations and future work: 학습 길이·단일 하네스와 향후 제품 전이의 한계.


댓글
댓글 쓰기