Gemini 4 Argon: 100만 출력 토큰과 제한 배포를 분리해 읽기
Google의 9월 30일 Gemini 4 Argon 발표에서 눈에 띄는 숫자는 100만 토큰이다. 하지만 이 숫자만 보고 “큰 저장소를 통째로 입력할 수 있다”거나 “내 계정에서 지금 긴 작업을 돌릴 수 있다”고 결론 내리면 서로 다른 조건을 한데 섞게 된다. 발표가 확대한 것은 출력 토큰 상한이고, 현재 배포 대상으로 밝힌 것은 Fairwind Program을 통한 일부 신뢰받는 사이버 방어자다. 큰 출력 예산과 넓은 이용 권한은 같은 소식이 아니다.
이 글의 질문은 성능 순위가 아니라 도입 판단이다. 저장소의 여러 파일을 고치고 결과를 검증하는 장시간 업무를 계획한다면, 이번 발표에서 무엇을 설계의 후보로 받아들이고 무엇을 확인 전까지 보류해야 할까? 원문이 말하는 범위를 먼저 나눈 뒤, 실제 도입 검토에 쓸 판단표와 코드 수정 업무의 반례를 제시한다.
100만은 입력창이 아니라 생성 쪽의 상한이다
원문의 「Working harder on your most complex problems」는 출력 토큰 한도를 종전 64K에서 1M 토큰으로 확대한다고 명시한다. Google은 긴 추론 궤적과 복잡한 다단계 문제를 지원하기 위한 여유라고 설명한다. 여기서 1M은 100만 토큰이라는 출력 상한의 표기다. 문서가 들어가는 입력 컨텍스트 크기, 실제 응답에서 반드시 쓰는 분량, 업무 성공률을 나타내는 수치가 아니다.
따라서 “100만 출력이 가능하다”를 “100만 입력이 가능하다”로 바꿔 읽으면 안 된다. 한 번의 생성에 얼마나 많은 토큰을 허용하는지와, 요청 시 어떤 자료와 상태를 넣을 수 있는지는 별도 질문이다. 이 발표의 선택된 근거만으로 Argon의 입력 한도나 특정 API의 요청 옵션을 단정하지 않는다. 실제 이용 경로가 열리면 해당 경로의 문서와 계정 조건을 따로 확인해야 한다.
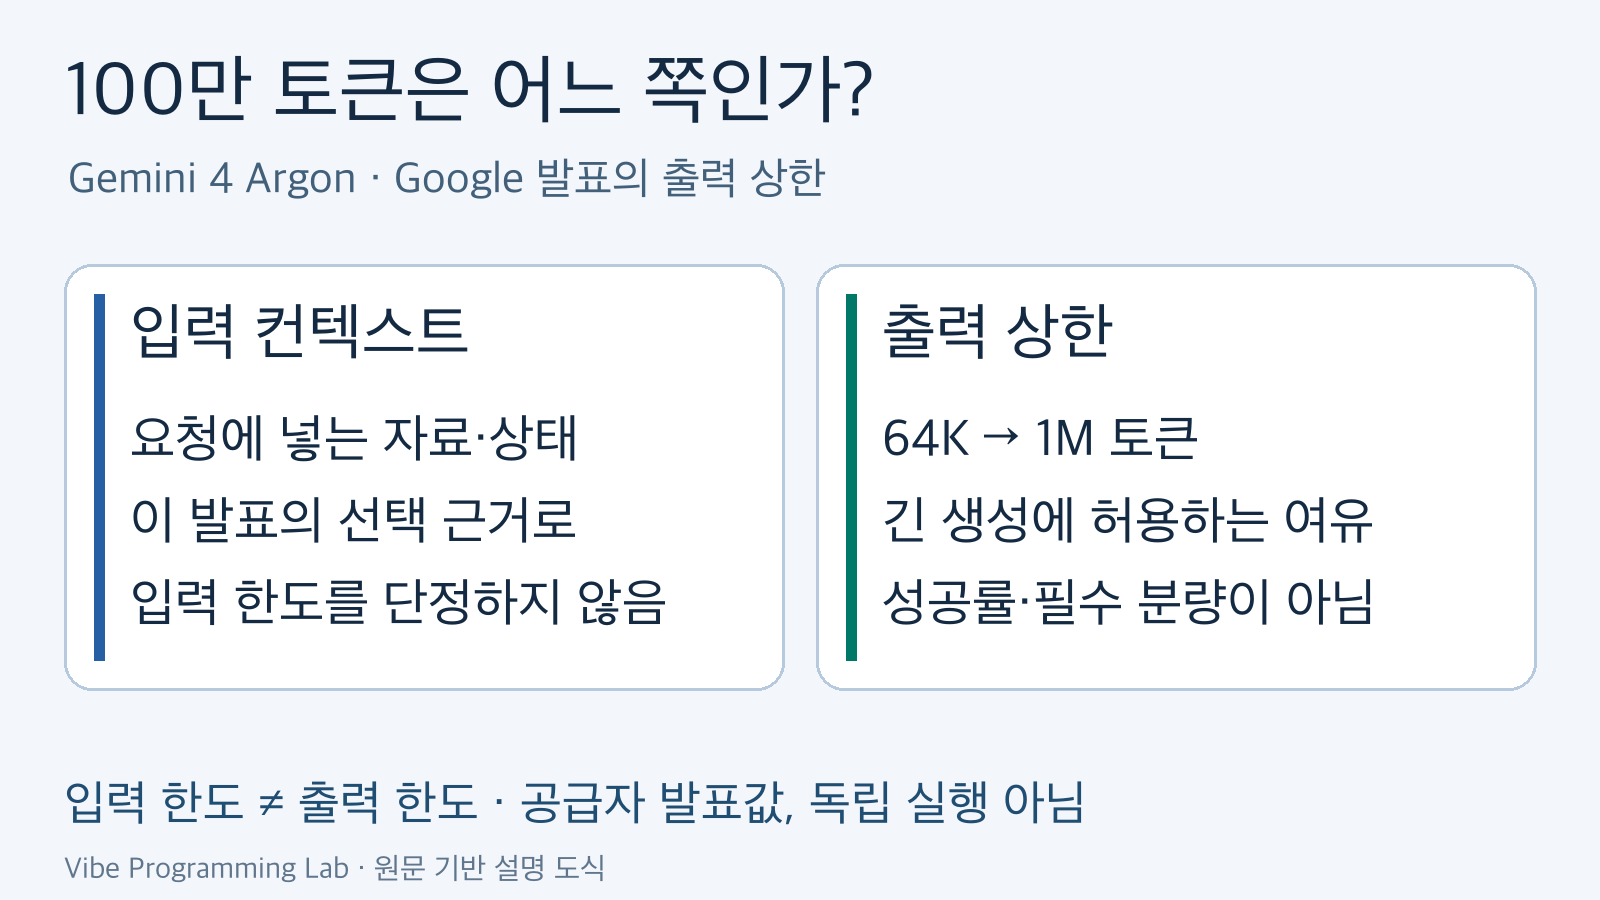
그림 1. 1M은 Google이 발표한 출력 상한이다. 입력 컨텍스트 한도나 성공률을 나타내지 않으며, 독립 실행 결과도 아니다. 출처: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon.
큰 출력 한도가 유용할 수 있다는 해석과 긴 출력이 항상 좋은 결과라는 평가는 또 다르다. 긴 작업이 중간에 끊기는 문제가 있다고 해서 무조건 최대 분량을 요청하는 설계로 옮길 필요는 없다. 검토할 산출물이 커지고 오류를 찾기 어려워질 수 있으므로, 작업의 완료 기준을 먼저 정하고 필요한 출력과 중간 기록을 구분하는 편이 낫다. 이는 저자의 업무 설계 제안이지, Argon에서 측정한 효율 개선 결과가 아니다.
현재 대상과 다음 배포 계획을 같은 시제로 쓰지 않기
발표 도입부는 Argon을 Fairwind Program을 통해 일부 신뢰받는 사이버 방어자에게 배포하고 있다고 쓴다. 이어 단계적인 접근 확대와 초기 사용자 피드백으로 보호 조치를 개선하겠다고 설명한다. 끝의 「Rolling out soon」에서는 개발자·기업·소비자로 확대하기 전에 시스템을 강화하고, 이후 유료 API 고객과 Google AI Ultra 구독자부터 출시할 계획을 언급한다.
여기에는 현재 제한 배포와 향후 확대 계획이라는 두 시제가 있다. Ultra 구독자라는 이름이 등장했다고 지금 모든 구독 계정에 Argon 사용 권한이 생겼다는 뜻은 아니다. 유료 API 고객부터 시작한다는 문장도 모든 개발자가 현재 호출할 수 있다는 확인이 아니다. 확인한 원문에는 일반 공개의 정확한 날짜가 제시되어 있지 않다. 그러므로 팀 일정표에 확정 도입일을 적기보다, 현재 가능한 업무와 접근 확인 이후의 업무를 나누어 적는 것이 정확하다.
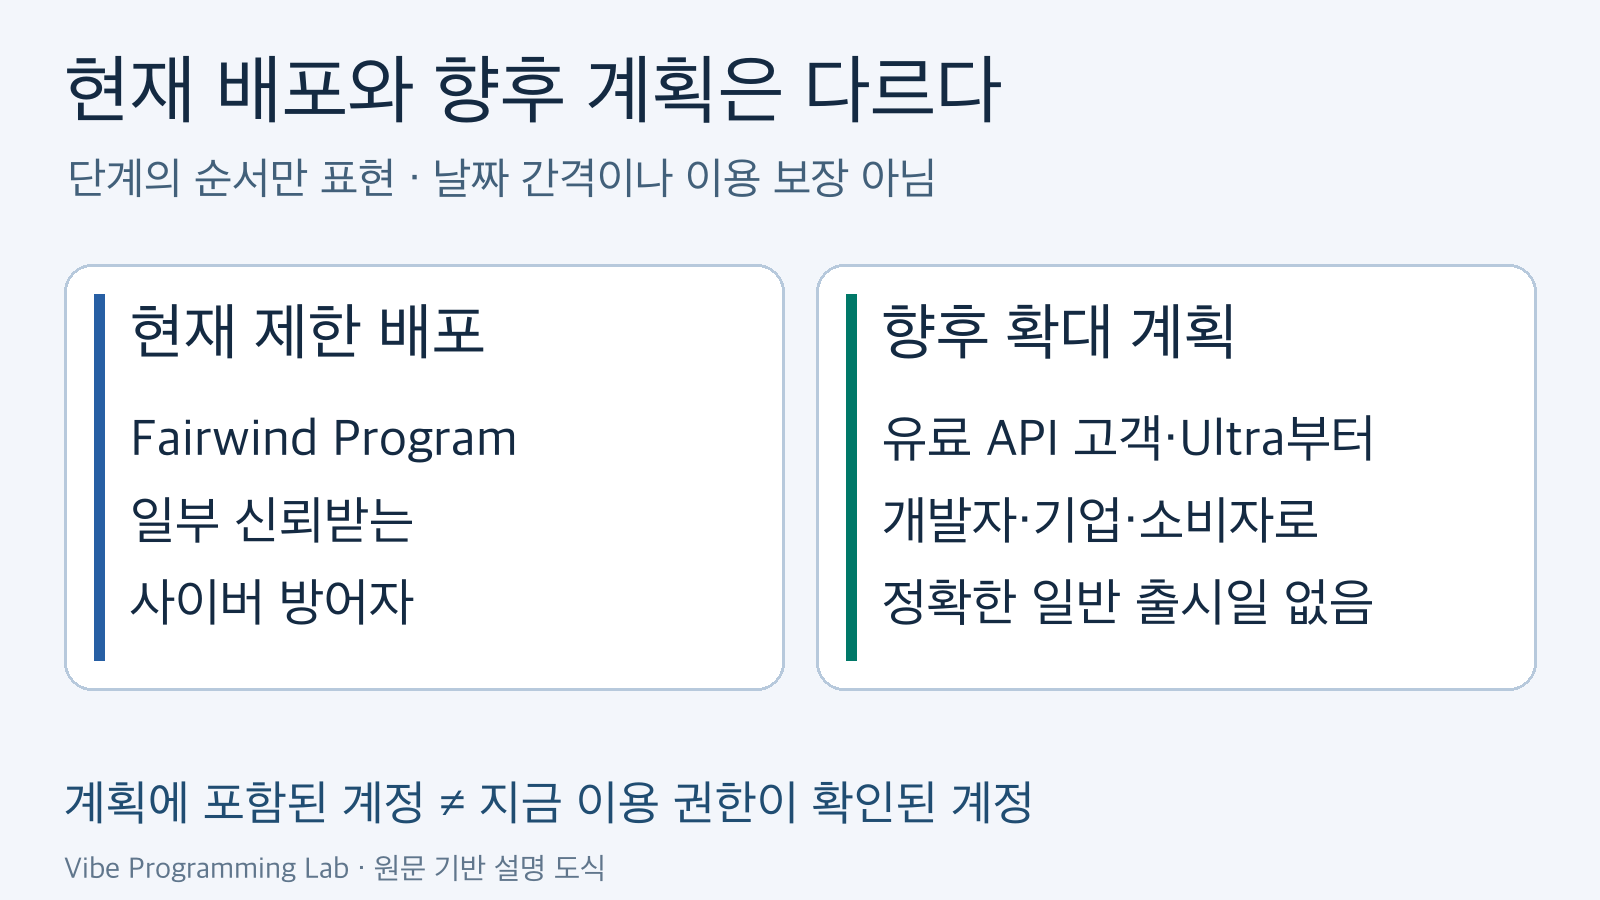
그림 2. 발표의 현재 시제와 미래 시제를 구분했다. 두 칸은 일정표가 아니며, 원문에 정확한 일반 출시일은 없다. 출처: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon.
예를 들어 기존 모델로 수행 중인 코드 정리 작업이 있다면, Argon의 발표만을 근거로 그 경로를 중단할 이유는 없다. 접근 가능성이 확인될 때까지 기존 완료 기준과 자료 준비 절차를 유지하고, 새 경로에서 확인해야 할 조건을 따로 남길 수 있다. 제한 배포의 목적을 모든 사용자에 대한 일반적인 이용 보장으로 확대하지 않는 것이 핵심이다.
도입 판단표: 출력 예산을 어디에 연결할 것인가
계정에서 호출할 수 있는지 확인하기 전에는 출력 예산 확대를 도입 일정으로 바꾸지 않는다. 아래 표는 Google이 측정한 성능표가 아니라, 출력 한도와 배포 설명을 실제 업무 질문으로 바꾼 편집 도구다. 모든 항목을 한 번에 통과한 것으로 간주하지 말고, 아직 근거가 없는 칸은 미확인으로 남긴다.
| 판단할 상황 | 먼저 확인할 근거 | 그다음 행동 | 피해야 할 결론 |
|---|---|---|---|
| 사용하려는 계정에 Argon이 보이지 않음 | 실제 계정의 모델 목록과 이용 경로의 안내 | 기존 경로 유지, 접근 확인을 도입 전제 조건으로 기록 | Ultra 구독 또는 유료 API만으로 현재 권한 보장 |
| 긴 응답이 중간에 잘려 업무가 끝나지 않음 | 해당 경로의 출력 제한과 실제 종료 원인 | 이용 가능 시 작은 동일 업무로 산출물·종료 상태 비교 | 1M까지 늘리면 모든 실패 해결 |
| 입력 자료나 이전 작업 상태가 빠짐 | 입력 한도·자료 선택·상태 전달 방식 | 빠진 근거와 상태를 먼저 식별 | 출력 한도를 입력 컨텍스트 해결책으로 사용 |
| 긴 코드 수정 결과가 도착함 | 변경 파일·테스트 결과·검토할 차이 | 산출물을 업무의 완료 기준과 대조 | 응답이 길거나 끝났으니 수정도 성공 |
| 방어 목적의 제한 경로를 검토함 | 해당 프로그램의 사용자·행위·환경 조건 | 승인 범위와 외부 실행 권한을 분리해 기록 | 제한 사용자 설정을 일반 배포에도 적용 |
이 표의 장점은 “모델이 더 오래 생각할 수 있다”를 “우리 업무가 끝났다”로 건너뛰지 않는 데 있다. 출력 예산은 생성 과정의 여유이고, 완료 판정은 외부 결과의 확인이다. 테스트 통과, 변경 사항 검토, 필요한 문서 갱신처럼 업무에 맞는 기준을 먼저 선택해야 한다. 실제 호출이 가능해져도 그 기준 자체를 느슨하게 만들 이유는 없다.
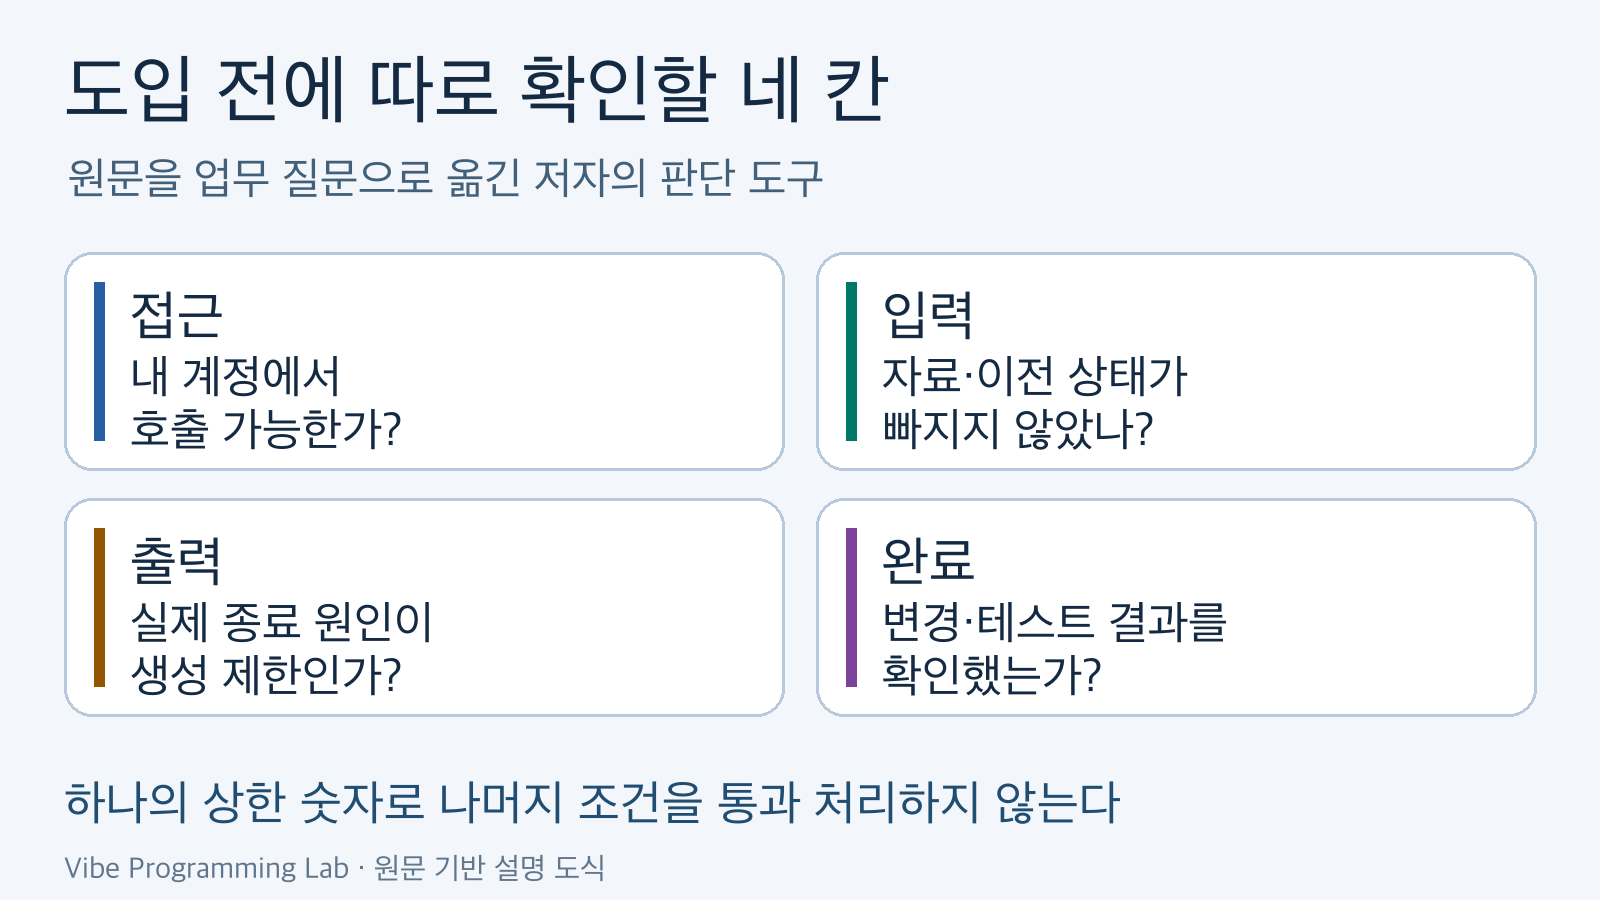
그림 3. 출력 상한을 도입 일정이나 완료 판정에 곧바로 연결하지 않는 저자의 판단 도구다. Google의 평가표나 실제 호출 결과가 아니다. 출처: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon.
코드 수정 업무로 보는 반례: 길어져도 해결되지 않는 실패
다음은 제품을 실행한 사례가 아니라 설명을 위한 가상 상황이다. 에이전트가 여러 파일을 바꾼 뒤 긴 설명을 반환했는데, 요청에 필요한 설정 파일이 빠져 있었다고 하자. 출력 상한을 높이더라도 빠진 입력이 자동으로 제공된다고 볼 수 없다. 또 수정 파일이 만들어졌지만 테스트를 돌리지 않았다면, 응답이 자연스럽게 끝났다는 이유만으로 수정 완료를 확인할 수 없다.
이때 팀이 남길 기록은 토큰 숫자 하나보다 구체적이어야 한다. 첫째, 요청에 넣은 자료와 빠진 자료를 구분한다. 둘째, 변경 파일과 설명을 구분한다. 셋째, 테스트를 실제로 실행했는지와 결과가 무엇인지 구분한다. 마지막으로 필요한 조건이 충족되지 않았으면 미완료로 남긴다. 출력이 더 길어졌을 때에도 이 구분이 유지되어야 한도 확대의 실제 가치를 평가할 수 있다.
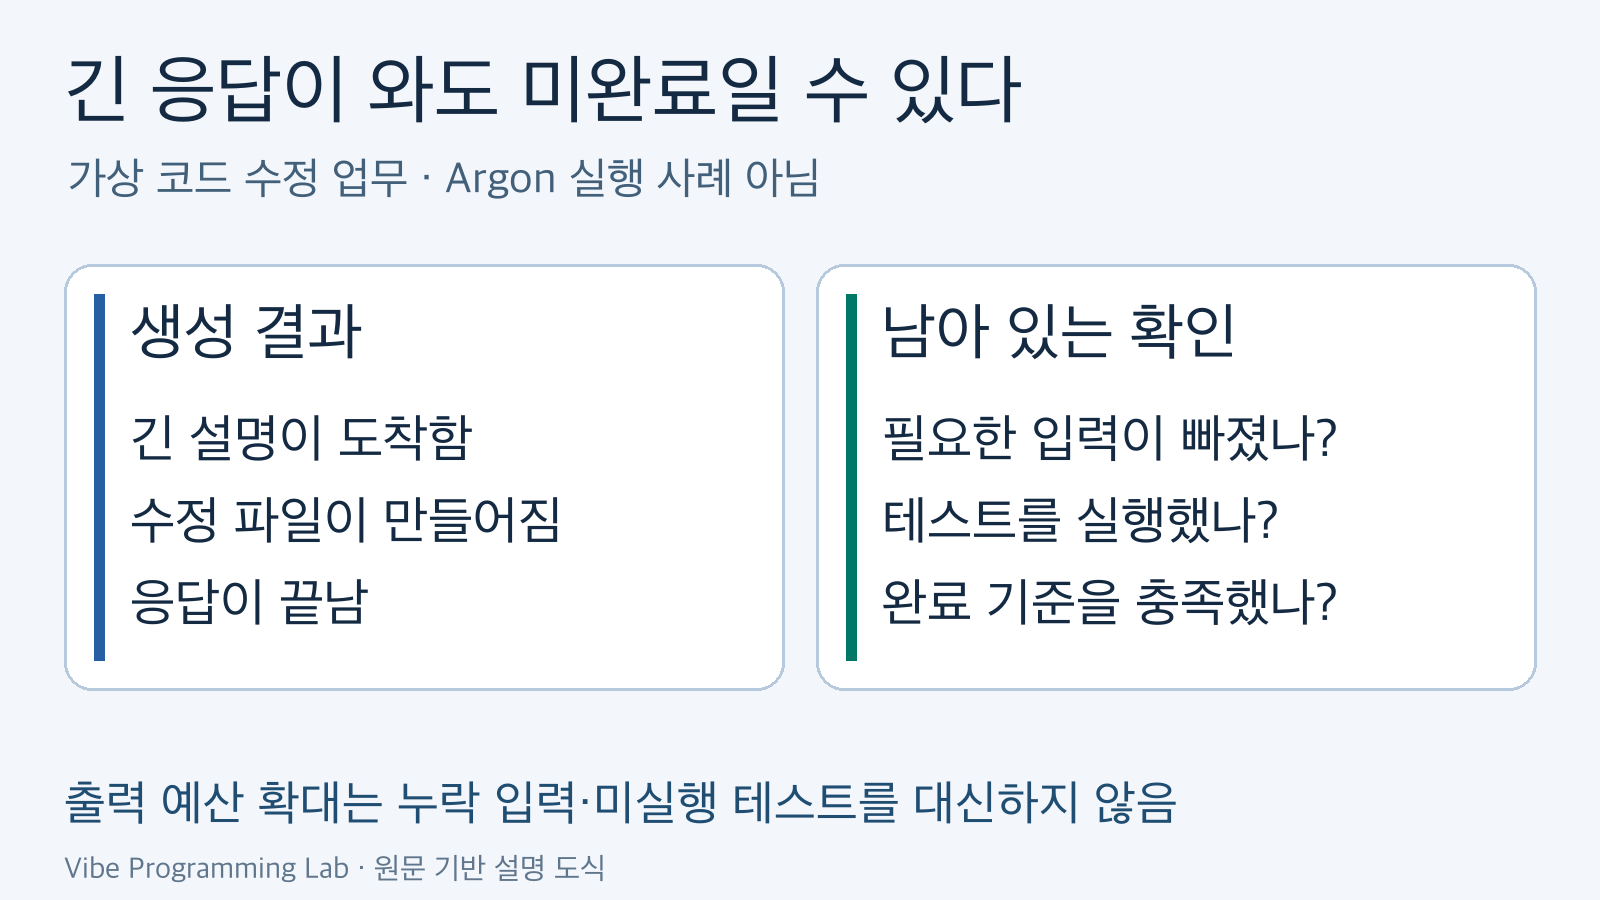
그림 4. 설명용 가상 상황으로 생성 종료와 업무 완료를 분리했다. 테스트 통과나 Argon 생산성 개선을 측정한 그림이 아니다. 출처: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon.
반대로 필요한 자료와 계정 권한이 준비되어 있고, 생성 한도 때문에 동일한 업무가 반복해서 끊긴다는 관찰이 있을 때는 출력 예산 확대를 비교 항목으로 삼을 수 있다. 다만 이것은 앞으로 수행할 평가의 조건을 정의한 것이다. 이번 글에서 Argon으로 그 비교를 실행하거나, 재시도 감소·완료 시간 단축을 측정한 것은 아니다. 출력 상한의 발표를 관찰된 생산성 효과와 혼동하지 않는다.
보호 조치의 설명도 배포 범위를 보존해야 한다
Google은 일반적인 확대 배포에 앞서 오용 방어, 간접 프롬프트 인젝션 방어, 의도 이탈 감시, 환경 강화라는 영역을 설명한다. 서로 다른 위험 경로에 대응하는 조치들이다. 외부 문서의 악성 지시로 작업이 바뀌는 문제와 사용자가 승인하지 않은 행동으로 목표를 달성하려는 문제는 같은 질문이 아니다. 원문은 감시와 필요 시 실행 중단, 격리된 환경의 강화 등을 서술하지만, 이를 모든 위험이 제거되었다는 독립적인 안전 인증으로 읽을 수는 없다.
특히 「Leading in defensive cybersecurity」에는 신뢰받는 방어자와 Google 내부 팀에 사이버 가드레일 없이 제공한다는 좁은 설명이 있다. 이 조건을 일반 소비자 배포에도 적용해 “Argon은 누구나 제한 없이 쓸 수 있다”고 쓰면 근거의 사용자 범위를 잃는다. 한편 다른 모델의 위험 등급이나 보호 조치 점수를 Argon의 평가처럼 가져와서도 안 된다. 이 글에서는 해당 프로그램의 실제 신청·승인 조건을 시험하지 않았으며, 일반 사용자에게 적용될 최종 설정도 단정하지 않는다.
결론: 큰 숫자보다 확인할 칸이 중요하다
이번 발표에서 확실히 나누어 읽을 것은 출력 상한의 확대, 현재 제한 배포, 향후 접근 확대 계획이다. 64K에서 1M으로 늘어난다는 공급자의 설명은 설계 후보를 넓히지만, 입력 상태 관리나 계정 권한 확인, 외부 완료 검증을 대신하지 않는다. 오늘 할 수 있는 일은 실제 이용 가능성을 확인할 질문과 동일 업무의 완료 기준을 준비하는 것이다. 확정되지 않은 일반 출시일이나 검증하지 않은 성능 개선을 일정과 예산의 전제로 넣지는 않는다.
이 글은 Google 발표 원문에 근거한 편집 분석이며, Argon 실행·계정 접근 시험·독립 성능 평가를 수행한 결과가 아니다. 원문에서 보고한 벤치마크 점수, 내부 생산성 사례, 가격 조건은 이 출력·접근 판단의 근거로 사용하지 않았다. 발표된 능력과 지금 확인한 이용 조건을 분리하는 것이 이번 소식을 실무적으로 읽는 출발점이다.
함께 읽을 글과 원문
입력 쪽의 문제와 비교하려면 100만 토큰 컨텍스트는 모델 스펙이 아니라 캐시 정책 문제다를 볼 수 있다. 그 글은 DeepSeek-V4의 입력 상태와 서빙 정책을 다룬다. 그 수치나 구조를 Argon의 출력 한도와 합쳐 쓰지 않는다. 배포 보호 조치라는 다른 층위를 보려면 GPT-6 Astra가 처음 넘은 Critical: 성능보다 어려운 출시 조건이 관련된다. 그 모델의 분류와 평가는 Argon의 사실이 아니다.
- Google, Gemini 4 Argon: our next era of frontier intelligence — 2026년 9월 30일 발표. 도입부, 「Working harder on your most complex problems」, 「Leading in defensive cybersecurity」, 「Strengthening frontier safeguards before broad availability」, 「Rolling out soon」을 근거로 사용했다. 이 글은 보존된 원문 스냅샷을 재사용했으며, 별도 실시간 모델·계정 검증으로 표현하지 않는다.


댓글
댓글 쓰기