100만 토큰 컨텍스트는 모델 스펙이 아니라 캐시 정책 문제다
1M 토큰 컨텍스트는 모델 카드에서 보면 멋진 상한처럼 보입니다. 하지만 실제 서비스에서 중요한 질문은 “이 요청을 넣을 수 있는가”가 아니라 “그 상태를 얼마나 오래 메모리에 보관하고, 다음 요청이 다시 쓸 때 어떤 비용을 낼 것인가”입니다. Together AI의 「Serving DeepSeek-V4: why million-token context is an inference systems problem」은 DeepSeek-V4를 바로 그런 서빙 시스템의 문제로 설명합니다.
이 글의 원문은 DeepSeek-V4의 1M 컨텍스트가 Compressed Sparse Attention(CSA), Heavily Compressed Attention(HCA), Sliding Window Attention(SWA)을 섞는 하이브리드 구조에서 나온다고 설명합니다. 따라서 V4의 장점은 “긴 입력을 받는다”에서 끝나지 않습니다. 추론 엔진이 서로 다른 KV 상태를 저장하고, 배치하고, 회수하고, prefix 재사용 때 복원하는 방법까지 맞아야 실현됩니다. 아래 내용은 Together의 NVIDIA HGX B200 초기 bring-up 설명을 기준으로 한 분석이며, 제가 V4를 독립 실행해 재현한 결과는 아닙니다.
1M 토큰보다 먼저 바뀐 것은 KV 캐시의 단위다
autoregressive 디코딩은 앞서 읽은 컨텍스트를 KV 캐시에 남겨 두고 새 토큰을 생성할 때 그 상태를 다시 읽습니다. 원문이 제시한 단순화된 관계는 KV cache ∝ layers × tokens × kv_heads × head_dim × bytes입니다. 긴 컨텍스트에서는 토큰 수가 늘어나는 것만 문제가 아닙니다. 각 요청이 더 많은 메모리를 점유해 동시성을 제한하고, 매 디코드 단계에서 읽어야 할 상태가 커져 메모리 대역폭과 처리량에도 부담을 줍니다.
이전 최적화가 줄인 항은 서로 달랐습니다. GQA는 KV head 수를, MLA는 head 차원의 표현을 줄이고, FP8·MXFP4·NVFP4는 원소당 바이트를 줄입니다. Together의 설명에서 DeepSeek-V3.2 sparse attention은 디코드 때 읽는 양을 줄였지만 전체 캐시를 상주시키는 경로였습니다. V4가 겨냥하는 축은 토큰 축입니다. 컨텍스트를 KV에 저장하기 전에 압축해 저장 엔트리 자체를 줄입니다.
다만 “토큰 축을 줄였으니 메모리도 자동으로 줄었다”고 읽으면 안 됩니다. Together가 공개한 초기 bring-up에서는 full-SWA 구현이 토큰당 약 3.8KB로, 그들의 V3 경로 약 3.4KB보다 오히려 컸습니다. 실질적인 변화는 캐시 정책에 있었습니다. SWA 상태 중 재사용 가능성이 높은 부분만 보관하는 정책으로, 단일 NVIDIA HGX B200 노드의 총 KV-cache capacity를 약 1.2M 토큰에서 3.7M 토큰으로 늘렸다고 보고합니다. 이 수치는 Together의 특정 초기 구현과 장비에 대한 보고이지, 독립 측정이나 모든 V4 배포의 보장이 아닙니다.
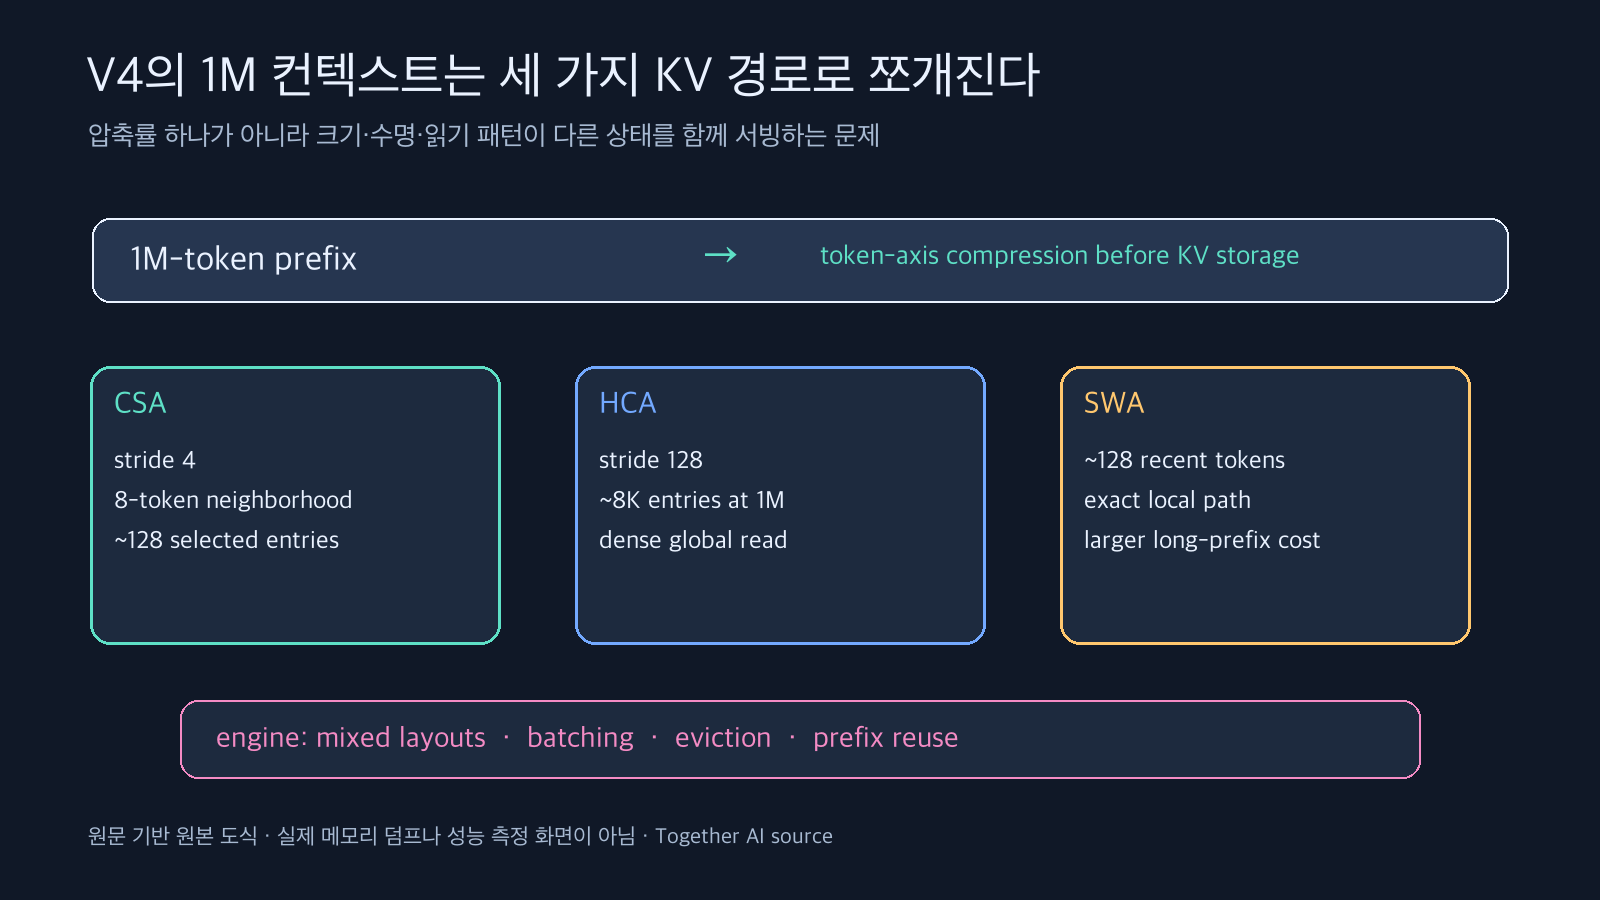
그림 1. V4의 1M 컨텍스트는 하나의 KV 버킷이 아니라 CSA·HCA·SWA와 엔진 관리 책임의 조합입니다. 실제 메모리 덤프나 성능 측정 화면이 아닙니다. 출처: www.together.ai/blog/serving-deepseek-v4-why-million-token-context-is-an-inference-systems-problem.
그림 1은 이 글에서 말하는 “압축”이 단일 압축 버킷이 아니라 여러 캐시 경로의 조합이라는 점을 보여 줍니다. 이 구분이 없으면 1M이라는 입력 길이와 실제로 GPU에 상주하는 상태의 크기를 같은 숫자로 오해하기 쉽습니다.
CSA·HCA·SWA는 같은 캐시가 아니다
V4의 서빙 난점은 기존 엔진이 기대하는 “레이어별·토큰별로 모양이 비슷한 하나의 KV 객체”에서 벗어난다는 데 있습니다. 원문에 따르면 CSA는 stride 4로 컨텍스트를 압축하고, 각 압축 엔트리는 8토큰 이웃을 요약해 경계에서 서로 겹칩니다. 질의가 약 128개의 압축 엔트리를 선택하므로, 1M 토큰 전체를 그대로 읽는 대신 필요한 지역을 더 세밀하게 찾아가는 sparse 경로가 됩니다.
HCA는 같은 아이디어를 stride 128로 적용합니다. 1M 토큰에서는 약 8K개의 압축 엔트리로 줄어들고, 이 정도면 top-k 일부만 고르는 대신 압축된 전역 상태를 조밀하게 읽을 수 있습니다. CSA가 선택된 지역으로 향하는 세밀한 읽기라면 HCA는 전체 문맥을 훑는 거친 전역 읽기입니다. SWA는 약 128토큰의 최근 문맥을 정확하게 유지하는 로컬 경로입니다.
엔진이 실제로 관리해야 하는 것은 세 이름만이 아닙니다. CSA·HCA 압축기가 아직 필요로 하는 짧은 비압축 tail 상태까지 포함해, 크기·수명·읽기 패턴이 다른 객체가 한 요청 안에 공존합니다. 그래서 새 커널을 추가하는 것만으로 끝나지 않고, 각 객체의 페이지를 어떻게 배치하고, 어떤 순서로 evict하고, 배치된 요청이 서로의 캐시를 어떻게 방해하지 않게 할지 정해야 합니다.
특히 캐시 용량을 말할 때는 “모델이 지원하는 최대 입력 길이”, “한 요청이 실제로 점유하는 캐시”, “동시에 수용 가능한 요청 수”를 분리해야 합니다. Together의 3.7M 토큰 보고도 이 세 숫자를 모두 뜻하는 것이 아니라, 특정 HGX B200 bring-up에서의 총 KV-cache capacity 보고입니다.
Prefix caching은 저장 대 재계산 정책이 된다
prefix caching은 보통 “공유 prefix면 공유 KV”로 시작합니다. 하지만 V4에서는 “어떤 KV를 공유할 것인가”가 먼저입니다. CSA와 HCA는 비교적 작아서 저장하기 쉽지만, SWA는 긴 prefix에서도 정확한 로컬 상태라 저장 비용이 큽니다. 같은 repository나 장시간 agent의 scaffold가 반복될수록 이 차이가 곧 메모리 계층과 지연의 선택이 됩니다.
Together의 글은 SWA에 대해 세 가지 정책을 설명합니다.
- Full store: SWA 전체를 저장합니다. cache hit 때 복원이 단순하지만 저장 공간과 쓰기 대역폭이 빠르게 늘어납니다.
- 주기적 checkpoint: K 토큰마다 SWA 상태를 저장하고, hit 때 checkpoint 사이의 간격을 재계산합니다. 저장량과 hit 지연 사이에 조절 손잡이가 생깁니다.
- Hit 때 재계산: CSA/HCA는 저장하고 SWA는 다시 만듭니다. 원문은 128토큰 window와 61개 layer를 예로 들어 약 8K 토큰 규모의 재계산으로 설명합니다.
현재 Together의 V4 bring-up은 첫 번째 full-store를 사용한다고 적혀 있습니다. 이는 나쁜 정책이라는 뜻이 아니라, 나머지 서빙 경로가 성숙하는 동안 prefix 복잡도를 낮추는 선택입니다. 반대로 1M prefix를 자주 재사용하고 GPU 밖의 캐시 계층까지 쓰는 서비스라면 full-store의 메모리·쓰기 비용이 병목이 될 수 있습니다. “재계산이 8K이니 무조건 이득”이라는 결론도 금물입니다. 실제 답은 prefix 길이, hit 빈도, cache-tier 지연, 재계산 커널 비용으로 측정해야 합니다.
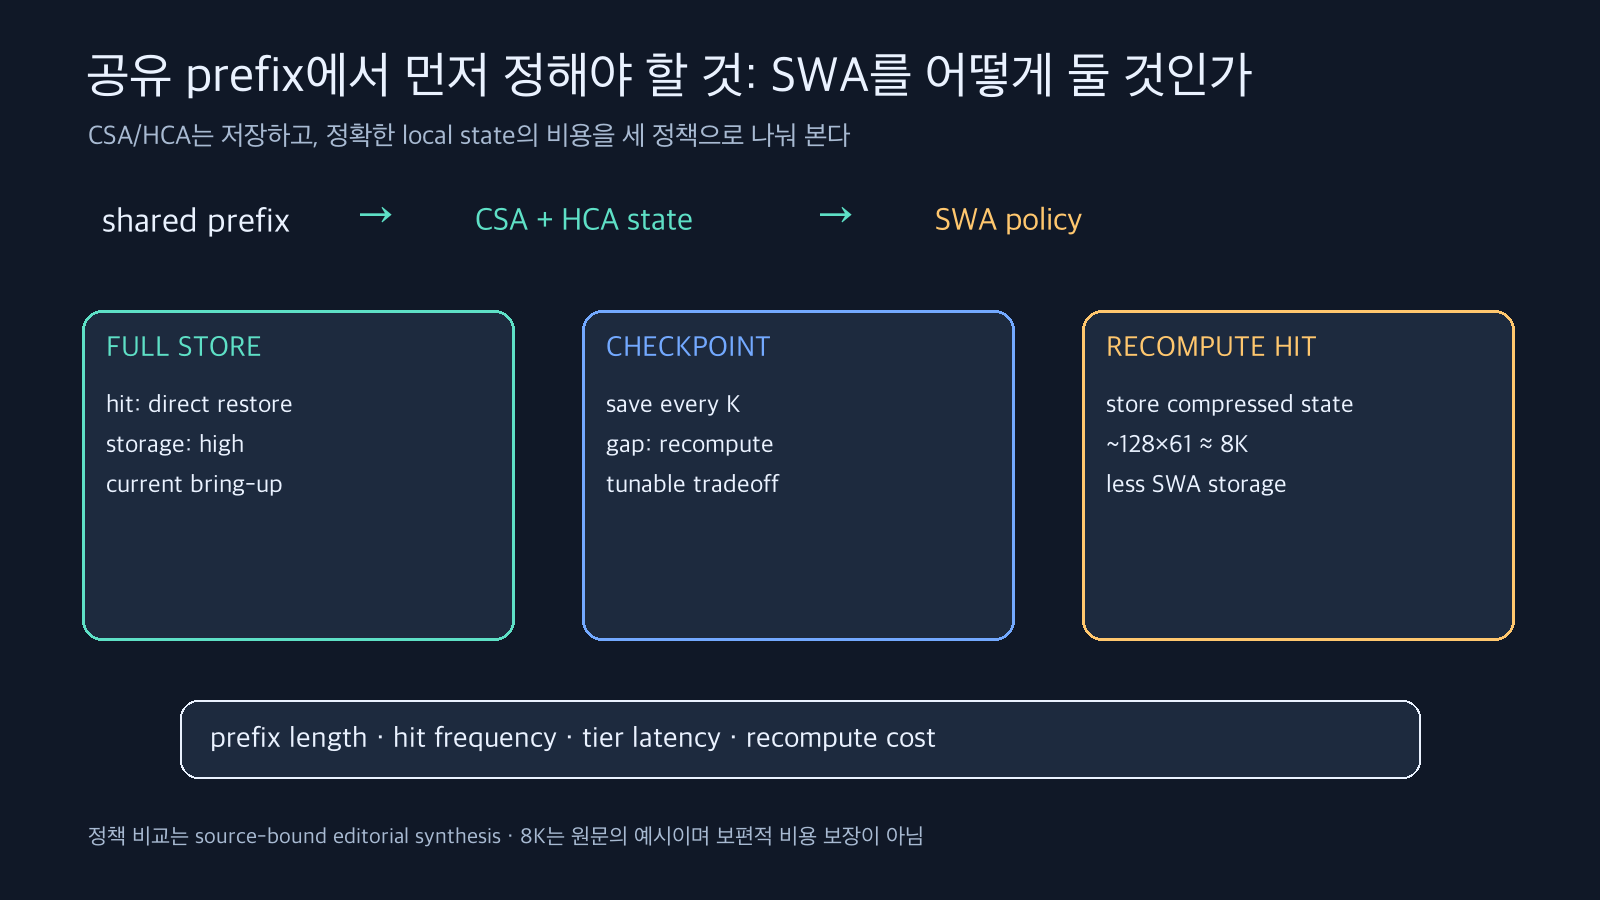
그림 2. SWA prefix 상태의 full store·checkpoint·recompute-on-hit 선택을 저장량과 hit 계산의 교환관계로 비교합니다. 8K는 원문의 예시이며 보편적 비용 보장이 아닙니다. 출처: www.together.ai/blog/serving-deepseek-v4-why-million-token-context-is-an-inference-systems-problem.
그림 2는 세 정책을 성능 순위가 아니라 비용을 나누는 방식으로 비교합니다. 저장량을 줄이면 hit 시 계산이 늘고, 복원을 단순하게 하면 메모리와 쓰기 비용이 커집니다. 이 교환관계를 endpoint별로 기록해야 합니다.
워크로드에 따라 V4의 이득 구간이 갈린다
V4의 캐시 압축이 가장 직접적으로 드러나는 곳은 긴 컨텍스트를 읽으며 디코드하는 workload입니다. 코딩 agent나 research agent는 큰 상태를 계속 읽고, 같은 repository·작업 scaffold를 여러 요청이 공유할 수 있습니다. 이 경우 cache hit rate, decode throughput, 완료된 작업 하나의 비용을 봐야 하며, time-to-first-token 하나로 성공 여부를 판정하면 안 됩니다.
짧은 chat은 반대쪽에 있습니다. 1M KV를 거의 만들지 않는 요청에서는 압축의 이득보다 prefill 지연, 작은 batch의 고정비, 새로운 커널의 성숙도가 먼저 보일 수 있습니다. 원문은 CSA top-k 선택, HCA 압축 읽기, SWA 경로와 MXFP4 MoE 가중치의 성능 특성이 이 구간의 변수라고 설명합니다. 같은 가중치를 써도 짧은 chat에는 작은 tensor-parallel group과 짧은 batching delay가 더 적합할 수 있습니다.
RL rollout은 또 다른 단위를 가집니다. 한 응답의 지연보다 긴 trajectory를 실험 예산 안에서 몇 개 생산하는지가 중요합니다. 그러므로 token price가 아니라 rollout 길이와 실험당 rollout 수를 포함한 cost per trajectory로 계산해야 합니다. 혼합 트래픽은 하나의 endpoint로 처리할 수 있지만, traffic shape가 확인되면 profile-specific endpoint가 더 나은 경우가 많습니다.
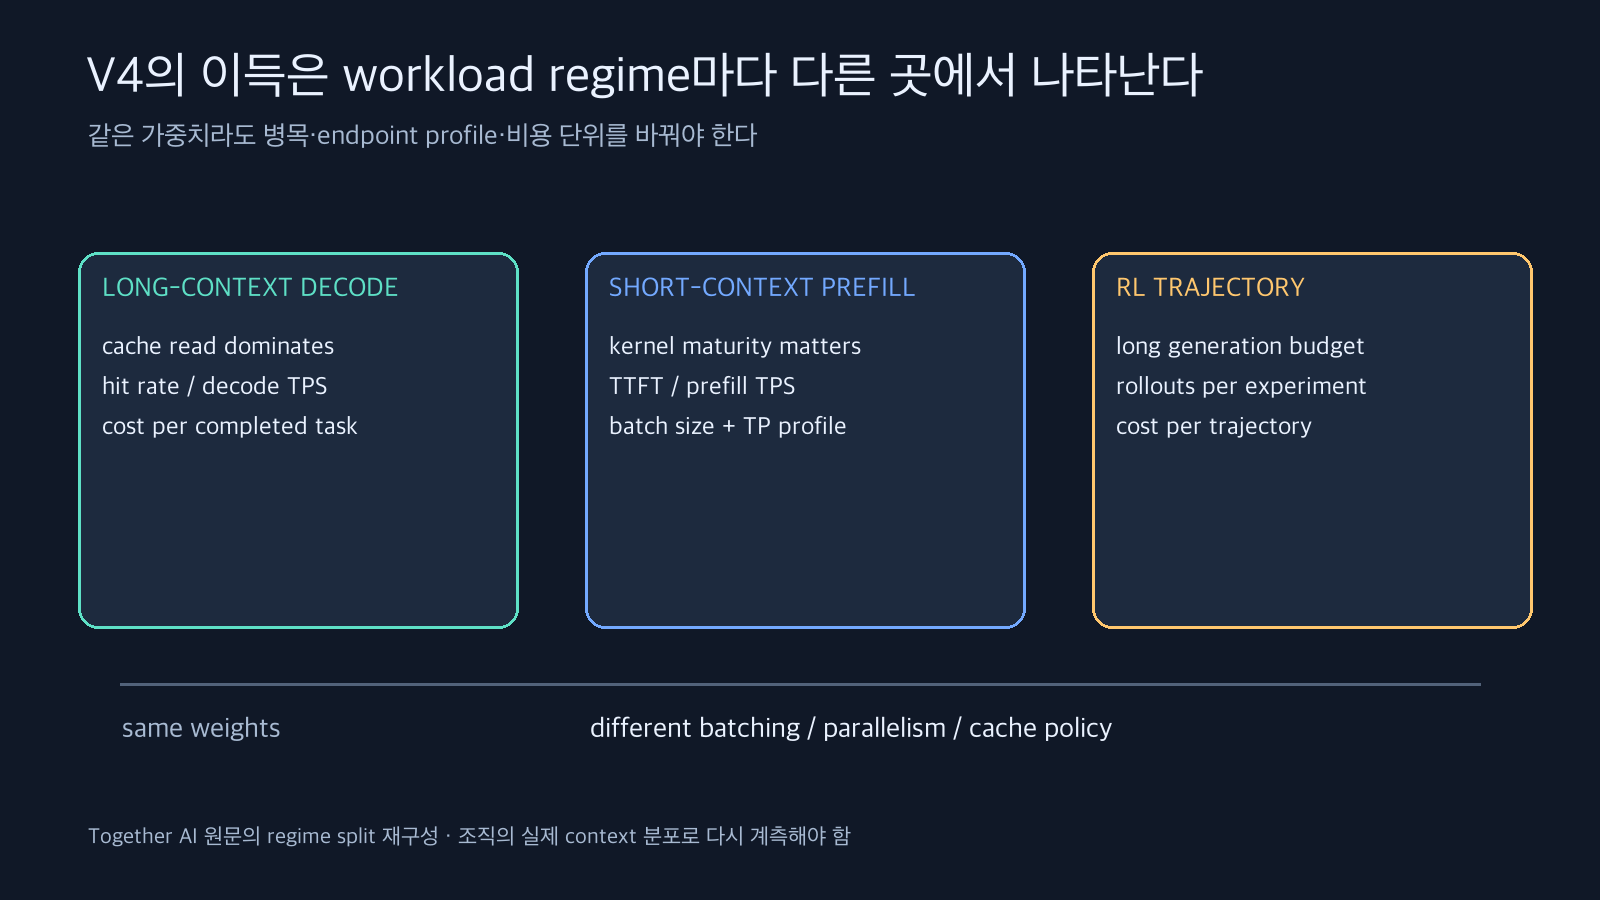
그림 3. V4의 이득은 long-context decode·short-context prefill·RL trajectory에서 서로 다른 지표로 나타납니다. 실제 workload 성능 결과가 아닙니다. 출처: www.together.ai/blog/serving-deepseek-v4-why-million-token-context-is-an-inference-systems-problem.
그림 3의 세 칸은 “V4가 빠르다”는 단일 평균을 제시하지 않습니다. 긴 디코드, 짧은 prefill, 긴 rollout이 각각 다른 병목과 측정 단위를 가진다는 source-bound 해석입니다. 실제 수치는 조직의 context 분포와 batch 크기로 다시 측정해야 합니다.
도입 전 판단표: 무엇을 측정할 것인가
판단표의 핵심은 모델을 바로 교체하는 것이 아니라, 트래픽을 네 가지 질문으로 분해해 측정하는 것입니다.
| 관측할 상황 | 먼저 기록할 지표 | 다음 판단 |
|---|---|---|
| 200K–1M에 가까운 긴 context와 반복 prefix | 실제 context 길이별 cache hit rate, decode throughput, 동시 요청 수 | full-store와 SWA checkpoint/recompute를 같은 prefix trace로 비교 |
| 4K–32K 중심의 짧은 chat | TTFT와 end-to-end latency, prefill throughput, batch 크기 | 1M 지원 여부보다 커널 성숙도와 endpoint profile을 우선 비교 |
| 같은 repository를 공유하는 coding agent | prefix 길이·재사용 빈도·cache-tier 지연·완료 비용 | 압축 캐시는 저장하고 SWA만 재계산하는 정책을 baseline과 대조 |
| 긴 RL trajectory 생성 | trajectory당 비용, 실험당 rollout 수, 총 처리 시간 | 토큰 단가가 아니라 예산당 유효 rollout 수로 선택 |
| 위 workload가 한 endpoint에 섞임 | traffic 비율, queueing, 실패·재시도, 품질 지표 | profile별 endpoint와 혼합 endpoint의 운영 복잡도까지 비교 |
표의 항목은 Together가 공개한 초기 결과의 숫자를 조직에 복사하는 표가 아닙니다. 원문이 말한 “context-length regime, prefix reuse, cache policy, endpoint profile”을 실제 도입 질문으로 번역한 편집 도구입니다. 품질도 함께 남겨야 합니다. 긴 컨텍스트는 유용한 상태를 더 담을 수 있지만 retrieval noise, 압축 손상, compaction 시점도 함께 키울 수 있기 때문입니다.
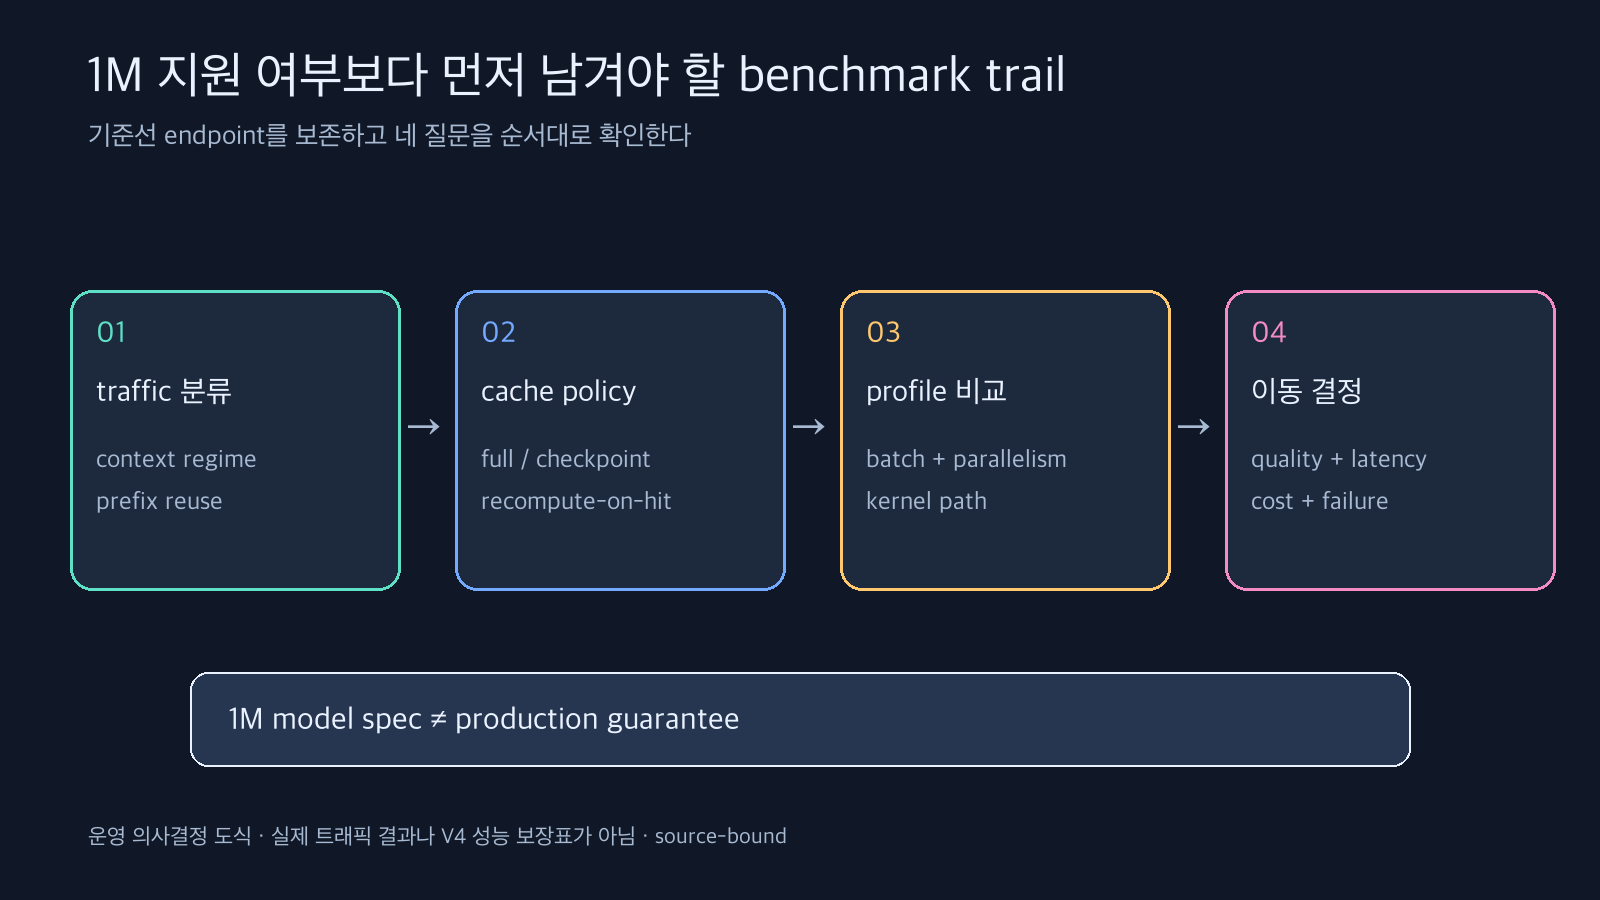
그림 4. 기준선 endpoint를 보존하고 트래픽·캐시 정책·프로파일을 순서대로 비교하는 편집상 benchmark 흐름입니다. V4 성능 보장표가 아닙니다. 출처: www.together.ai/blog/serving-deepseek-v4-why-million-token-context-is-an-inference-systems-problem.
그림 4는 이 판단표를 운영 순서로 다시 그린 것입니다. 기준선 endpoint를 남겨 두고 workload를 분리한 뒤, cache policy와 profile을 바꾼 결과를 품질·지연·비용으로 동시에 비교해야 “1M을 지원한다”에서 “우리 업무가 좋아졌다”로 넘어갈 수 있습니다.
결론: 모델 교체가 아니라 서빙 정책 교체다
DeepSeek-V4의 핵심 변화는 컨텍스트를 토큰 축에서 압축해 KV pressure를 낮추는 구조입니다. 그러나 실현된 이득은 CSA·HCA·SWA를 별도 객체로 다루는 메모리 관리자, prefix hit 때 SWA를 저장할지 재계산할지 정하는 정책, 새 attention·precision 경로의 커널, workload별 batching·parallelism에 함께 달려 있습니다.
따라서 도입 순서는 “1M 모델로 전체 트래픽 전환”이 아니라, 실제 trace를 네 regime으로 나누고 baseline과 함께 측정하는 쪽이어야 합니다. Together의 1.2M→3.7M 보고는 cache policy가 아키텍처만큼 중요하다는 좋은 사례지만, 그것만으로 우리 서비스의 비용·지연·품질을 예측할 수는 없습니다. 이 글은 Together AI의 공개 페이지를 바탕으로 한 원문-bound 편집 분석이며, 독립적인 V4 실행이나 상용 serving 성능 재현이 아닙니다.
참고로 9월 23일의 vToken 블록 회수 글은 별도의 arXiv 논문과 별도의 게시물입니다. 그 글의 vToken eviction/reclamation 결과를 DeepSeek-V4의 CSA/HCA/SWA 사실로 재사용하지 않았습니다. 라우팅과 KV cache 비용의 관계를 다룬 이전 KV 라우팅 글도 문제의 다른 층위에 있으므로, 여기의 V4 수치와 합쳐 읽지 않는 것이 안전합니다.
원문
- Together AI — Serving DeepSeek-V4: why million-token context is an inference systems problem — CSA/HCA/SWA, prefix caching, HGX B200 초기 bring-up, workload별 benchmark 질문.


댓글
댓글 쓰기