수리 기록을 찾았다고 바로 실행해도 될까: OntoAct의 조건부 지식과 고장 가설 갱신
“이전에 이 부품을 바꿨더니 고쳐졌다”는 기록을 찾았다. 지금도 같은 부품부터 바꾸면 될까? 먼저 나눌 것은 세 가지다. 과거에 효과가 있었던 수리, 그 수리가 지금도 맞다는 관측, 실제로 고장이 해결됐다는 결과다. 기록 검색만 성공하고 이 셋을 섞으면, 틀린 가설에 맞춰 같은 수리를 반복할 수 있다.
OntoAct 논문은 과거 기록을 조건이 붙은 지식으로 바꾸고, 현재 관측과 수리 결과에 따라 고장 가설을 갱신하는 구조를 제안한다. 저자 보고에서 중간 규모 Tacit-FLE의 수리 성공률은 OntoAct 83.3%, 자연어 규칙을 쓰는 IfR 66.7%다. 성공하지 못한 실제 교체·보충 시도는 에피소드당 평균 2.4회와 11.9회였다. 중요한 것은 이 숫자를 외우는 일이 아니라, “왜 이 수리를 선택했으며 실패 뒤 무엇을 바꿨는가”를 확인할 수 있는 평가를 만드는 일이다. [근거: §3, Table 1, Appendix A.4.1]
1. 사건을 외우는 대신, 어떤 관계와 조건이 같아야 하는지 남긴다
설명용 가상 사례를 보자. 과거 기록에는 “기계 A의 설정이 생산 계획과 달랐고, 교체 뒤 문제가 해결됐다”는 내용이 있다. 현재 멈춘 기계 B에도 그대로 A의 수리를 복사하는 대신, B의 계획된 생산물과 실제 설정을 비교할 수 있다. 둘이 다른지 확인해야 과거 사례의 조건을 현재 대상에 연결할 수 있기 때문이다. 이는 논문 §2.2의 conjunction 유형을 풀어 쓴 예시이며, 이 글에서 실행한 설비 실험이나 제품 화면은 아니다.
OntoAct는 기록의 특정 개체와 연결 관계를 보존하면서, 개체 유형·관계상의 역할·관측 조건을 이용하는 재사용 규칙을 만든다. 예를 들어 특정 기계 이름만 저장하는 것과, 공급자와 수신자의 관계 및 작동 조건을 표현하는 것은 다르다. LLM은 이런 지식으로 가설과 행동을 제안하고, 기호 검증기는 현재 근거에 비추어 조건을 확인한다. [근거: §§3.1–3.3, Figures 1–2]
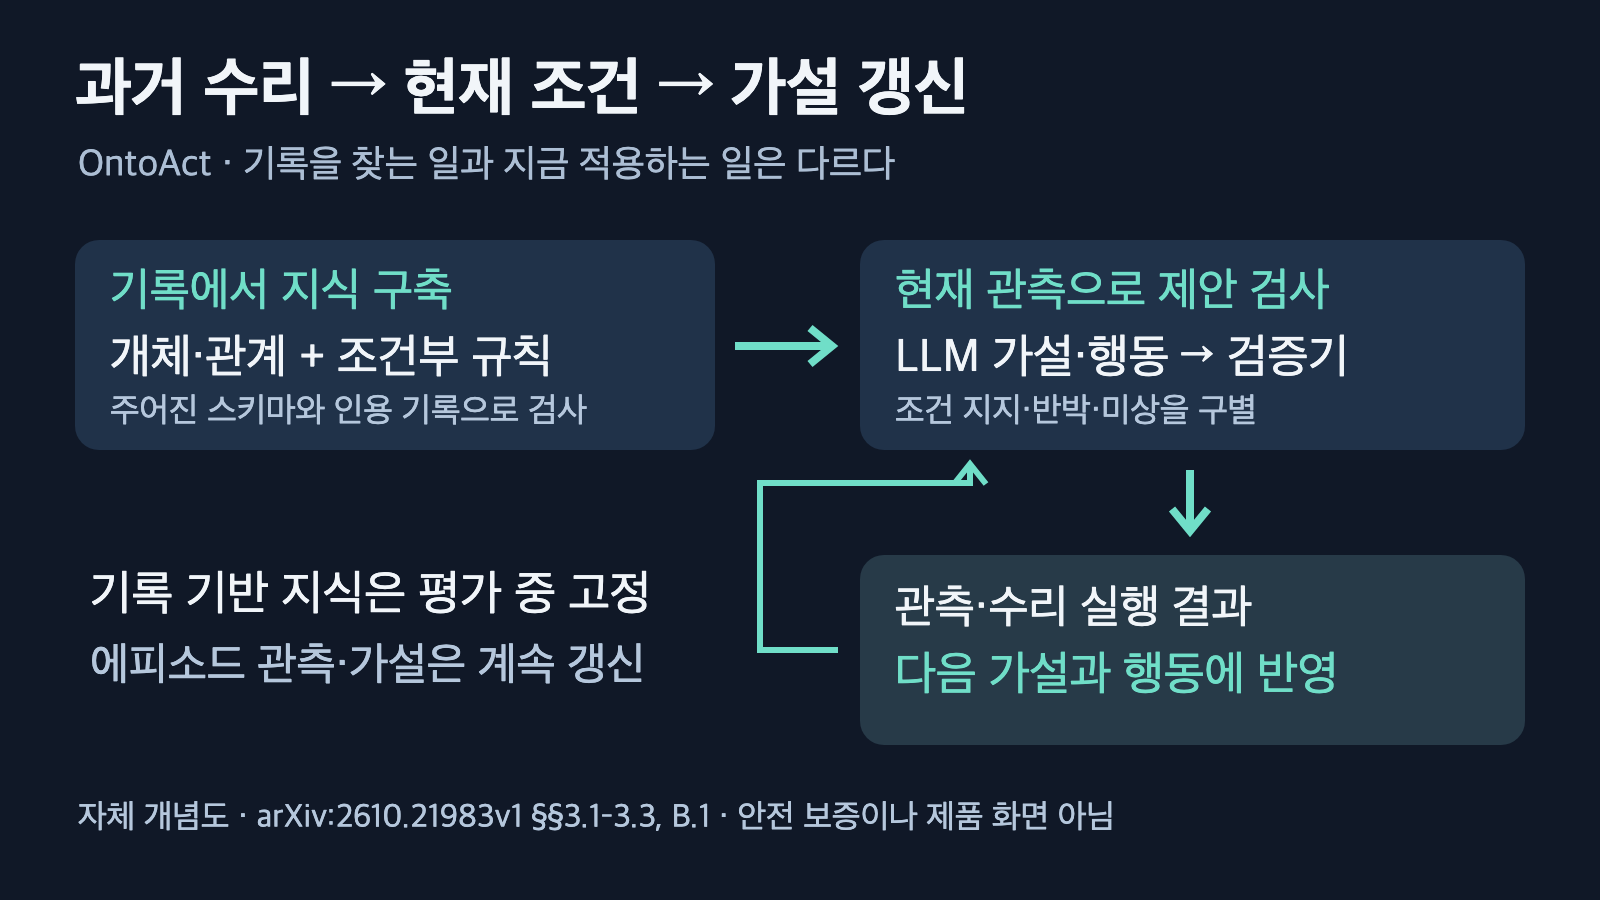
기록 기반 지식은 평가 중 고정되고 에피소드의 관측과 가설은 갱신된다. 논문 구조를 새로 그린 개념도이며 제품 화면이나 안전성 보증이 아니다. 출처: arxiv.org/html/2610.21983v1.
여기에는 서로 다른 두 검사가 있다. 지식 구축 단계에서는 주어진 스키마, 인용 기록, 해당 지식 유형에 적용되는 근거·정합성 조건을 확인한다. 상호작용 단계에서는 현재 관측을 새로 반영해 가설과 행동을 검사한다. 스키마에 맞게 저장됐다고 모든 규칙이 참이 되거나, 과거의 작동 상태가 현재 상태로 복사되는 것은 아니다. 논문 부록 B.1은 기록에서 얻은 세계 지식과 에피소드별 관측의 수명을 구분한다. 평가 중에는 기록 기반 지식이 고정되고 관측·가설·결과는 에피소드마다 초기화된다.
2. 모르는 값은 거짓도 아니고, 모든 행동의 자동 중단도 아니다
가장 오해하기 쉬운 부분은 unknown이다. 논문 식 7에서 필요한 관측이 없으면 조건은 미상으로 남는다. 식 8에서는 가설의 조건이 모두 관측으로 지지되면 confirmed, 하나라도 반박되면 refuted, 그 외에는 open으로 평가한다. 여기서 confirmed는 현재 관측의 지지를 기록한 상태다. 고장의 인과관계를 영원히 증명했다는 뜻이 아니며, 뒤의 관측이나 수리 결과로 바뀔 수 있다. [근거: §3.3, Eqs. 7–8]
행동 판정은 별도로 읽어야 한다. 조건 위반이나 금지 사항은 행동을 막지만, 관측이 빠졌다는 사실만으로 모든 행동을 막지는 않는다. 설명적 지지가 필요한 행동은 조건이 여전히 성립하는 confirmed 가설이 필요하다. 관측 행동에는 confirmed 가설이 필요하지 않다. 따라서 “확신이 없으면 아무것도 못 한다”나 “가설이 confirmed면 무조건 실행한다”는 설명은 둘 다 부정확하다. [근거: §3.3, Eq. 9]
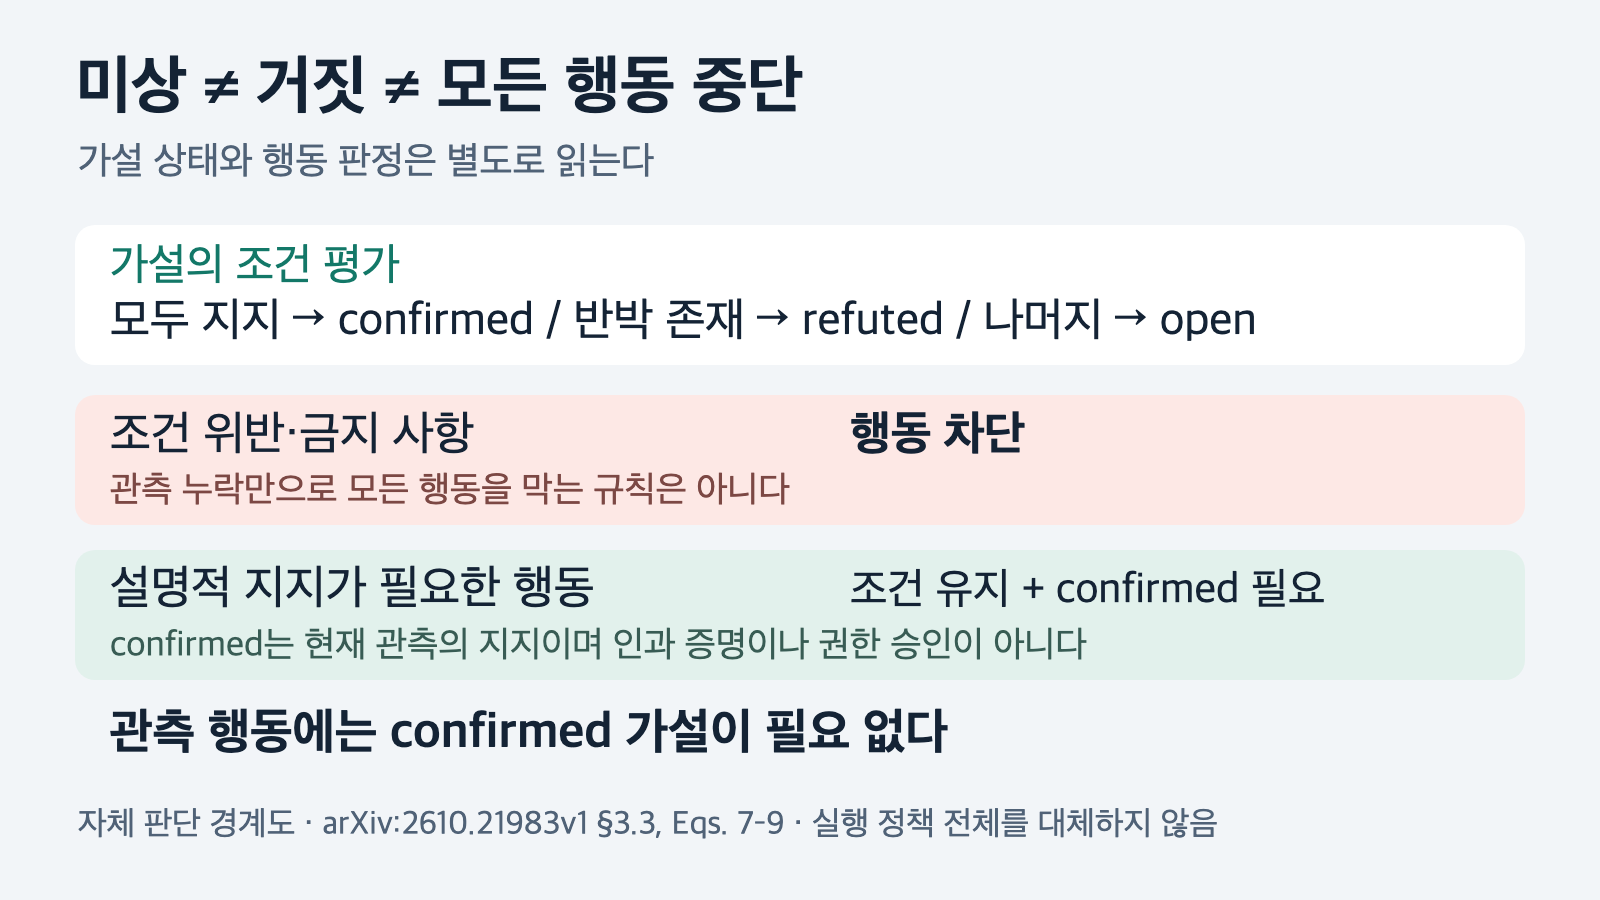
조건 위반과 금지는 행동을 막지만 관측 누락만으로 모든 행동을 막지 않는다. 설명적 지지가 필요한 행동에는 조건이 유지되는 confirmed 가설이 필요하고 관측에는 필요 없다. confirmed는 인과 증명이나 권한 승인이 아니다. 출처: arxiv.org/html/2610.21983v1.
이를 내 에이전트 평가에 옮기면 다음과 같은 진단표를 만들 수 있다. 행동 정책을 복제한 의사코드가 아니라, 로그에서 확인할 질문을 정리한 편집상 도구다.
| 로그에 나타난 상황 | 다음 평가에서 확인할 것 | 피해야 할 판정 |
|---|---|---|
| 과거 수리 기록만 찾음 | 현재 대상의 관계·설정·관측이 그 사례 조건과 맞는가 | 검색 적중을 현재 수리의 정답으로 취급 |
| 필요한 관측값이 없음 | unknown을 보존했는가, 추가 관측 후보가 있는가 | 빈 값을 정상 또는 고장으로 임의 채움 |
| 가설이 confirmed | 지지 조건이 지금도 성립하고 행동별 제약도 통과하는가 | 원인이 확정됐거나 실행 권한이 생겼다고 해석 |
| 교체·보충을 실행했지만 수리 미승인 | 실패 결과가 기존 설명을 어떻게 바꿨는가 | 같은 가설과 수리를 근거 없이 반복 |
| 새로운 관측이 가설과 모순됨 | 반박 상태와 다음 관측·행동 선택을 함께 기록했는가 | 최종 성공만 남기고 가설 변경을 삭제 |
같은 수리를 반복하기 전에, 직전 가설을 지지하던 현재 관측과 실제 수리 결과가 여전히 일치하는지 확인한다. 이 판단표는 논문에 근거한 편집상 평가 설계이며, 실제 설비에서 검증한 절차나 실행 권한 승인이 아니다. 물리적 개입이나 운영 시스템 변경 권한은 연구의 가설 상태와 별도로 정해야 한다.
3. 성공률의 분모와 실패한 수리 횟수를 함께 읽는다
Tacit-FLE는 Factorio 기반 시뮬레이션의 기존 공장에 숨은 고장 하나를 넣고, 합성 정비 기록과 현재 관측으로 진단·수리하게 한다. 평가에는 45개의 세계–유형 코퍼스와 104개 고장 위치 에피소드가 있다. 작은 규모 28개, 중간 36개, 큰 규모 40개다. 같은 세계와 기록에서 고장 위치를 바꾼 에피소드가 있으므로, 독립된 실제 공장 104곳을 시험한 결과가 아니다. [근거: §2.1, Appendix A.4/Table A6]
성공은 평가기가 허용한 대상의 교체, 또는 조건에 맞는 유효한 보충이 승인된 경우다. 장기간 생산이 정상 유지됐다는 실증과는 다르다. 실패한 시도도 턴을 쓰며, 실패 에피소드는 평균 턴 계산에 해당 규모의 전체 한도로 들어간다. 다음 중간 규모 비교는 성공한 사례만 추린 것이 아니라 예정된 36개 전체 에피소드에 대한 저자 보고다. 공유 턴 한도는 60이다. [근거: Appendix A.4.1]
| 중간 규모, 전체 36개 에피소드 | OntoAct | IfR |
|---|---|---|
| 수리 성공률 | 83.3% | 66.7% |
| 수리 기준을 충족하지 못한 실행 시도, 평균/에피소드 | 2.4 | 11.9 |
| 상호작용 턴, 평균/에피소드 | 19.4 | 31.7 |
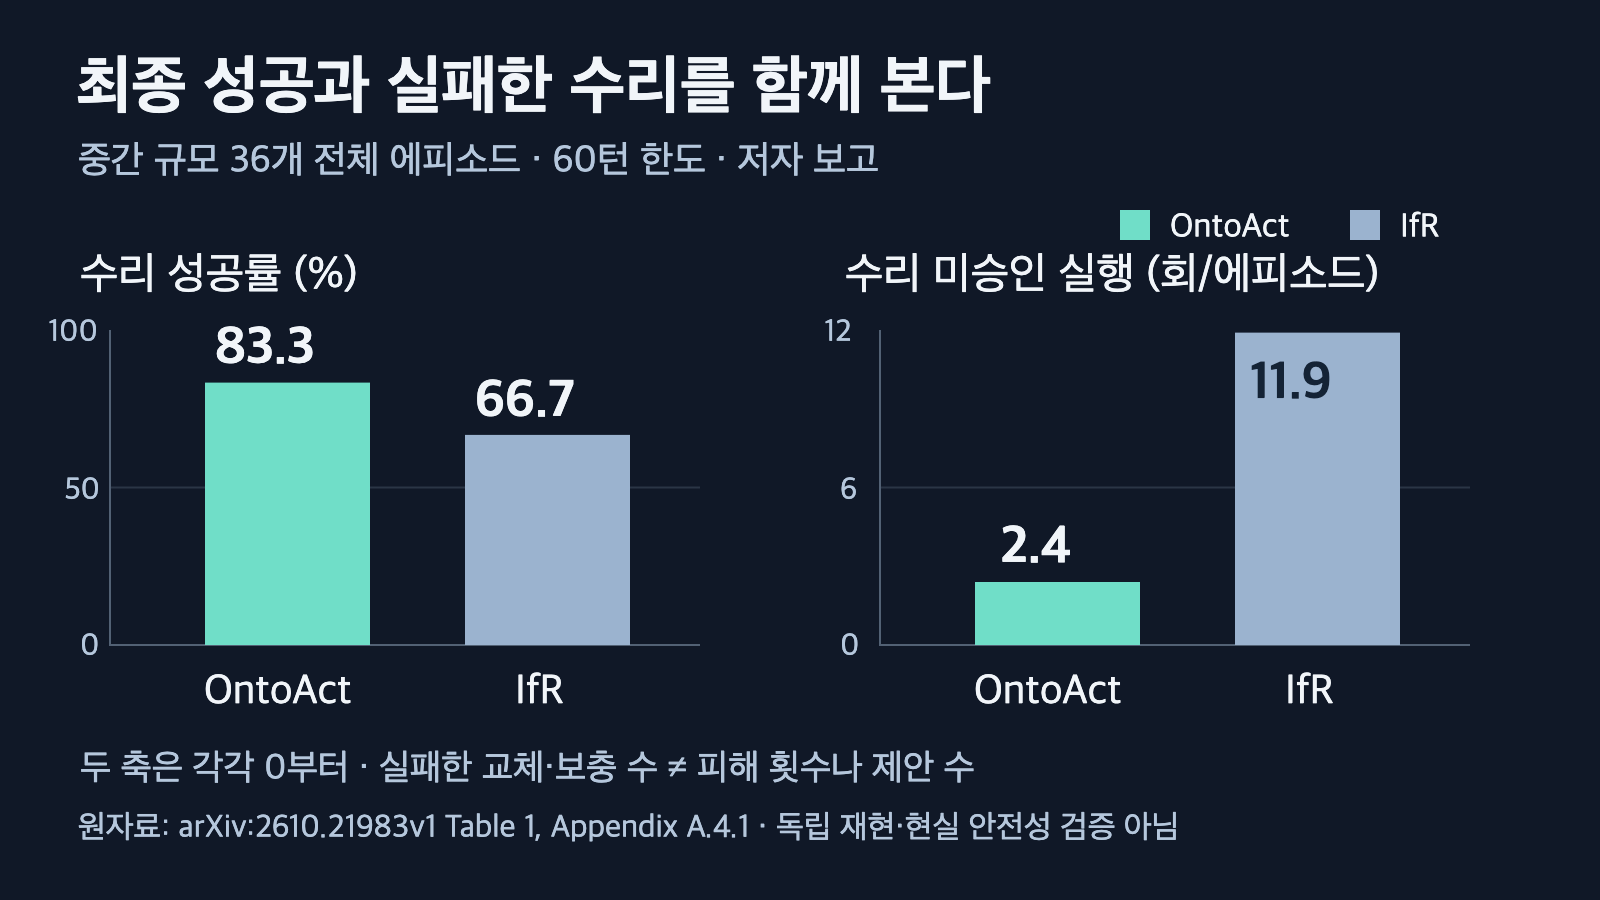
Table 1의 저자 보고다. 왼쪽은 수리 성공률 %, 오른쪽은 에피소드당 수리 기준 미충족 교체·보충 실행 수이며 각각 0부터 표시한다. 36개 전체 에피소드·60턴 한도이며 피해 횟수나 제안 횟수, 독립 재현 결과가 아니다. 출처: arxiv.org/html/2610.21983v1.
두 방법은 지정된 모델 설정과 과제·턴 한도를 공유한다. 여기서 모델은 논문에 기재된 gpt-5.6-luna, reasoning effort none이다. 다만 같은 턴 한도가 같은 실제 호출 수나 토큰 비용을 뜻하지는 않는다. IfR도 단순 검색 기준선이 아니라, 기록에서 자연어 규칙·스킬을 만들고 계획·설명·재계획을 수행하도록 공통 인터페이스에 이식한 방법이다. 여러 구성 요소와 프롬프트가 다르므로 결과 차이를 기호 검증기 하나의 인과 효과로 분리할 수 없다. [근거: §4.1, Appendix C.2/E.2]
또 하나의 숫자는 진단 후보의 순서다. Table 2에서 실제 고장 대상이 처음 세 후보 안에 든 과제는 OntoAct 25/36, IfR 4/36이다. 이 후보 집합에는 실행하지 않은 제안도 포함된다. “세 번 수리 안에 성공한 비율”이나 행동 정확도로 바꾸어 말하면 안 된다. 가설이 실제 원인 쪽으로 좁혀지는지와 수리가 승인됐는지는 서로 다른 평가다.
큰 규모 전체 성공률은 OntoAct 90.0%, IfR 65.0%지만, 모든 유형에서 이기는 것도 아니다. 큰 규모 elimination의 12개 에피소드에서는 각각 91.7%, 100.0%였다. 규모가 바뀌면 기록량·생산물·과제 구성·턴 예산도 달라진다. 큰 규모의 수치가 더 높다는 사실만으로 순수한 확장성 이득이나 통계적 유의성을 주장하지 않는다. [근거: Table 1, Table A6]
4. 평가 토큰이 줄어도 호출과 준비 비용은 따로다
조건부 지식을 먼저 만드는 데도 추론이 필요하다. 부록 Table A22의 중간 규모에서는 OntoAct의 구축 토큰이 공장당 58.7k, IfR은 17.1k다. 구축의 분모는 해당 규모의 공장 15개다. 반면 평가 토큰의 분모는 중간 규모 에피소드 36개이며, 에피소드당 265.5k와 422.0k다. k는 입력과 출력 토큰을 합친 천 단위다. 공장당 구축량과 에피소드당 평가량을 같은 분모인 것처럼 더하거나 비교하지 않는다.
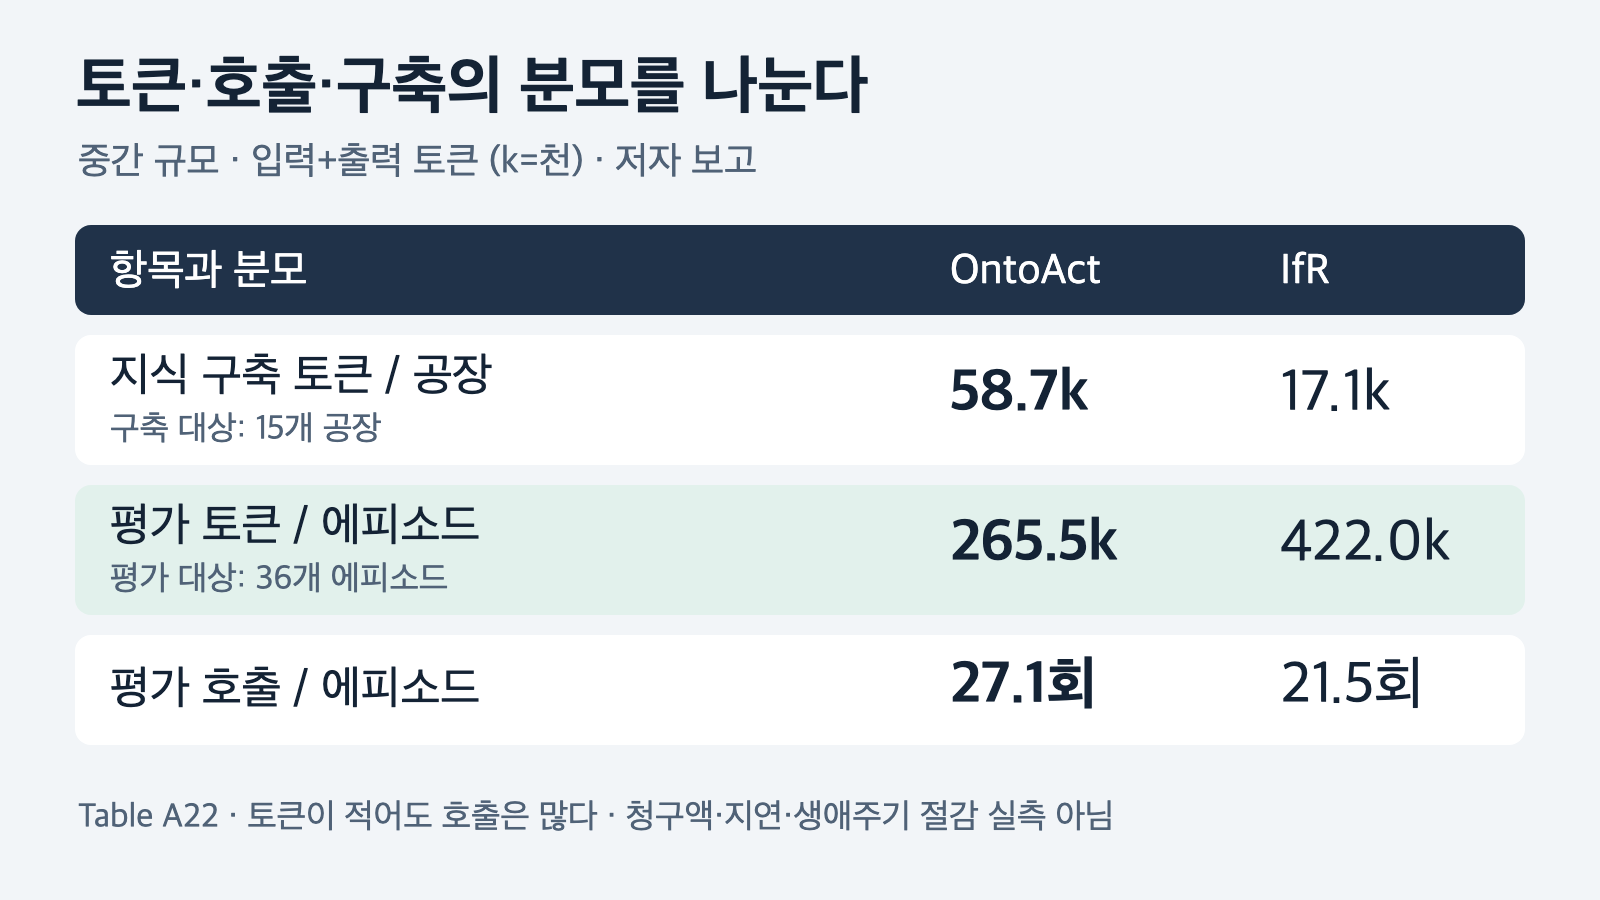
Table A22의 중간 규모 사용량이다. 구축은 15개 공장의 공장당 값, 평가는 36개 에피소드의 에피소드당 값이며 k는 입력+출력 천 토큰이다. 평가 토큰이 적어도 호출은 많다. 실제 청구액·지연·생애주기 절감의 측정치가 아니다. 출처: arxiv.org/html/2610.21983v1.
평가 시 평균 LLM 호출 수는 OntoAct 27.1회, IfR 21.5회로 방향이 반대다. 즉, 적은 토큰이 적은 호출을 뜻하지 않는다. 이 표는 현재 요금제의 청구액, 응답 지연, 장비·운영 비용을 측정한 것이 아니다. 내 시스템의 경제성을 판단하려면 지식 구축을 몇 번 재사용하는지, 호출과 토큰을 모두 집계했는지, 최종 성공과 실패한 수리 시도를 함께 비교했는지부터 확인해야 한다. 이는 저자 수치에서 도출한 평가 질문이지 검증된 운영비 절감 약속이 아니다. [근거: Appendix D.6, Table A22]
5. 지금 가져갈 것은 설치 약속보다 평가의 연결 구조다
이 연구는 심사 중인 사전 공개 논문이다. 실험은 합성 데이터와 시뮬레이터에서 수행됐고, 주어진 온톨로지 스키마와 상호작용 중 고정된 세계 규칙을 사용한다. 검증기가 현실 안전을 보장하거나 배포 준비가 끝났다는 주장은 저자도 하지 않는다. 생성기·에이전트·기준선 이식 코드·시드·프롬프트는 최종 출판본과 함께 공개하겠다고 적혀 있다. 검토한 버전 고정 본문과 PDF에서는 OntoAct 전용 저장소 링크를 찾지 못했으며, 다른 곳에도 없다고 단정하는 것은 아니다. [근거: Conclusion, Ethics Statement, Reproducibility Statement]
따라서 이 글은 당장 설치 가능한 도구 추천이나 독립 성능 재현 보고가 아니다. 가져갈 수 있는 구체적인 변화는 평가 기록의 연결 방식이다. 적용 전에는 “검색한 문서와 마지막 성공 여부”만 있었다면, 평가 설계에서는 “과거 조건 → 현재 관측 → 가설 상태 → 선택한 수리 → 승인·미승인 결과 → 수정한 가설”을 연결해 보자. 이 연결이 있어야 끝내 성공했더라도 같은 잘못된 수리를 몇 번 반복했는지, 어느 관측에서 설명이 바뀌었는지 구별할 수 있다.
함께 읽을 글
- ITBench-AA의 47%를 읽는 법: 장애 원인 누락과 과잉 진단을 나눠 보자: 원인 목록의 누락·과잉 진단과, 이번 글의 온라인 가설 갱신·실행된 수리 결과를 구분해 평가할 때 참고할 글이다. 두 벤치마크의 수치를 합산하지 않는다.
- 최종 DB는 맞는데 정책 확인은 빠졌다: Near-Miss로 변경 전 증거 감사하기: 업무 변경 전 선행 근거를 읽었는지 감사하는 문제와, 관측·수리 결과로 고장 설명을 바꾸는 문제의 차이를 비교할 때 읽을 글이다. 정책 읽기 감사가 OntoAct의 기능이라고 주장하지 않는다.
출처와 확인 범위
- 원문: OntoAct: Hypothesis-Based Neuro-Symbolic Agents through Ontological Abstraction, arXiv:2610.21983v1. 최초 제출은 2026년 10월 15일 14:34:15 UTC, 한국 시간으로 같은 날 23:34:15다. 심사 중이며 채택·동료심사 완료 결과로 다루지 않는다.
- 방법: 버전 고정 HTML의 §§2–3, Eqs. 7–9와 Appendix B.1–B.3. 수치·분모·비용: 같은 버전 PDF의 Tables 1–2, A6, A22 및 Appendix A.4.1/D.6/E.2를 대조한 보존 근거를 사용했다.
- 본문 비교값은 저자 보고다. 판단표와 개념도는 그 근거를 바탕으로 새로 작성했다. 모델 실행, 독립 재현, 원시 성공 횟수 재집계, 실제 설비의 안전성·운영비·지연 측정은 수행하지 않았다. 본문의 가상 사례는 실측 결과가 아니다.


댓글
댓글 쓰기