RunningTab: 읽은 근거가 최종 보고서에서 빠지는 이유와 요구사항 장부
에이전트에게 여러 문서로 보고서를 만들게 했다. 작업 기록에는 필요한 파일을 연 흔적이 있고, 그 안의 금액도 도구 출력에 남아 있다. 그런데 완성된 표에는 해당 거래처의 행이 없다. 이런 실패를 모두 검색 품질 문제로 분류하면, 이미 읽은 자료를 다시 찾는 데만 시간을 쓸 수 있다. 자료에 도달하는 일과 그 내용을 결과물에 옮기는 일은 서로 다른 단계다.
RunningTab은 이 간극을 다룬다. 에이전트가 적은 요구사항, 환경이 보존한 읽기 관찰, 목록에만 나타난 미열람 후보를 작업별 장부에 남긴다. 장부는 모델의 문맥창 바깥에서 유지된다. 중요한 것은 더 긴 요약을 쓰는 것이 아니라, 무엇을 제출해야 하고 어떤 근거를 이미 보았는지 다시 연결하는 구조다. 다만 근거를 연결했다는 사실만으로 최종 파일의 완전성이 증명되지는 않는다.
이 글은 2026년 10월 7일 제출된 「RunningTab: Direct Workspace Interaction with Environment-Side Tabs」의 arXiv v1 본문을 선정 시점에 보존한 자료로 해설한다. 동료심사 통과는 확인하지 않았다. 논문에서 보고한 결과와 편집자의 진단 제안을 구분하며, 모델 실행·독립 재현·실제 제품 설치를 수행했다고 주장하지 않는다.
1. 파일을 열었다는 기록은 보고서에 넣었다는 증거가 아니다
논문의 §3.1은 GPT-5.4 nano의 DCI 기준선을 Workspace-Bench에서 분석한다. 결과물을 실제로 만든 시도 가운데, 평가 기준이 요구하고 에이전트 관찰에도 나타난 서로 구별되는 수치 891개 중 19.8%가 결과물에서 빠졌으며 해당 기준도 충족하지 못했다고 보고한다. 이는 전체 과제의 19.8%가 실패했다는 뜻도, 모든 파일의 다섯 개 중 하나를 잃었다는 뜻도 아니다. 분모는 결과물이 생성된 시도에서 실제로 보여 준 특정 수치들의 집합이다.
이 관찰은 누락 진단을 바꾼다. 검색 기록에 경로만 보인 경우와 실제 내용이 출력된 경우를 먼저 나눈다. 다음에는 읽기 출력의 올바른 수치가 결과물의 어느 셀·문단·행에 있어야 했는지 찾는다. 필요한 정보가 아예 관찰에 없다면 탐색이나 문서 해석 문제일 수 있다. 관찰에는 있는데 결과물에 없다면 읽기 이후 연결이 끊어진 것이다. 이 분석은 논문 저자의 기준선 분석이지 이 글에서 새로 측정한 운영 장애율이 아니다.
2. 환경 쪽 장부의 세 칸은 누가 채우는가
RunningTab의 장부는 요구사항, 읽기 로그, 후보 파일로 구성된다. 요구사항은 모델이 작업 지시를 나누어 적는다. 환경이 모든 의무를 자동으로 알아내는 것은 아니다. 모델이 처음부터 예외 조건을 누락하면 장부에도 그 조건이 없을 수 있다. 따라서 장부의 항목 수와 원래 요청의 충족 여부를 별도로 대조해야 한다.
읽기 로그는 환경이 모델에게 실제로 보여 준 관찰을 요약하지 않고 보존하며, 파일 경로와 그 출력을 만든 명령을 출처로 붙인다. 후보는 목록에 경로만 나타났지만 아직 내용을 열지 않은 파일이다. 파일을 열면 후보에서 빠지고 읽기 로그에 대응하는 관찰이 남는다. §3.2–3.3에서는 이 장부를 문맥창뿐 아니라 작업공간 밖에 두어 자료 파일이나 제출 파일과 섞이지 않게 한다.
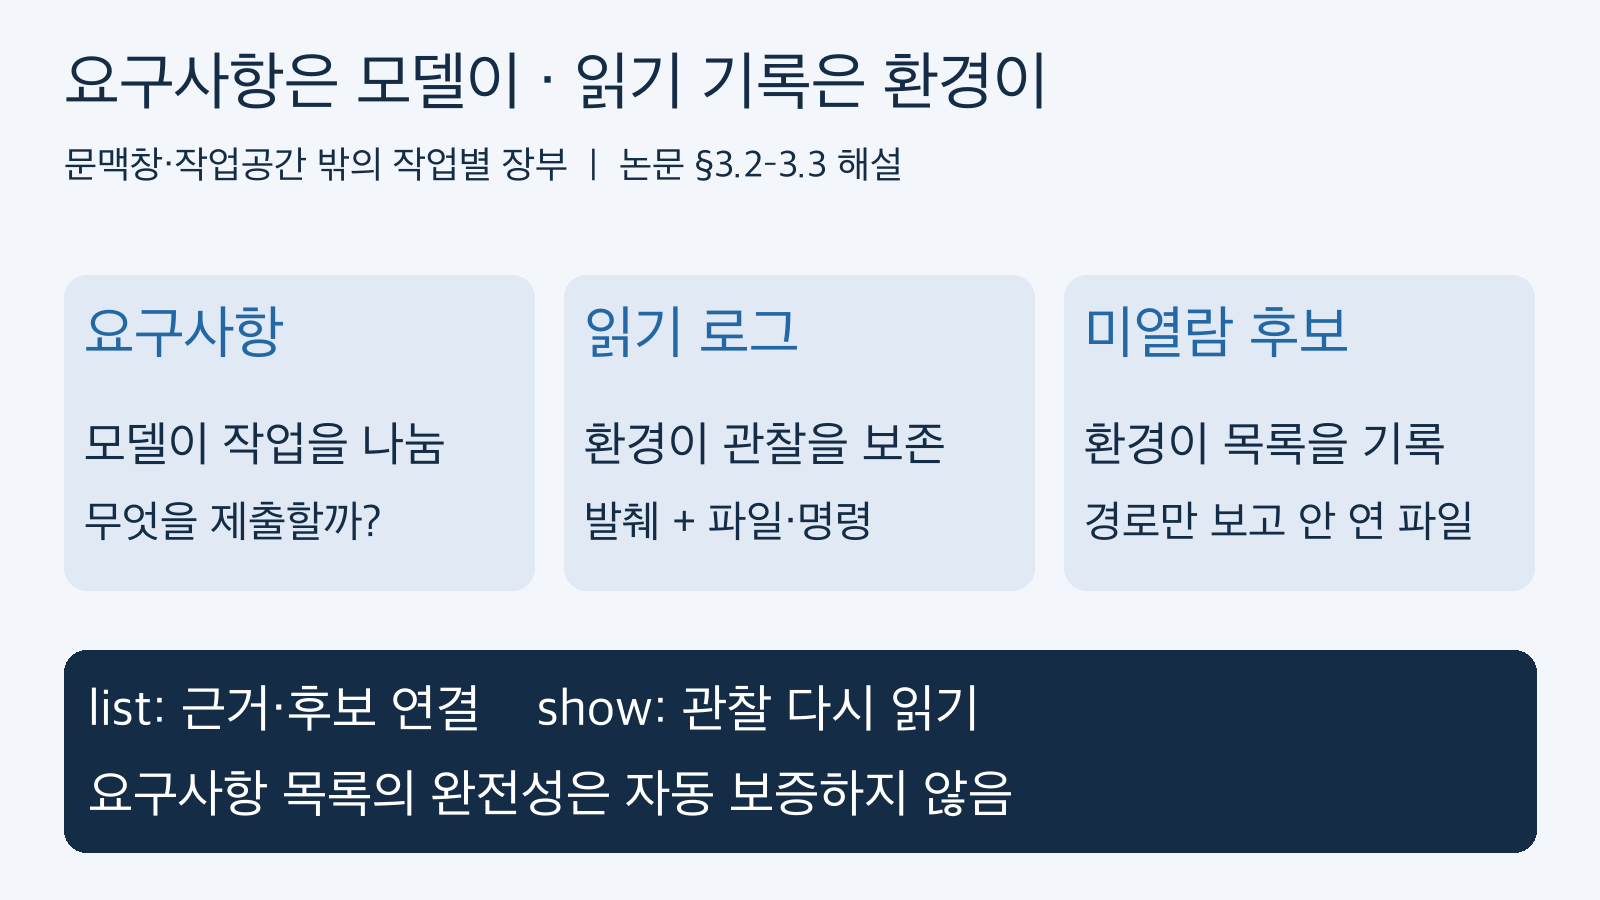
논문 §3.2–3.3의 구조를 새로 그렸다. 요구사항은 모델이 나누므로 목록의 완전성은 자동 보증되지 않는다. 출처: arxiv.org/html/2610.10444v1.
에이전트는 add로 요구사항을 적고, list로 상태와 대응하는 근거·미열람 후보를 보고, show로 저장된 관찰을 다시 읽으며, resolve로 요구사항을 정리한다. 목록의 대응 근거와 후보는 BM25 기반 어휘 관련성으로 정렬된다. 이는 새로운 의미 이해 모델이 정답을 보증하는 과정이 아니라, 이미 접근한 자료와 아직 열지 않은 후보를 재검토하기 쉽게 만드는 장치다.
3. 31.42%에서 46.91%: 무엇의 개선인가
표 1에서 Gemini 3.8 Flash의 Workspace-Bench Rubric Pass Rate는 DCI 31.42%, RunningTab 46.91%다. 각각 세 번 실행한 평균이며 표준편차는 2.89와 1.18이다. 한 실행에는 100개 과제와 평가 기준별 1,850개 평가 인스턴스가 있다. 이 비율은 충족한 평가 기준의 비중이다. 모든 조건을 만족한 과제의 성공률과 바꿔 말하면 안 된다.
두 평균의 차이는 15.49%포인트다. 단순 뺄셈은 논문 수치의 산술 확인이며 성능 재현은 아니다. 아래 그림은 비율을 영점부터 같은 척도로 표시한다. 상대 개선율 15.49%라고 표현하거나, 막대 높이를 비용 절감으로 해석하지 않는다.
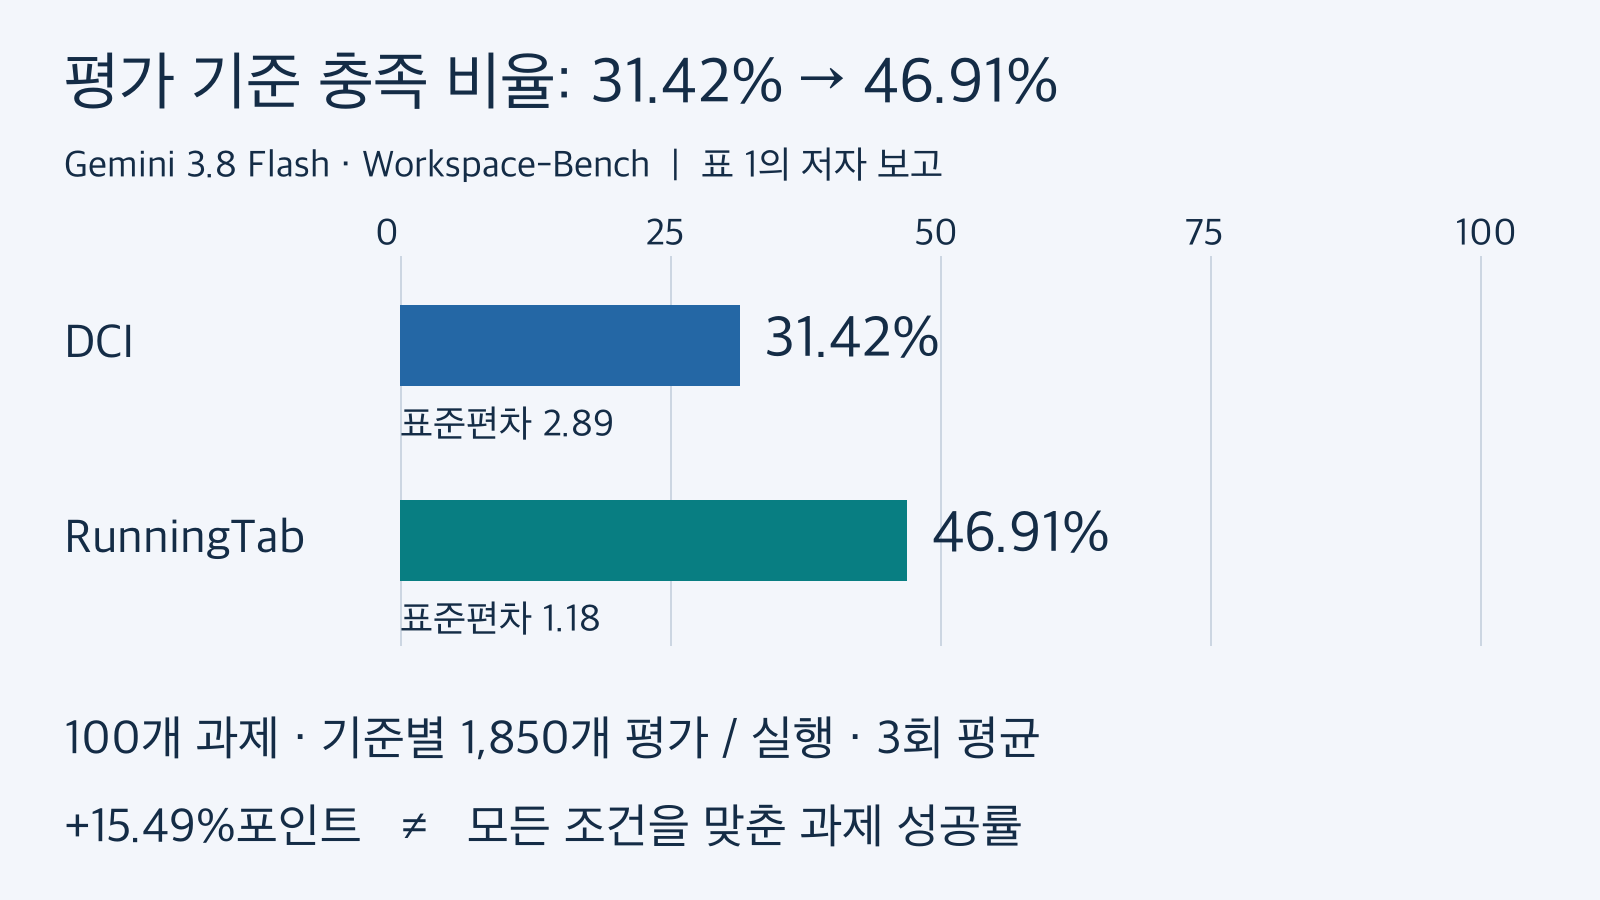
표 1의 저자 보고, 세 번 실행한 평균과 표준편차다. 실행당 100개 과제·1,850개 평가 기준이며 차이는 15.49%포인트, 전체 조건을 맞춘 과제 성공률이 아니다. 출처: arxiv.org/html/2610.10444v1.
논문의 별도 지표 TCR@70은 과제마다 평가 기준의 최소 70%를 충족한 과제의 비중이다. 같은 모델의 값은 DCI 23.33%, RunningTab 36.33%지만 이 역시 완전한 정답률이 아니다. 기준 충족 비율과 임계값을 넘은 과제 비율은 분모가 다르다. 운영 보고서에서 두 수치를 나란히 놓는다면 반드시 지표 이름과 조건을 함께 적어야 한다.
실험은 DCI-Agent-Lite와 Pi 하네스를 사용하고, 모든 방법에 최대 300턴·과제당 최대 한 시간·레벨 3 문맥 관리를 적용했다. 같은 상한은 실제 토큰 사용량, 실행 시간, 달러 비용이 같다는 뜻이 아니다. LLM 판정이 필요한 평가는 GPT-5.4 mini를 사용하며, RunningTab의 장부 호출은 판정용 궤적에서 제거한다. 여기서 비용이나 지연시간의 개선을 따로 주장할 근거는 확보하지 않았다.
4. done은 의미 검증이나 납품 검사를 대신하지 않는다
§3.4의 resolve는 요구사항과 인용한 경로·발췌 사이에 공통 어휘가 전혀 없는 인용을 거부한다. 이 어휘 중첩 검사는 근거 없는 연결 일부를 걸러낼 수 있지만, 그 문장이 요구사항을 실제로 뒷받침하는지까지 판정하지 않는다. 같은 단어가 있는 다른 연도의 금액이나 다른 부서의 규정을 연결해도 의미가 맞는지는 별도로 확인해야 한다.
요구사항은 done뿐 아니라 unavailable로도 정리할 수 있다. 뒤에는 이유가 필요하다. unavailable은 계산하거나 작성해야 하는 항목을 표시하는 데도 쓰이므로, 모두 resolved라는 상태가 모든 콘텐츠의 납품을 뜻하지 않는다. 특히 결과물 파일 경로를 장부의 출처처럼 가리키는 일은 논문의 구성에서 요구사항을 닫는 근거로 인정하지 않는다. 출처 관찰과 제출 파일은 역할이 다르다.
첫 종료 시도에는 마무리 검사가 한 번 전달된다. 부록 B 그림 9는 요구사항이 없거나 남아 있거나 모두 정리된 경우를 나누며, 모두 정리됐어도 실제 결과물에 내용이 들어 있는지 확인하도록 요청한다. 하지만 이는 무제한 재시도나 강제 완료 반복이 아니다. 논문이 추가한 마지막 검토 기회와, 운영자가 별도로 적용할 제출 차단 검사는 구분해야 한다.
5. 독자용 진단표: 같은 누락에 같은 처방을 쓰지 않는다
읽지 못했다면 탐색을 고치고, 읽었는데 빠졌다면 근거와 결과물 위치의 연결을 고친다.
아래 진단표와 장부 예시는 편집자의 운영 제안이며, RunningTab 구현이나 효과를 독립 재현한 결과가 아니다.
| 작업 기록에서 확인한 상태 | 먼저 볼 연결 | 다음 조치의 후보 | 완료라고 부를 때 필요한 증거 |
|---|---|---|---|
| 파일 경로만 목록에 있고 본문은 안 보임 | 요구사항 → 미열람 후보 | 후보 파일을 열고 내용 확인 | 요구한 내용이 실제 관찰에 나타남 |
| 본문은 읽었지만 필요한 값이 안 보임 | 요구사항 → 읽기 범위 | 해당 쪽·시트·범위를 다시 확인 | 기간·대상·단위까지 맞는 발췌 |
| 값이 관찰에 있으나 제출 파일에서 빠짐 | 읽기 근거 → 결과물 위치 | 해당 행·셀·문단에 반영 후 파일 재열람 | 정확한 위치에서 내용·단위 확인 |
| 장부는 done인데 연도·대상·값이 다름 | 연결의 의미 | 출처와 제출 내용의 조건 비교 | 같은 항목·기간·단위의 대응 |
| unavailable인데 결과물이 완료로 보고됨 | 미제공 이유 → 사용자 요구 | 작성·계산·자료 부재를 구분하고 공개 | 실제 반영 여부 또는 미충족 설명 |
| 제출 문서 자체가 생성되지 않음 | 최종 파일 산출 | 파일 경로·형식·내용 검사 | 열리는 파일과 필수 내용의 존재 |
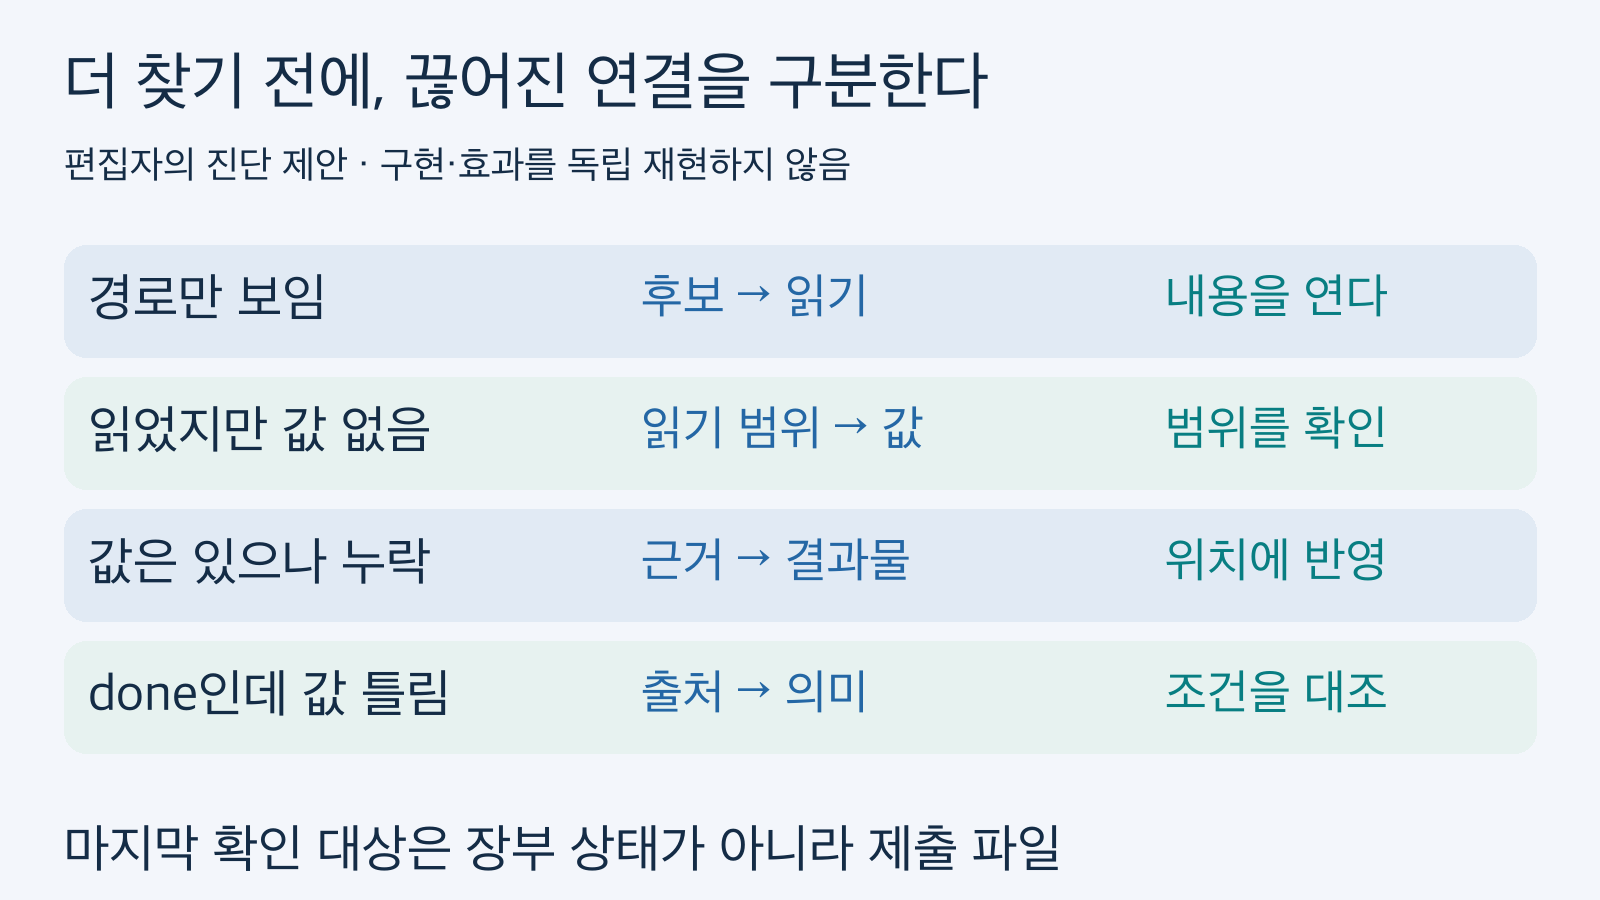
편집자의 진단 제안이다. 자료를 더 찾기 전 끊어진 연결을 분류하며 최종 확인 대상은 제출 파일이다. 구현이나 효과를 독립 재현하지 않았다. 출처: arxiv.org/html/2610.10444v1.
이 표의 핵심은 모든 실패에 검색을 추가하지 않는 것이다. 작업 로그에서 이미 관찰한 내용이 있는지 먼저 분류하고, 수리할 연결을 좁힌다. 그리고 수리가 끝났다는 판단은 장부의 자기 보고가 아니라 실제 제출 파일을 다시 열어 내린다. PDF·문서·스프레드시트라면 형식에 맞는 텍스트 추출이나 셀 읽기로 그 위치를 확인할 수 있다. 여기서 특정 검사 도구를 설치하거나 실행해 보았다는 뜻은 아니다.
6. 한 행을 놓친 표에 적용하는 장부 예시
예를 들어 사용자가 거래처별 청구 요약을 요청했다고 하자. 이 설명에 등장하는 가상의 청구 파일과 120만원은 진단 구조를 보여 주기 위한 합성 예시이며 논문의 측정값이 아니다. 요구사항을 단순히 “표 작성”으로 적으면, 표가 존재한다는 사실로 모든 거래처 행의 누락을 감출 수 있다. 대신 “거래처 A의 해당 기간 청구액과 단위를 표시”처럼 결과물에서 확인할 항목으로 나눈다.
읽기 근거에는 “거래처 A, 해당 기간, 120만원”이 실제로 보인 발췌와 파일·명령의 출처를 대응시킨다. 결과물 위치에는 “요약표의 A 행, 청구액 열”처럼 확인할 대상을 적는다. 상태는 읽기 확인과 제출 확인을 나눠 둔다. 읽기 확인만 끝난 경우에는 자료를 더 찾기보다 누락된 행을 반영하고, 저장된 최종 표를 다시 열어 본다. 이 위치 칸은 논문의 장부가 자동으로 제공한다고 소개하는 기능이 아니라 이 글에서 덧붙인 제안이다.
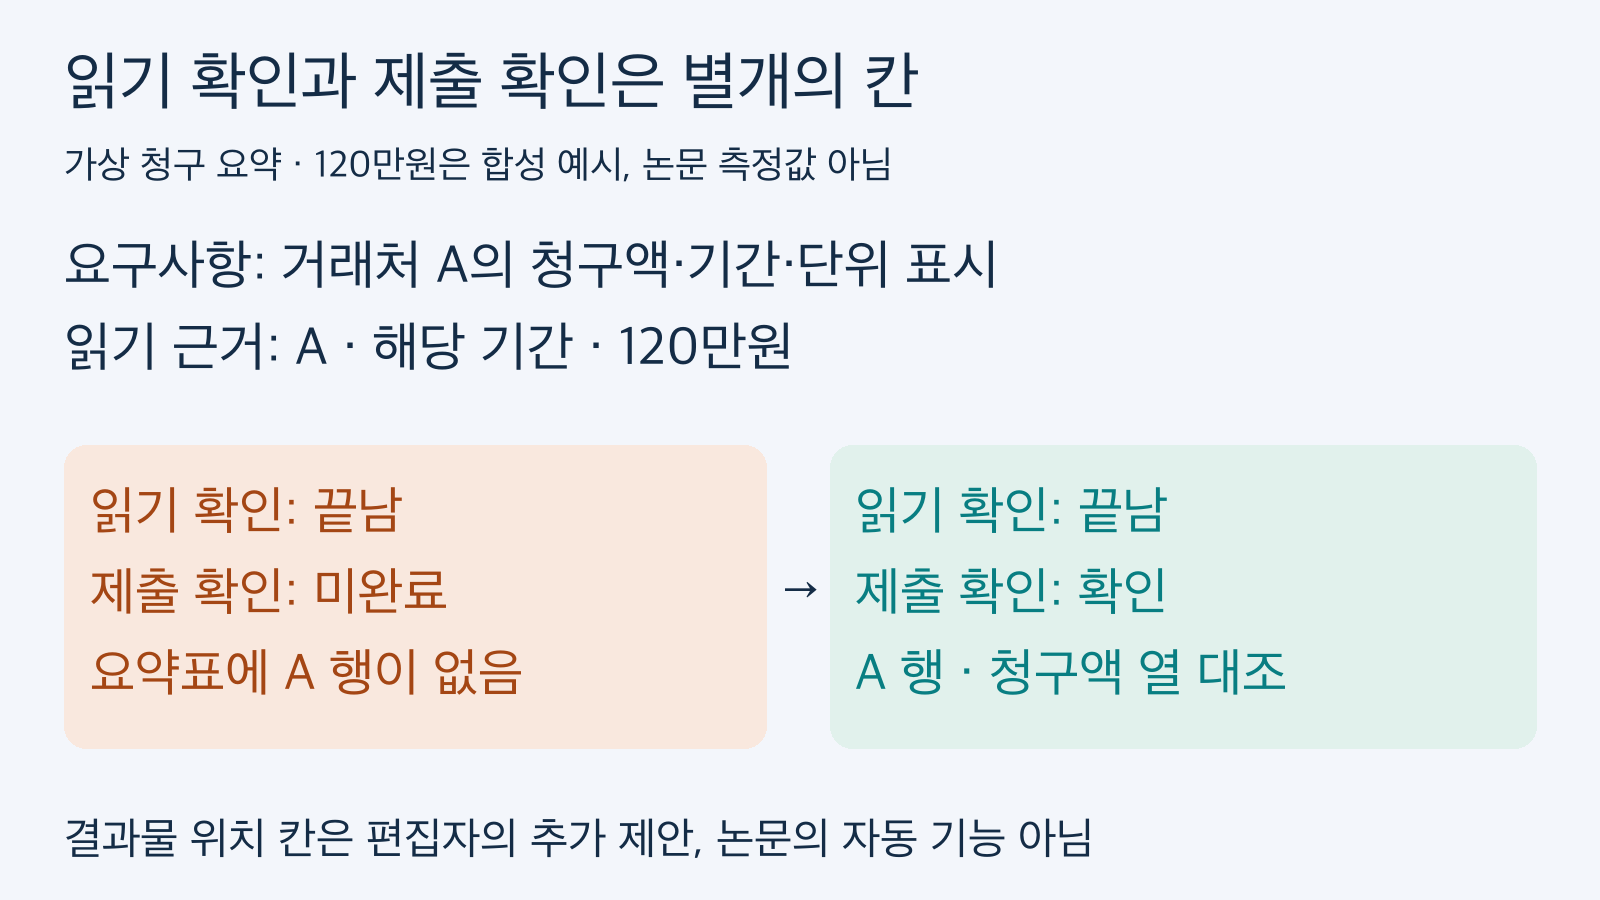
120만원과 청구 상황은 합성 예시다. 읽기 확인과 제출 확인을 분리하는 위치 칸은 편집자의 제안이며 논문의 자동 기능이나 실측 결과가 아니다. 출처: arxiv.org/html/2610.10444v1.
검사는 숫자 문자열의 존재만 찾는 것으로 끝내지 않는다. 같은 120만원이 다른 거래처의 행에 있어도 요구사항은 미충족이다. 필요한 기간, 통화·단위, 거래처 식별자, 행의 맥락까지 비교한다. 반대로 근거 자료에 필요한 값이 없으면 unavailable이라는 이유만 적고 완료로 보고하지 말고, 실제 요청에서 무엇을 제공하지 못했는지 설명한다. 단위를 잘못 바꾼 경우도 누락과는 다른 오류로 기록해야 다음 수리가 정확해진다.
7. 장부를 보존하는 효과와 한계는 따로 읽는다
표 4의 GPT-5.4 nano 제거 실험에서는 RunningTab의 Pass Rate가 44.73%, 환경 기록을 제거한 조건이 41.36%다. 그러나 이 조건에서는 읽기 로그와 후보를 쓰는 리뷰·근거 검사도 함께 제거된다. 따라서 차이를 순수한 기록 저장만의 독립 인과 효과로 해석하면 안 된다. 여러 연결이 함께 달라진 비교다.
또한 논문이 보고한 94.8% 보존율은 최종 결과물에 빠졌던 특정 수치가 장부에 남아 있는지를 본 조건부 지표다. 전체 과제의 완료율이 아니다. 보존, 다시 찾기, 내용 반영, 최종 정답은 각각 다른 확인 대상이다. 이 구분을 유지해야 “자료를 잘 보관했다”는 결과를 “납품을 성공했다”로 부풀리지 않을 수 있다.
연구 범위는 세 모델·세 벤치마크·하나의 하네스 구성과 세 번의 반복에 묶인다. 사내 자료의 권한 관리나 실제 비용, 다른 모델·환경에 대한 일반화는 따로 검증해야 한다. 읽기 관찰을 그대로 저장하면 민감한 작업공간 정보가 장부에도 남을 수 있다. Ethics Statement는 작업공간과 같은 접근 통제를 적용하고 결과물을 검토할 것을 권한다. 원문에서 RunningTab 전용 공개 구현이나 설치 가능한 재현 패키지는 확인하지 못했으며, 연결된 Pi를 이 연구의 공개 구현으로 소개하지 않는다.
8. 운영에 가져올 것은 완료 표시보다 연결 검사다
이 연구에서 가져올 질문은 “기억을 더 길게 남길까”만이 아니다. 요구사항을 누가 적었는지, 실제로 본 근거가 무엇인지, 그 근거가 결과물의 어디에 들어갔는지를 나누어 볼 수 있는지가 중요하다. 요청 자체를 빠뜨린 장부, 의미가 맞지 않는 인용, 자료만 남고 납품 내용은 없는 상태는 서로 다르다. 작업 기록을 수집하는 단계와 결과물 검사를 통과한 단계도 별개로 기록한다.
관련 글 AutoCompact: 오류를 기억한 요약이 왜 작업을 끝내 버릴까는 압축된 상태가 후속 행동을 제약하지 못하는 문제를 다룬다. 이번 연구는 압축 정책을 학습하는 방식이 아니라, 읽기 관찰과 요구사항을 환경 쪽에 유지하는 구조라는 점이 다르다. 연관 글은 한 편만 연결했다. 다른 관련 후보에는 아직 예약 상태인 글이 있어 공개 본문을 검증하지 못한 링크는 넣지 않았다.
실무적으로는 이미 읽은 자료를 다시 찾으라고 지시하기 전에, 해당 요구사항의 근거와 최종 파일 위치를 먼저 대조해 볼 수 있다. 다만 이 진단 제안의 효과를 이 글에서 측정한 것은 아니다. 장부를 참고하되 최종 파일에 내용이 있다는 확인까지 남기는 것, 그것이 읽기 기록과 납품 증거의 차이다.
출처와 검증 범위
- RunningTab v1 전문: §3.1과 그림 2의 읽은 수치 누락 분석, §3.2–3.4의 장부와 마무리 검사, §4의 평가 조건, 표 1의 지표·평균·표준편차, 표 4의 제거 조건, 부록 B 그림 8·9의 인용 검사·종료 메시지, Ethics Statement.
- RunningTab v1 서지: 제목과 저자, 2026년 10월 7일 v1 제출 기록. 원고는 버전 고정 증거에 근거한다.
본문 그림은 논문의 수치와 구조를 바탕으로 직접 구성한 도식이다. 논문 그림·제품 화면·공식 로고의 복제물이 아니며, 합성 예시는 별도로 표시했다. 원고와 그림의 구성·표현 정리에 AI 도구를 사용했다. 원문 읽기와 공개 수치의 산술 확인은 독립 실험이나 실제 RunningTab 운용을 뜻하지 않는다.


댓글
댓글 쓰기