압축 추론 모델이 반복한다면: TGAS로 정답률과 종료 실패 구분하기
프루닝한 추론 모델이 같은 풀이를 반복한다고 해서 곧바로 토큰 한도를 늘리지는 말자. 먼저 구분할 것은 ‘답을 틀린 경우’와 ‘추론을 끝내지 못한 경우’다. TGAS 논문의 같은 체크포인트에서는 AIME-25 추론 종료율이 39.2%에서 44.2%로 높아졌는데도 최종 정답률은 26.7%에서 25.8%로 낮아졌다. 잘 멈추는 모델이 반드시 더 잘 맞히는 모델은 아니라는 반례다. 근거는 원문 Table 5와 §5다.
이 글의 결론은 간단하다. 토큰 한도를 올리기 전에 같은 문제와 체크포인트에서 최종 정답률, 한도 내 추론 종료율, 생성 토큰 수를 따로 기록하자. 아래 진단표는 그 결정을 돕기 위한 것이지, 새로운 모델 성능 측정치는 아니다.
1. 실패 로그를 두 갈래로 나누면 다음 실험이 달라진다
가중치 프루닝은 일부 가중치를 0으로 만드는 압축 방식이다. 이 논문은 그 이후 정답률이 떨어지는 이유 중 하나로, 답을 확정하지 못하고 반복에 빠지는 ‘reasoning divergence’를 분석한다. 논문에서 추론 도중 정답처럼 보이는 값이 발견됐다는 사실은 최종 답을 맞혔다는 뜻이 아니다. 최종 답 단계에 도달해 답을 확정해야 정답으로 센다. 또한 추론 종료 토큰을 냈는지와 최종 답의 정확성은 서로 다른 측정이다. §3 및 Appendix C.1–C.3을 구분해서 읽어야 한다.
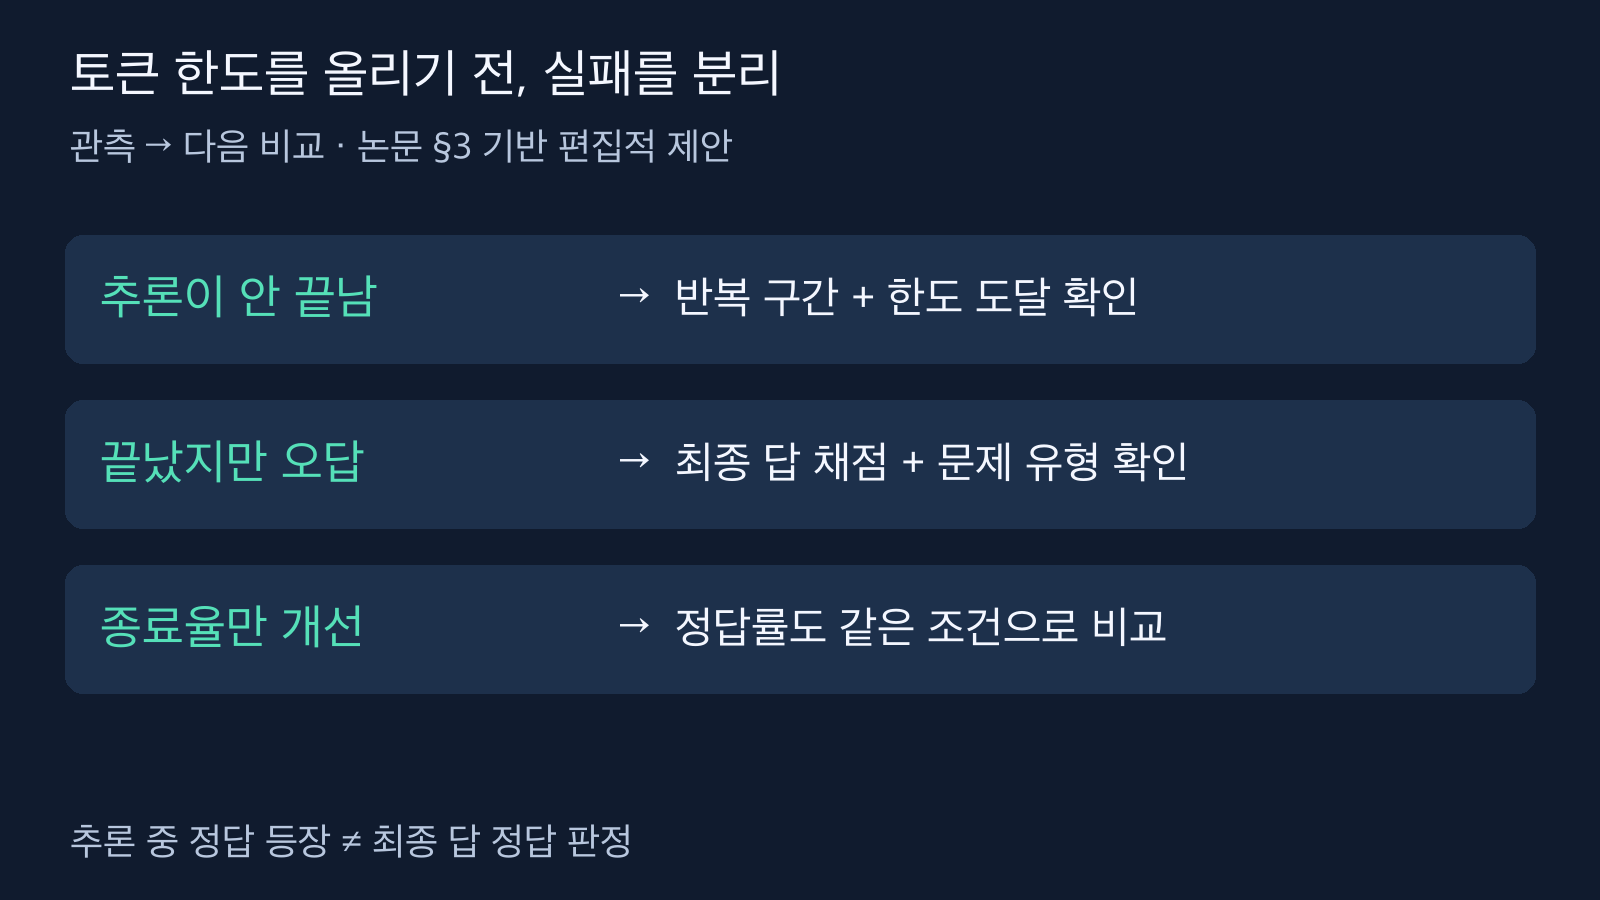
논문 §3을 토대로 작성한 편집적 진단 절차다. 추론 중 정답 등장과 최종 답 정답 판정을 구분하며 실제 모델 실행 결과가 아니다. 출처: arxiv.org/html/2610.19934v1.
실제 평가에서는 다음처럼 관측 항목과 다음 행동을 묶어 볼 수 있다. 이는 필자가 구성한 진단 절차다. 특정 관측 하나만으로 원인을 확정하거나 TGAS 적용을 권하는 규칙은 아니다.
| 관측한 결과 | 다음에 비교할 것 | 아직 말할 수 없는 것 |
|---|---|---|
| 한도까지 생성하며 같은 풀이를 반복한다 | 한도 내 추론 종료 여부와 반복 구간, 최종 답 유무 | 토큰만 더 주면 정답이 된다는 결론 |
| 추론은 끝났지만 최종 답이 틀렸다 | 채점 기준, 문제 유형, 프루닝 전후의 동일 문제 결과 | 종료 제어만으로 추론 능력이 복구된다는 결론 |
| 추론 종료율은 오르고 정답률은 내렸다 | 같은 체크포인트의 두 지표를 나란히 비교 | 종료율 개선을 정확도 개선으로 대체하는 해석 |
| 토큰은 줄었지만 서비스 응답이 느리다 | 동일 하드웨어의 지연·처리량과 개입 오버헤드 | 토큰 감소율만큼 요금·시간도 줄었다는 주장 |
평가 로그에는 문제 ID, 모델·프루닝 설정, 생성 한도, 샘플링 설정, 추론 종료 여부, 최종 답 채점, 생성 토큰 수를 남기는 편이 좋다. 서로 다른 한도나 문제 집합을 섞으면 종료 개선과 난이도 차이를 분리하기 어렵다. 논문의 예산 확대 실험 역시 한도를 늘리는 것이 보편적인 정답률 회복책은 아니라는 점을 보여준다. 다만 자신의 작업에서도 같은 현상이 재현되는지는 별도 평가가 필요하다.
2. 같은 14B 체크포인트에서도 세 시험의 방향이 다르다
Table 5의 DeepSeek-R1-Distill-Qwen-14B, obc_60을 보자. SparseGPT와 OBC 보정을 사용한 명목 60% 비구조적 프루닝 조건이다. 프루닝 대상은 디코더 선형 계층이고 임베딩과 lm_head는 조밀하게 남는다. 따라서 이를 전체 모델 메모리가 60% 줄었다는 말로 바꿔서는 안 된다. 비교의 Base는 프루닝하지 않은 원본이 아니라, 같은 프루닝 체크포인트에 TGAS를 적용하지 않은 추론이다.
| 평가 집합 | Base 정답률, % | TGAS 정답률, % | 추론 종료율, Base → TGAS |
|---|---|---|---|
| MATH-500 난도 4–5 | 67.6 ± 1.6 | 72.5 ± 1.3 | 80.2% → 88.9% |
| AIME-25 | 26.7 ± 4.7 | 25.8 ± 3.2 | 39.2% → 44.2% |
| LiveCodeBench-v6 쉬움·중간 | 37.6 ± 5.6 | 42.9 ± 2.6 | 46.6% → 53.7% |
± 값은 저자가 보고한 표준편차다. MATH는 262문항, AIME는 30문항, LCB는 95문항이고 각 문항에서 응답 4개를 생성해 평균을 보고했다. 네 번 중 한 번만 맞으면 성공인 pass@4도 아니고, 고유 문항 수가 네 배가 된 것도 아니다. 생성 한도는 응답당 16,384토큰, temperature는 0.6, top-p는 0.95다. 반올림된 비율에서 정확한 성공 응답 수를 역산하지 않는다. Appendix C.1의 조건이다.
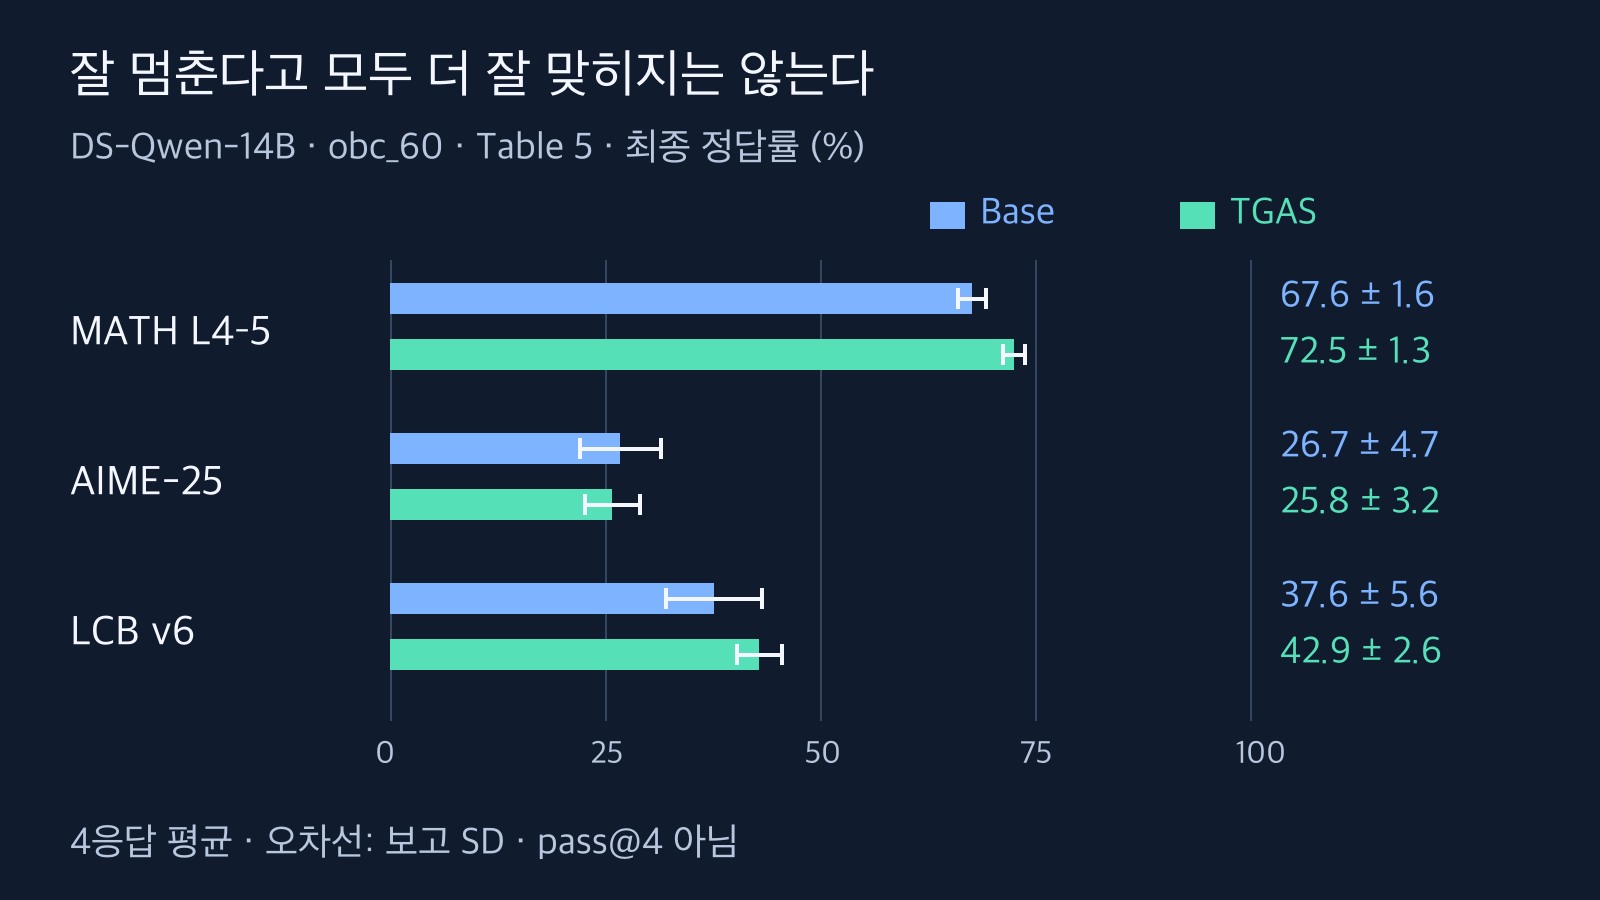
Table 5의 동일 프루닝 체크포인트 비교. Base는 같은 프루닝 모델의 비개입 추론이며 오차선은 저자 보고 표준편차다. AIME의 정답률 하락을 보존했다. 4응답 평균이지 pass@4가 아니다. 출처: arxiv.org/html/2610.19934v1.
표의 평균 정답률 44.0% → 47.1%는 세 시험을 같은 비중으로 평균한 수치다. 문항을 모두 합쳐 채점한 정답률은 아니다. Table 5에 붙은 +1.1은 Base 대비가 아니라 최고 경쟁 방법의 평균 46.0% 대비다. 전체 평균만 제목에 쓰면 AIME의 하락이 가려진다. 시험별 개선은 흔히 한 표준편차 안에 있었으며, 이 4응답 표에 부록의 별도 16응답 유의성 분석을 그대로 붙여서는 안 된다.
3. TGAS는 ‘이제 그만 생각해’라는 프롬프트가 아니다
TGAS는 Termination-Guided Activation Steering의 약자다. 같은 문제와 같은 추론 접두부에서 이어 쓴 결과를, 한도 안에 추론을 끝낸 집단과 끝내지 못한 집단으로 나눈다. 이어 각 집단의 은닉 상태 평균 차이에서 종료 방향을 만든다. 서로 다른 문제를 단순 비교하는 대신 공유 접두부별 차이를 사용하는 설계다. §4.1–4.3의 방법이다.
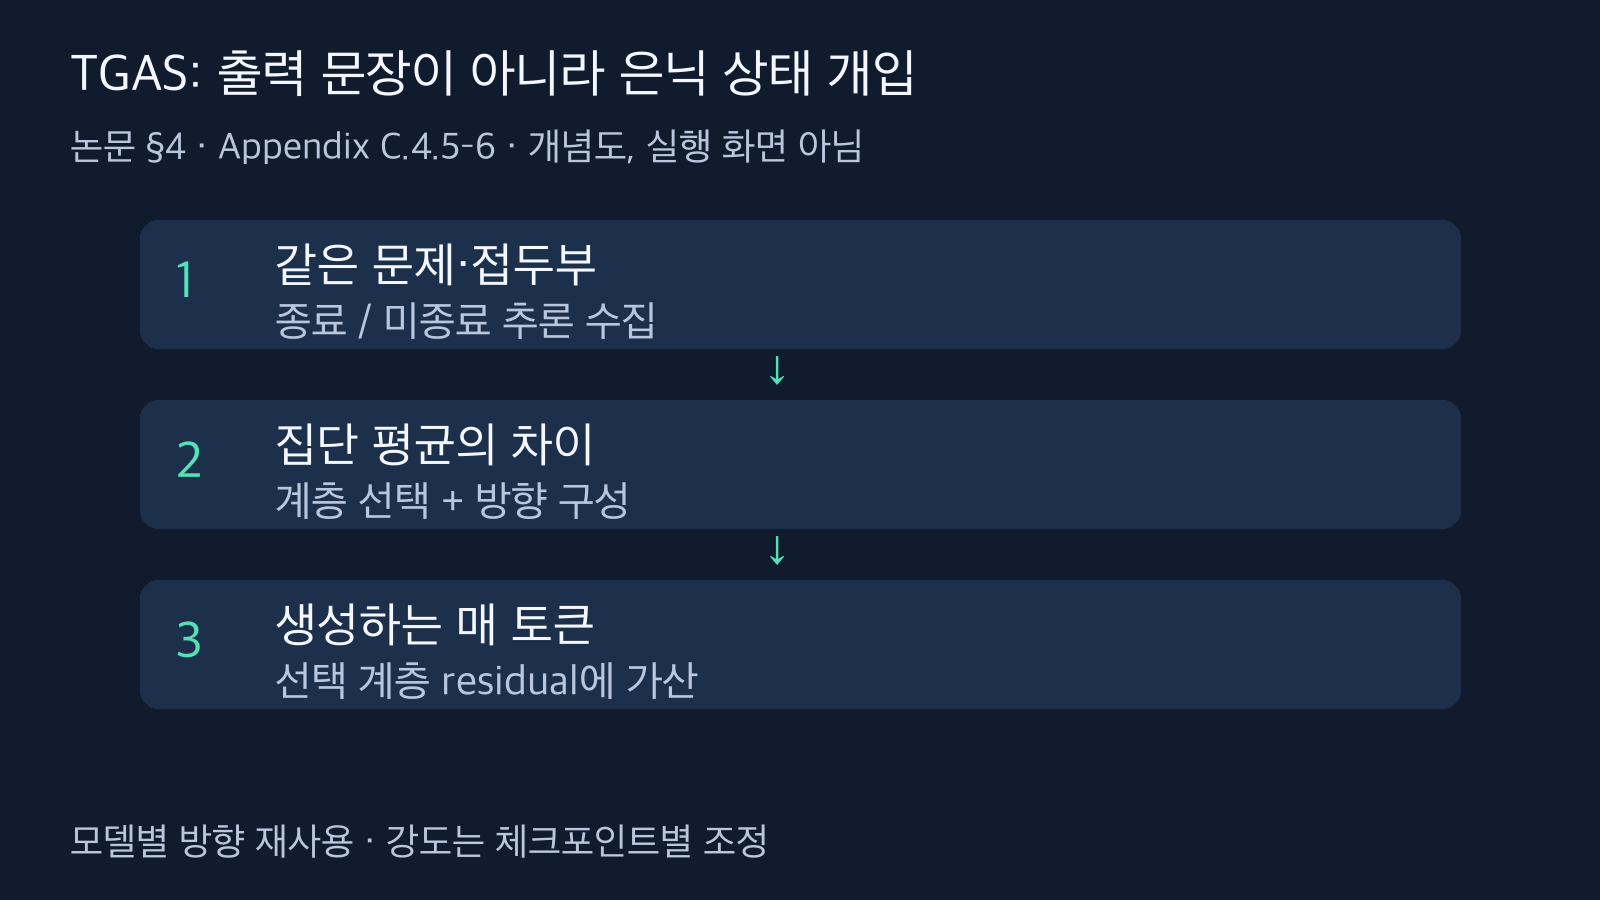
§4·Appendix C.4.5–6 기반 자체 개념도다. 평가 문제와 분리된 자료로 방향을 구성하며, 방향은 모델별로 재사용하지만 강도는 체크포인트별로 조정한다. 실행 화면이나 프롬프트 요령이 아니다. 출처: arxiv.org/html/2610.19934v1.
별도 검증 분기점에서 두 집단의 분리가 가장 좋은 계층을 고르고, 생성하는 매 토큰마다 그 계층의 residual stream에 크기를 조절한 방향 벡터를 더한다. 모델별 방향 하나를 여러 희소도에서 재사용하지만 개입 강도는 체크포인트별로 조정한다. ‘방향 하나’가 모든 모델에 공통으로 쓰이는 만능 벡터라는 뜻은 아니다.
또 하나 중요한 경계가 있다. 논문 분석에서 쓰인 문제와 실제 성능 평가용 방향 구성 자료를 혼동하면 안 된다. 평가에 사용한 방향은 MATH·AIME·LCB 시험 문제와 분리된 OpenR1-Math에서 구성했다. 이 방법을 적용하려면 은닉 상태와 residual stream에 접근할 수 있어야 한다. 출력 텍스트만 주고받는 닫힌 API에 문장 하나를 추가하는 방식과는 다르다. 이 글은 실행 코드나 검증된 배포 레시피를 제공하는 튜토리얼이 아니다.
4. 토큰 12.3% 감소는 청구서 12.3% 할인이 아니다
Table 8의 명목 60% 희소도 조건에서 저자는 생성 토큰 수가 평균 12.3% 줄고, 생성당 평균 1,423토큰을 절약했다고 보고한다. 이는 앞의 14B 하나의 결과가 아니다. 각 모델에서 세 벤치마크를 평균한 뒤, 여섯 모델의 감소율을 평균한 값이다. 비교 대상 역시 같은 모델·희소도의 비개입 추론이다. HTML §5의 토큰 문장은 Table 6을 가리키지만, 실제 토큰 표는 PDF와 일치하는 Table 8이다.
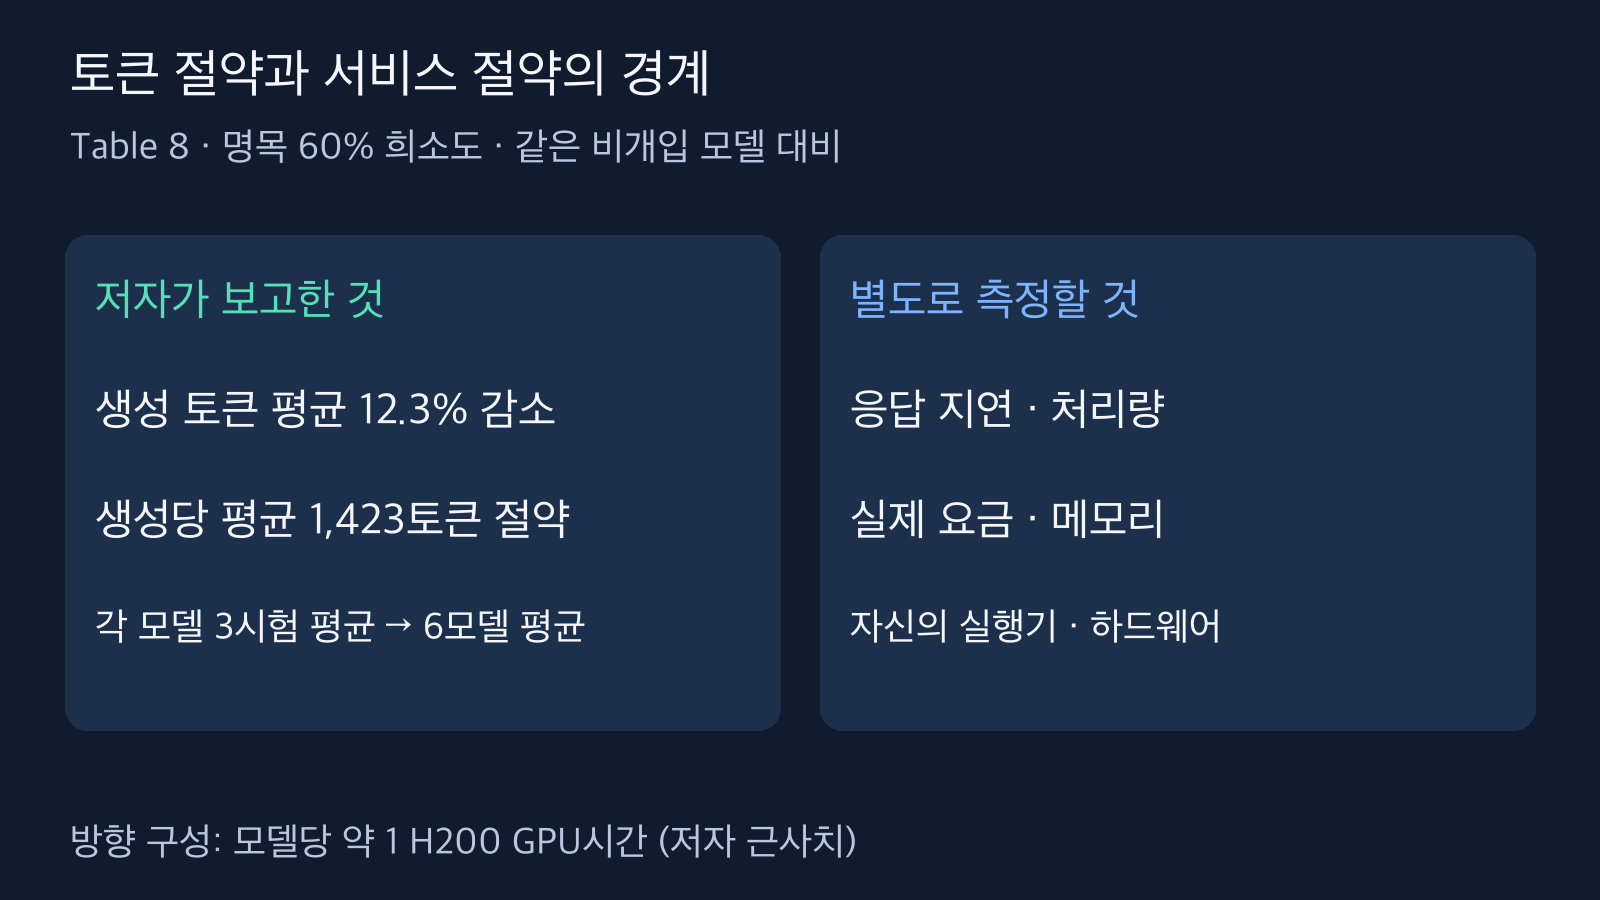
Table 8: 명목 60% 희소도에서 모델별 3시험 평균을 거친 6모델 평균으로 생성 토큰 12.3%, 생성당 1,423토큰을 절약했다는 저자 보고다. 서비스 비용 실측이 아니다. 방향 구성 약 1 GPU시간은 저자의 H200 144GB 기준 근사치다. 출처: arxiv.org/html/2610.19934v1.
토큰 수와 실제 지연은 다른 측정이다. 비구조적 희소성을 실행기가 활용하는지, 벡터를 더하는 개입 비용이 어떤지, 배치와 하드웨어가 무엇인지에 따라 서비스 결과는 달라질 수 있다. 이 논문의 토큰 수치만으로 메모리 절감, 처리량 향상, API 요금 할인을 확정하지 않는다.
‘재학습 없음’도 ‘준비 비용 없음’은 아니다. 저자는 방향 구성에 모델당 NVIDIA H200 144GB 기준 약 1 GPU시간이 들었다고 적었다. 이는 저자 하드웨어에서의 근사 보고이며 이 글의 실측이 아니다. 보정용 추론 생성, 계층 선택, 체크포인트별 강도 조정이 필요하고, 자신의 실행 환경과 모델 사용 조건도 별도로 확인해야 한다. 닫힌 API만 쓸 수 있다면 은닉 상태 개입 자체가 접근 권한의 경계가 된다. Appendix C.1·C.4.5–C.4.6의 비용과 설정을 함께 보자.
5. 도입보다 먼저, 실패 원인을 분리하는 평가에 쓰자
오늘 바로 가져갈 것은 특정 벡터가 아니라 비교 방식이다. 먼저 현재 체크포인트의 문제별 로그를 종료 실패와 종료 후 오답으로 구분한다. 그다음 같은 문제·한도·채점 조건에서 정답률과 종료율을 함께 본다. 토큰이 줄었다면 지연과 비용은 별도 측정으로 확인한다. 은닉 상태 개입을 시험할 환경이 있더라도 개입 강도를 고를 자료와 마지막 평가 문제를 분리해야 한다. 이 순서는 논문의 실험 경계를 실무 판단으로 옮긴 편집적 제안이다.
범위도 좁혀 읽자. 연구는 프루닝 이후의 복구, 비구조적 희소성, 최대 14B의 증류·SFT 추론 모델, 수학·코드 평가를 다룬다. RL로 학습한 추론 모델, 더 큰 모델, 자유로운 개방형 과제, 반구조적 희소성에도 같은 결론이 성립하는지는 확립되지 않았다. 심하게 프루닝해 능력 자체가 손상된 경우 종료 유도로 잃은 능력을 전부 되돌릴 수 없다. Limitations의 경계다.
Table 1의 ‘조밀한 모델이 맞힌 문제만’ 대상으로 한 결과나 ‘종료한 응답 중 정답률’은 전체 평가 정답률로 쓰면 안 된다. 답 포함 검출 규칙의 96.0% 일치율 역시 DS-Qwen-7B 추론 250개에 대해 Gemini 판정기와 일치한 비율이지, 사람이 매긴 정답 대비 정확도가 아니다. 지표 이름 옆에 분모를 적는 것만으로도 이런 과장을 줄일 수 있다.
이 진단 절차는 논문을 바탕으로 작성한 편집적 제안이며, TGAS를 직접 실행하거나 서비스 비용 절감을 검증한 결과가 아니다. AI를 활용해 공개 자료를 분석·편집했다. 이 연구는 2026년 10월 14일 제출된 사전 공개 논문 v1이며, 확인한 기록으로 동료심사 통과를 주장하지 않는다. ‘더 짧게 생각한다’보다 ‘무엇을 맞혔고 어떤 방식으로 멈췄는가’를 먼저 확인하는 것이 이 글의 독자 결정이다.
최종 답을 따로 검증해야 한다는 원칙은 형식에 맞는 답과 계산이 맞는 답은 다르다: Qwen 출력 검증과 함께 읽을 수 있다. 그 글은 출력 형식·최종 답의 의미·요청 지연을 나누는 사례이고, 여기서는 종료 여부·최종 정답률·생성 토큰 수를 나눈다. 서로 다른 모델 실험의 성능을 직접 비교하는 링크가 아니다.
6. 원문과 읽을 위치
- Minh-Anh Nguyen 외, To Reason but Not to Stop: Understanding and Recovering Pruned Large Reasoning Models, arXiv:2610.19934v1. 초록·버전 기록
- 전체 HTML: 진단 §3, 방법 §4, 같은 체크포인트 비교 Table 5, 토큰 집계 Table 8, 적용 범위 Limitations.
- 고정 버전 PDF: Table 5는 7쪽, Table 8은 8쪽, 실행 조건·GPU시간은 Appendix C.1의 13쪽. HTML 본문에 있는 토큰 표 번호 불일치는 PDF와 실제 표로 대조했다.
직접 확인한 원문 HTML 링크와 PDF 텍스트에서는 TGAS 전용 코드·벡터·원시 결과 저장소를 확인하지 못했다. 이것은 그런 자료가 어디에도 없다는 단정이 아니다. 일반 평가 도구의 참고 링크를 TGAS 공개 구현인 것처럼 제시하지 않는다.


댓글
댓글 쓰기