프롬프트 캐시가 깨졌다면: GPT-6에서 먼저 비교할 다섯 가지 변경
긴 대화를 그대로 보냈는데도 캐시 적중률이 떨어진다면, 먼저 모델 가격표가 아니라 요청의 앞부분을 비교해야 한다. 도구 이름은 같아도 스키마나 배열 순서가 달라졌을 수 있고, 지시문을 수정하면서 재사용 가능한 접두부를 끊었을 수도 있다.
OpenAI는 2026년 9월 22일 「Better prompt caching for GPT-6」에서 캐시 진단과 명시적 경계, 도구·지시문 변경 시 재사용을 보존하는 방법을 공개했다. 이 글의 실전 산출물은 변경 유형별 캐시 진단표다. 원문의 권장사항을 요청 변경→확인할 증거→수정 후보→재검증 순서로 정리했다. API 성능을 직접 측정한 보고서가 아니라 공식 발표에 근거한 편집자 분석이다.
1. 30분과 최대 90%는 무엇의 조건인가
공식 발표는 GPT-6 계열에서 30분 창 안에 재사용되는 적격 공유 접두부에 캐시 할인을 제공한다고 설명한다. 또 캐시된 입력 토큰에 대해 최대 90% 할인을 언급한다. 모든 요청이 30분 동안 반드시 적중한다는 보장도, 전체 청구액이 90% 줄어든다는 뜻도 아니다. 할인 대상은 캐시된 입력이며 출력 토큰과 캐시되지 않은 입력까지 같은 비율로 줄어드는 것은 아니다.
실무에서는 세 항목을 따로 보자. 재사용 가능한 앞부분이 있는지, 실제 요청에서 캐시된 입력 비중이 얼마인지, 최종 비용과 응답 지연이 어떻게 변했는지다. 캐시 적중률만 높아도 불필요하게 긴 문맥을 계속 보내면 전체 비용 최적화와는 어긋날 수 있다.
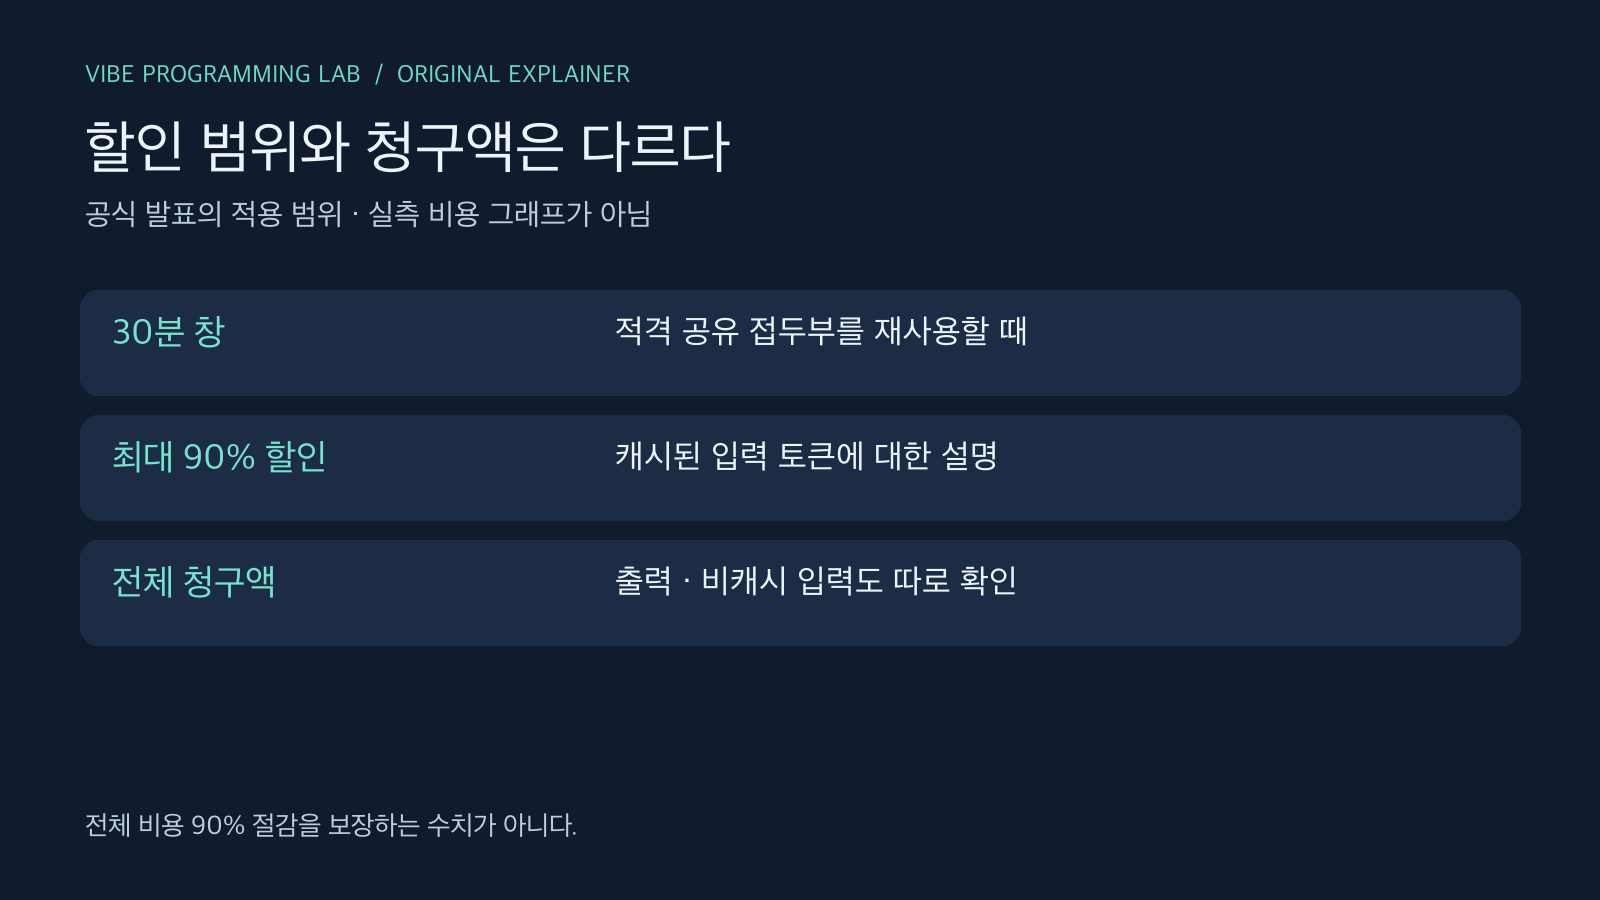
그림 1. 할인 범위와 청구액은 다르다. 전체 비용 90% 절감을 보장하는 수치가 아니다. 출처: openai.com/index/better-prompt-caching-for-gpt-6.
2. tools_changed를 보면 도구 삭제부터 멈춘다
새 대시보드는 캐시·비캐시 입력 구성을 보여 주며, 진단 도구는 최근 응답과 요청을 비교해 모델·도구·설정·입력의 변경을 찾도록 돕는다. 발표의 예시는 reason: tools_changed와 함께 comparison_reusable_tokens: 5629, cache_missed_tokens: 5629를 제시한다. 이 숫자는 원문에 든 진단 응답 예시이지, 우리 서비스에서 측정한 손실이나 모든 요청의 고정 손실이 아니다.
이유가 도구 변경이라면 도구 정의의 이름만 확인해서는 부족하다. 스키마와 순서도 비교해야 한다. 원문은 정의·스키마·순서를 안정적으로 유지하고, 그때 호출할 수 있는 도구는 allowed_tools로 제한하라고 권한다. 도구가 필요 없는 턴에는 정의를 제거하는 대신 tool_choice를 none으로 설정하는 방법도 설명한다.
이는 캐시를 위해 권한을 넓히라는 조언이 아니다. 호출 가능한 집합과 서버 측 권한 검사는 별개다. 민감한 기능을 노출하면 안 되는 환경에서는 보안 경계를 우선하고, 허용된 정의 안에서 안정성을 확보해야 한다. 캐시 최적화를 권한 통제의 대체물로 삼아서는 안 된다는 것은 이 글의 운영상 해석이다.
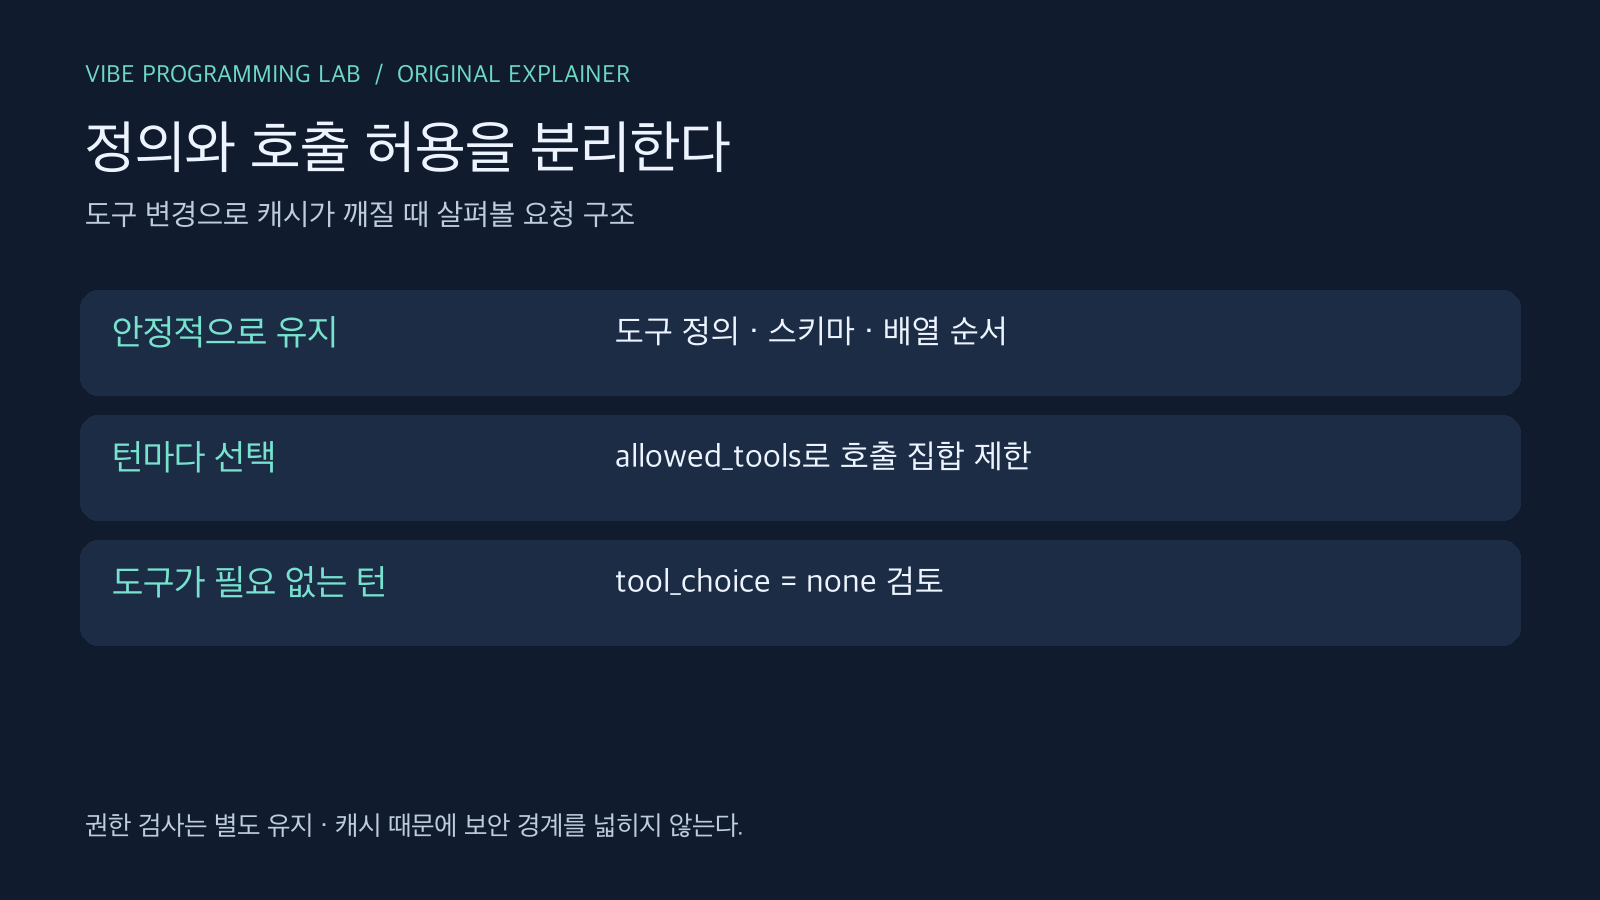
그림 2. 정의와 호출 허용을 분리한다. 권한 검사는 별도 유지 · 캐시 때문에 보안 경계를 넓히지 않는다. 출처: openai.com/index/better-prompt-caching-for-gpt-6.
3. 실전 진단표: 변경 하나, 증거 하나
아래 표는 공식 API의 자동 판정 규칙이 아니라 변경을 좁히기 위한 편집자 진단 순서다. 한 번에 모든 설정을 바꾸지 말고, 비교할 요청 쌍에서 변경 원인을 하나씩 분리한다.
| 방금 바꾼 것 | 먼저 비교할 증거 | 수정 후보 | 통과 판단 |
|---|---|---|---|
| 매 턴 도구를 추가·삭제했다 | 도구 정의·스키마·배열 순서와 진단 사유 | 허용된 정의는 유지하고 allowed_tools로 호출 집합 제한 | 새 요청의 캐시 입력 비중과 비용을 함께 비교 |
| 오래된 지시문을 앞쪽에서 고쳤다 | 최초로 달라진 지시문 위치 | 필요한 새 지시를 뒤쪽 developer 메시지에 추가 | 앞부분 재사용과 새 지시 이행을 각각 확인 |
| 추론 강도를 바꿨다 | 요청 수준 reasoning effort 변경 여부 | GPT-6에서 요청 수준 값은 유지하고 configuration_update 추가 | 난도별 응답 품질과 캐시 재사용 모두 확인 |
| 안정된 문서 뒤에 자주 바뀌는 내용이 섞였다 | 공통 접두부의 실제 경계 | 명시적 캐시 경계와 변동 내용 위치 검토 | 재사용 구간과 갱신된 내용의 반영을 따로 확인 |
| 첫 질문만 유난히 느리다 | 시작 시 처리할 공통 문맥이 있는지 | 알려진 문맥의 prewarm 검토 | 사용자 대기 지연과 전체 처리 비용을 구분해 측정 |
이 표는 API를 실행해 얻은 성능 결과가 아니며, 적중률·절감액·지연 개선을 보장하지 않는다. 진단 사유와 영향 토큰은 조사할 위치를 좁히는 증거이지, 수정 후 효과의 측정값이 아니다.
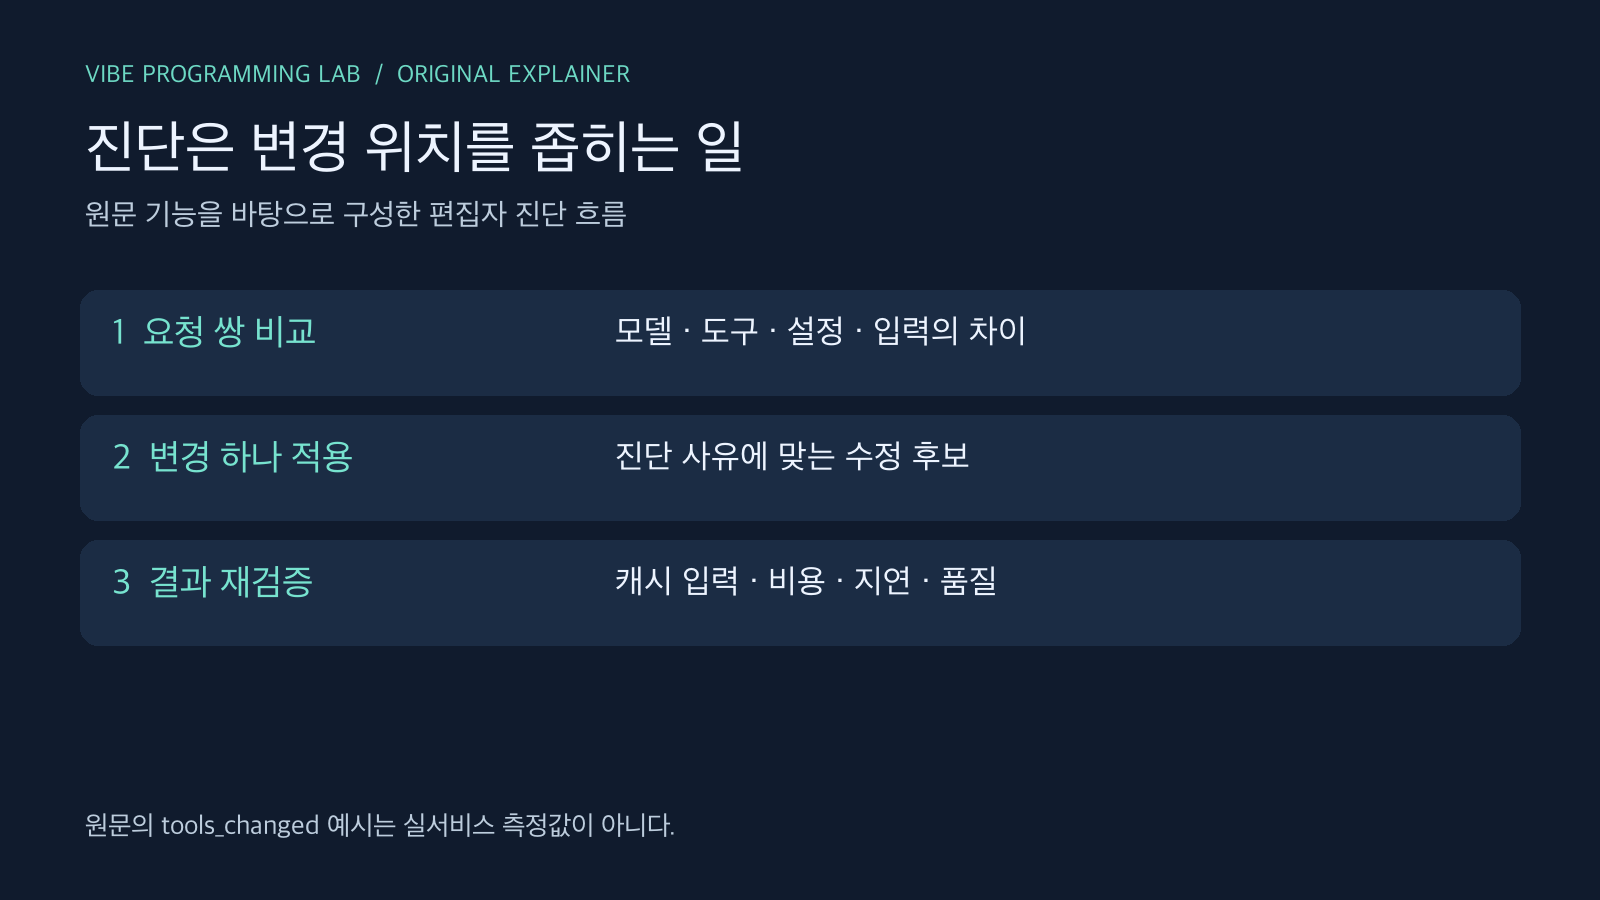
그림 3. 진단은 변경 위치를 좁히는 일. 원문의 tools_changed 예시는 실서비스 측정값이 아니다. 출처: openai.com/index/better-prompt-caching-for-gpt-6.
4. 지시와 추론 설정은 뒤에 추가할 수 있다
원문은 새 developer 메시지를 문맥 뒤쪽에 추가해 이전 지시를 덮어쓰는 방식을 권한다. 앞부분을 매번 다시 작성하는 것과 달리 안정된 문맥을 유지하려는 선택이다. 다만 오래된 지시와 새 지시가 충돌할 때 실제 응답이 원하는 규칙을 따르는지는 별도로 검증해야 한다. 비용 절감만 확인하고 동작 의미를 놓치면 안 된다.
GPT-6 모델에서는 요청 수준의 reasoning effort를 그대로 두고 configuration_update를 추가해 응답 사이의 추론 강도를 바꿀 수 있다고 설명한다. 어려운 턴과 단순한 후속 턴을 다르게 처리하면서 캐시 재사용을 유지하기 위한 기능이다. 다른 모델 계열이나 오래된 클라이언트까지 똑같이 지원한다고 일반화하지 않는다. 이 글은 확인하지 않은 요청 JSON 형식을 추측해 제시하지 않는다. 실제 통합 때는 공식 가이드의 현재 스키마를 확인해야 한다.
명시적 캐시 경계도 같은 관점에서 읽을 수 있다. 안정된 안내·참고 자료와 자주 변하는 요청을 분리하면 어느 구간을 재사용하려는지 명확해진다. 아래 그림은 실제 서버 내부 구조나 측정 결과가 아니라 문맥 배치를 설명하기 위한 원본 도식이다.
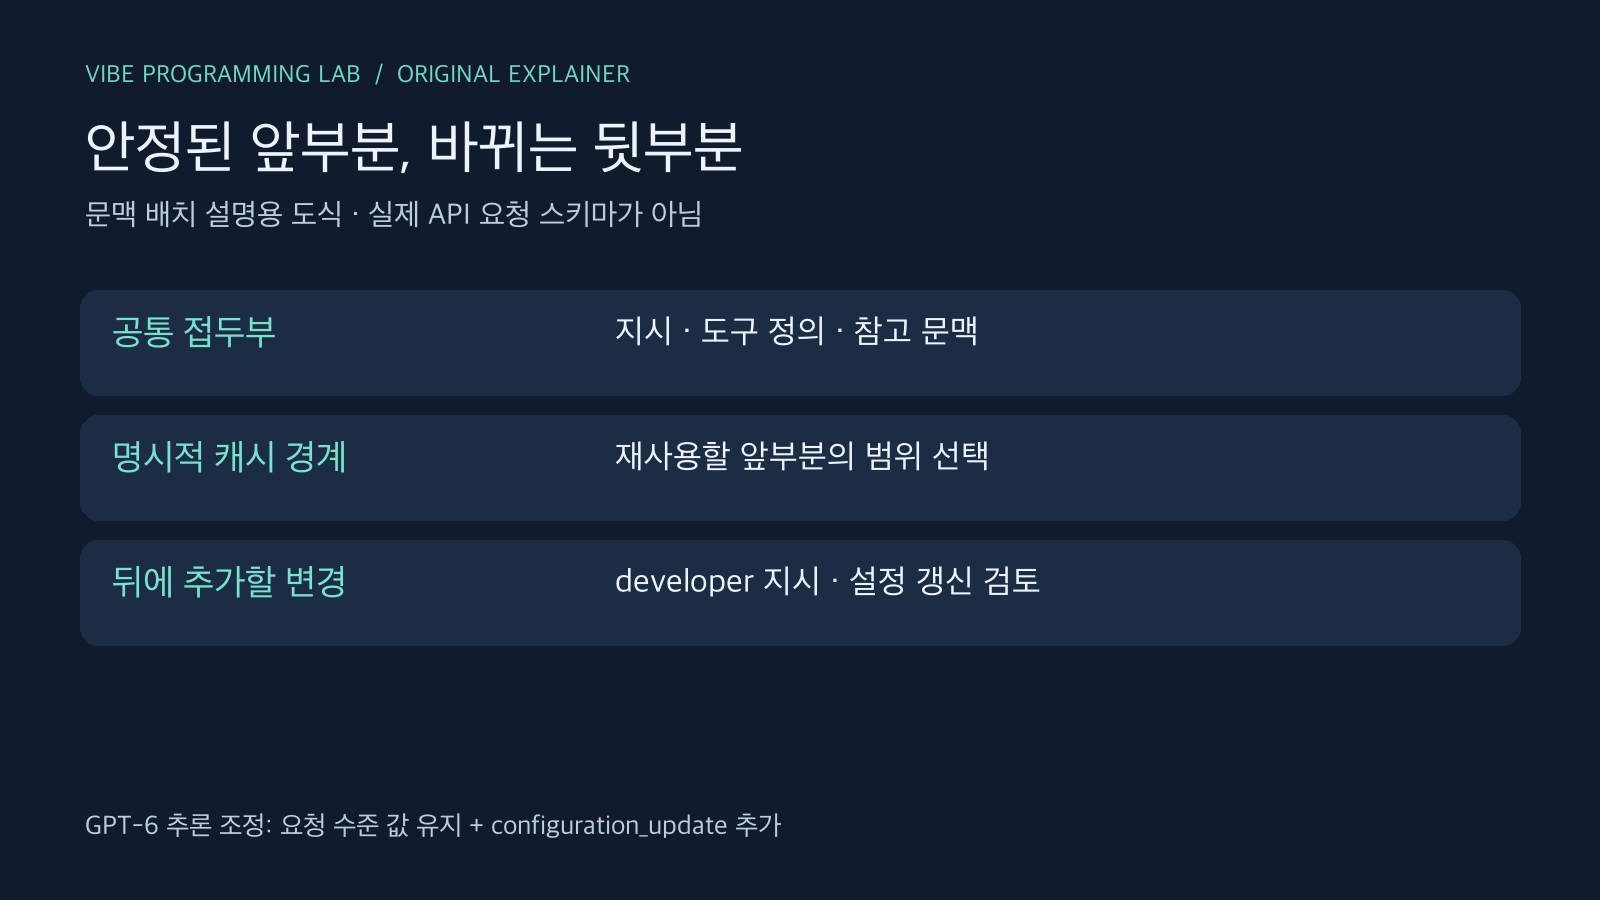
그림 4. 안정된 앞부분, 바뀌는 뒷부분. GPT-6 추론 조정: 요청 수준 값 유지 + configuration_update 추가 출처: openai.com/index/better-prompt-caching-for-gpt-6.
5. 미리 데우기와 총비용 절감은 다른 질문이다
Prewarming은 사용자의 요청이 오기 전에 알려진 공통 지시·도구 정의·참고 자료를 처리해 두는 방식이다. 발표는 앱 시작 시 이런 문맥을 준비해 첫 질문의 대기 시간 밖으로 처리를 옮길 수 있다고 설명한다. 그렇다고 처리 자체가 없어지는 것은 아니다. 따라서 평가 항목을 첫 응답 지연과 전체 비용으로 나누는 편이 합리적이다.
적용 순서는 간단하다. 먼저 기존 요청의 캐시·비캐시 입력과 지연을 기록한다. 다음으로 진단 사유에 맞는 변경 하나를 적용한다. 마지막으로 비슷한 작업에서 품질, 비용, 지연을 함께 비교한다. 트래픽 구성이나 모델까지 동시에 달라졌다면 결과를 캐시 변경 하나의 효과라고 단정하지 않는다. 이 비교 설계는 원문의 기능을 운영에 연결하기 위한 제안이며, 여기서 실제 API 벤치마크를 수행한 것은 아니다.
관련해서 싼 모델 라우팅의 KV 캐시 비용 경계는 모델을 오갈 때 문맥 재처리가 단가 이점을 상쇄하는 가상 계산을 다룬다. 이번 글은 모델 선택이 아니라 동일 계열 API에서 요청 변경을 진단하는 방법에 초점을 둔다. 로컬 프리픽스 캐시와 실행 재현성은 다른 문제다. 그 연구의 경로 차이 수치를 GPT-6 hosted API의 품질 변화로 옮겨 해석해서는 안 된다.
캐시가 깨졌을 때의 첫 질문은 “더 싼 모델이 있는가”가 아니라 “앞부분에서 무엇이 바뀌었는가”다. 도구 정의, 지시문 위치, 추론 설정, 문맥 경계를 나눠 보면 손댈 지점이 구체적이 된다. 그 다음에야 실제 청구액과 응답 지연으로 최적화의 가치를 판단할 수 있다.
참고 자료
- OpenAI — Better prompt caching for GPT-6, 2026-09-22: Monitor caching and diagnose cache misses; Optimize caching for your application. 수치와 기능 설명의 공식 원문이며 사용자 사례의 절감률을 일반 성능 보장으로 사용하지 않았다.


댓글
댓글 쓰기