계산은 맞았는데 답은 틀렸다: 파일로 넘긴 도구 출력의 근거 대체
에이전트가 읽은 값은 2.75065, 고른 답은 2.750이었다. 그런데 같은 계산이 만든 정식 보고서에는 2.751이 이미 찍혀 있었다. 계산을 다시 시키기 전에 물어야 할 것은 따로 있다. 에이전트가 최종 답의 근거로 삼은 파일은 무엇이었을까?
2026년 10월 19일 제출된 사전 공개 논문 「Same Simulation, Different Evidence」는 이 문제를 PHREEQC라는 지구화학 시뮬레이터의 객관식 문제로 살펴본다. 일반 웹 검색이나 모든 코딩 업무를 평가한 연구가 아니다. 이 글은 저자들의 실험을 읽고 개발자의 도구 출력 설계에 적용할 진단표를 제안한다. 모델·시뮬레이터 실험을 독립 재현한 사용기는 아니며, 동료심사 통과도 확인하지 않았다.
1. 더 자세한 값이 정식 보고서를 밀어낸 순간
논문의 문항 121 사례에서 GPT-5.1은 시뮬레이터를 실행하고, 자신이 따로 정의한 선택 출력 파일 sel.out을 읽었다. 이 파일은 pH를 2.75065로 보여준다. 에이전트는 정식 보고서 result.out을 열지 않은 채 보기 A인 2.750을 답으로 남겼다. 정식 보고서는 보기의 자릿수에 맞춰 2.751을 출력하며, 정답은 B다. 본문 §4, 그림 1; 부록 B, 그림 4
여기서 핵심은 숫자가 길수록 나쁘다는 뜻이 아니다. 더 많은 자릿수를 가진 값을 최종 보기의 정밀도에 맞춰야 하는 상황에서, 에이전트가 반올림 대신 끝자리를 잘라 버렸다는 것이다. 연구자들은 정식 도구 보고서 대신 에이전트가 직접 정의한 파생 출력에 기대어 답하는 현상을 ‘근거 대체(evidence substitution)’라고 부른다. 원래 파일의 정보가 사라진 것과, 파일은 남아 있지만 경쟁하는 다른 근거를 선택한 것은 다른 실패다.
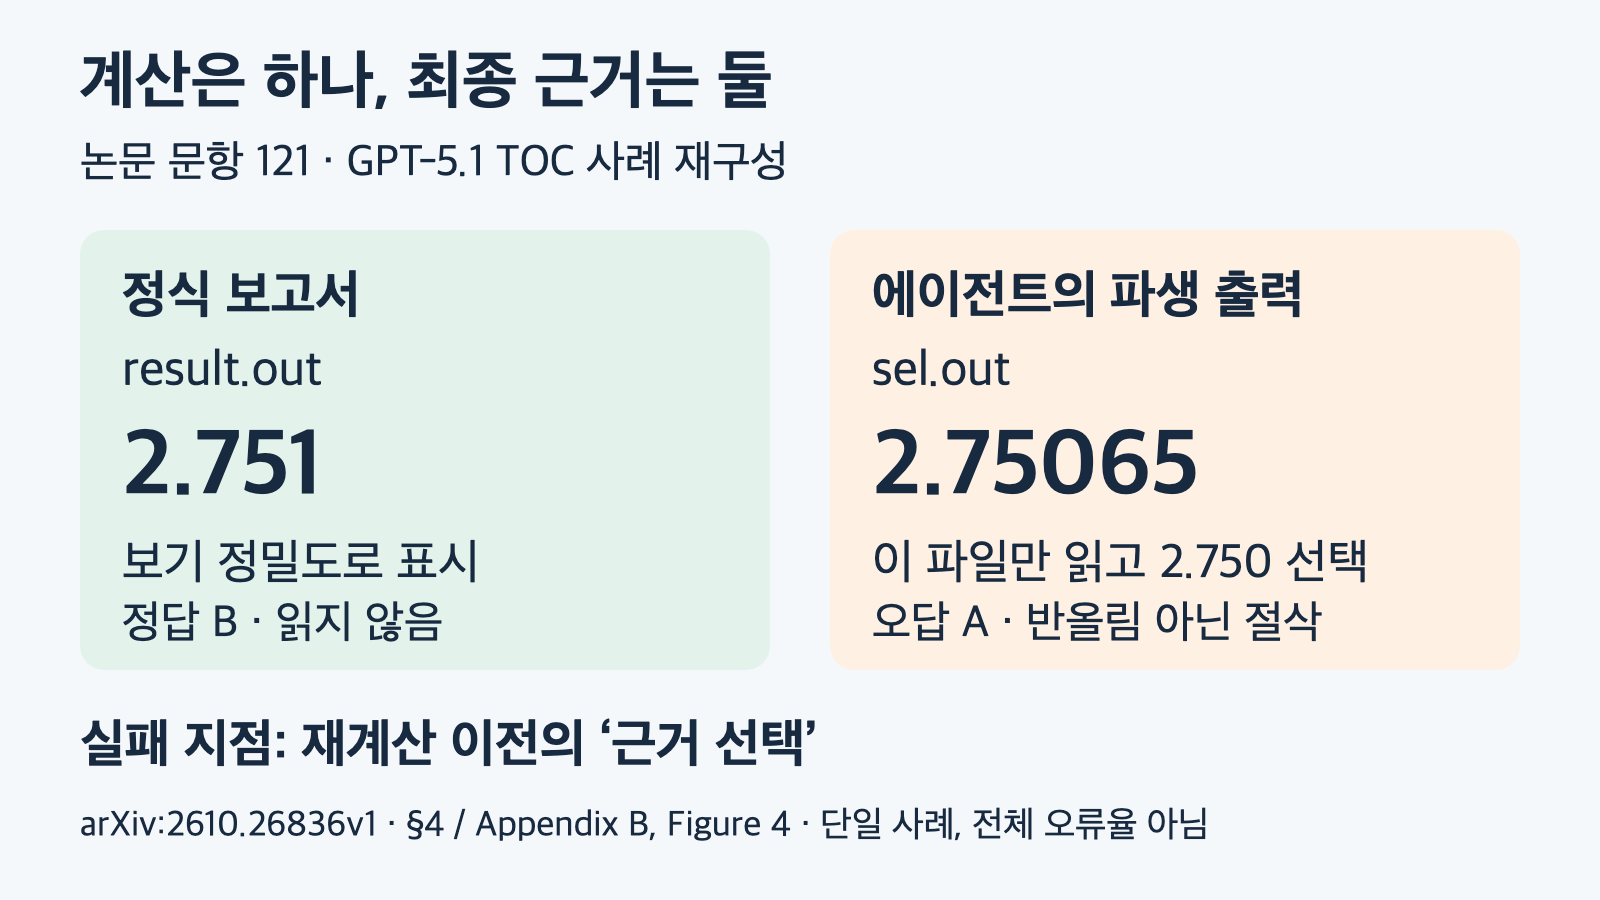
그림 1. 동일 계산의 두 출력을 원문 사례에 맞춰 재구성했다. 더 많은 자릿수 자체가 아니라 정식 보고서를 읽지 않은 채 절삭한 선택이 문제다. 전체 문항의 오류율이 아니다. 출처: arxiv.org/html/2610.26836v1.
실무에서도 같은 구분이 필요하다. 예를 들어 요약 CSV가 더 짧아서 읽기 쉽다고 해서, 그 안의 단위·반올림 규칙·중간값이 원래 도구의 최종 결과와 같다고 보장할 수는 없다. 다만 이것은 논문에서 유도한 설계상의 주의점이지, CSV를 쓰는 모든 제품에서 같은 오류를 관찰했다는 주장은 아니다. 정식 근거는 파일 이름의 권위가 아니라 해당 업무가 정답으로 정한 값과 표현 규칙에 따라 정해야 한다.
2. 계산을 고정해도 반환 방식만으로 차이가 났다
저자들은 전체 에이전트 비교와 별도로 GPT-5.2의 실행 중간 지점을 고정하는 재개 실험을 했다. 숫자 정답 문항 137개 가운데 첫 종료 코드 0의 실행이 있는 131개를 골랐다. 여기서 ‘성공한 실행’은 프로그램이 정상 종료했다는 뜻이지, 정답을 계산했다는 뜻은 아니다. 실제 고정 보고서에 정답 값이 들어 있는 문항은 84개였다.
두 조건은 파일, 이전 대화, 시스템 프롬프트, 읽기 도구, 남은 턴을 공유한다. 한쪽은 보고서를 문맥에 직접 넣는 Raw100k, 다른 쪽은 절 제목과 시작 줄이 있는 목차인 TOC를 반환한다. 이후 파일을 읽고 답을 낼 수 있지만 시뮬레이터를 다시 돌릴 수는 없다. Raw100k의 한도는 10만 문자이며 토큰 수가 아니다. 너무 긴 보고서는 앞뒤를 잘라 전달한다. 본문 §4; 부록 D, 표 10
같은 131개 지점에서 조건별로 세 번씩 재개한 결과, 직접 전달은 393회 중 280회, 목차 반환은 393회 중 243회 정답이었다. 공개된 건수를 다시 나누면 각각 약 71.2%, 61.8%이고, 목차 조건이 약 9.4퍼센트포인트 낮다. 저자들이 보고한 95% 짝지은 문항 부트스트랩 구간은 −14.5에서 −4.6퍼센트포인트다. 이 글에서 새로 검산한 것은 건수의 비율과 차이뿐이며, 신뢰구간을 재추정하거나 모델 실험을 돌린 것은 아니다.
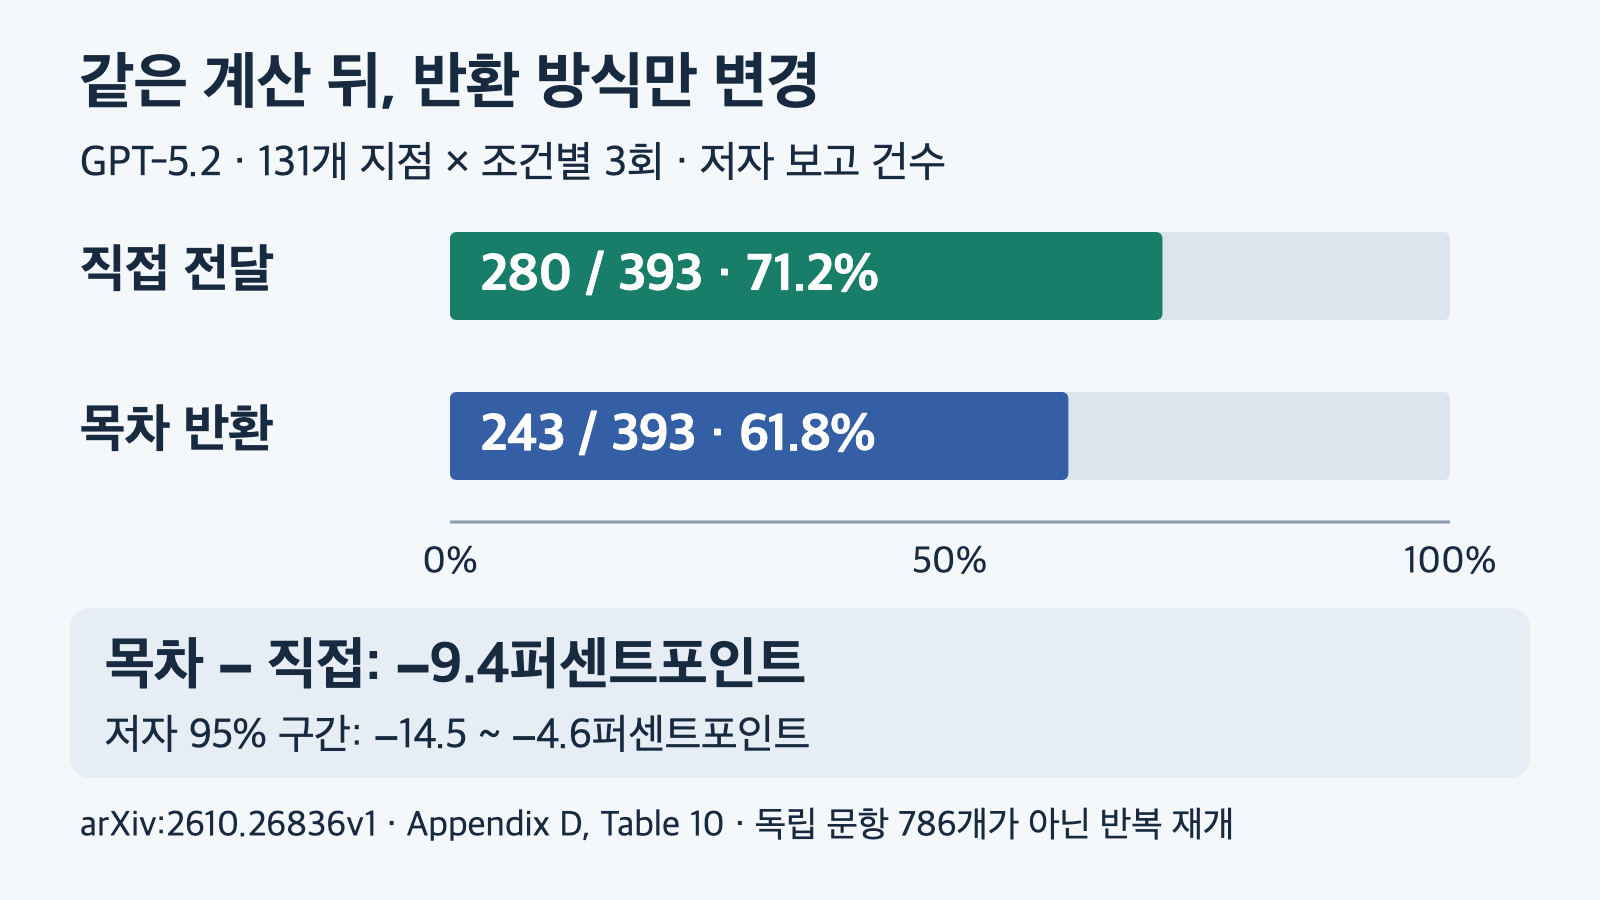
그림 2. GPT-5.2의 같은 131문항을 조건별 3회 재개한 저자 보고다. 비율과 차이만 검산했으며 95% 구간은 저자 추정치를 옮겼다. 독립 문제 786개나 이 글의 모델 실험 결과가 아니다. 출처: arxiv.org/html/2610.26836v1.
총 786회라는 숫자를 독립 문제 786개로 읽으면 안 된다. 같은 131문항을 두 조건에서 반복한 연속 실행 수다. 일부 문항은 같은 시뮬레이션 설정을 공유하며, 첫 반복 결과를 본 뒤 두 반복이 추가되었다는 한계도 원문에 적혀 있다. 이 통제 실험은 계산을 바꾸지 않아도 전달 방식의 영향이 남는다는 근거지만, 모든 모델이나 업무에 9.4포인트 손실이 생긴다는 예측은 아니다.
3. 전체 정확도만 보면 실패 지점이 가려진다
연구진은 도구 사용의 흐름을 세 단계로 나눈다. 첫째, 자체 계산이 정답 값을 만들었는가(build). 둘째, 만들어진 값이 반환 본문이나 파일 읽기를 통해 에이전트에게 전달됐는가(exposure). 셋째, 그 값을 본 경우 정답을 골랐는가(closure). 뒤의 두 비율은 각각 앞 단계의 조건을 만족한 경우에 한정한 비율이다. 세 수치를 모두 전체 문항 대비 성공률처럼 나란히 더할 수 없다. 정답 값을 보지 못했는데도 우연히 맞힌 답도 별도로 남는다. 본문 §2.3, 표 3
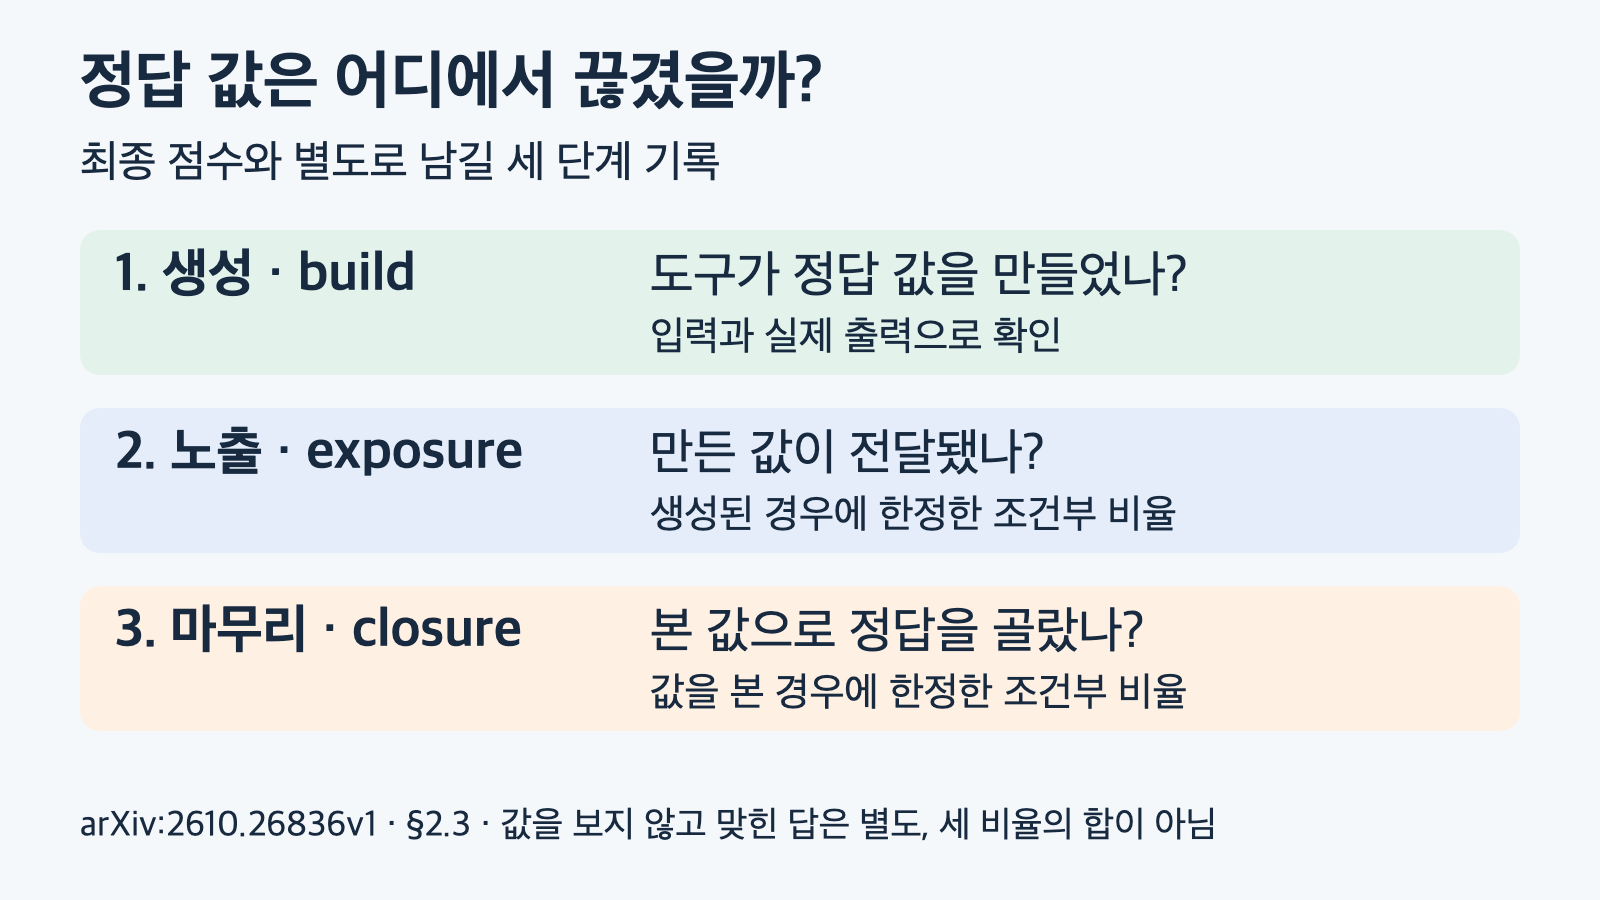
그림 3. 생성·노출·마무리는 서로 다른 실패 지점을 드러낸다. 노출과 마무리는 조건부 비율이며, 세 비율을 더한 값이 전체 정답률은 아니다. 값을 보지 않고 맞힌 답도 별도다. 출처: arxiv.org/html/2610.26836v1.
모델별 최종 점수도 구별해서 읽어야 한다. 158개 검증 문항의 반복 실행을 문항별로 합친 표 1에서 TOC 대비 손실은 GPT-5.1이 11.3퍼센트포인트, GPT-5.2가 7.9퍼센트포인트다. 그러나 다섯 모델에 대한 Holm 다중비교 보정 후 p값은 각각 0.005와 0.128이다. 따라서 두 결과를 모두 보정 후 유의한 차이라고 쓰면 틀린다. 앞 절의 GPT-5.2 고정 재개 실험은 분모와 비교 설계가 다른 별도 결과다.
Claude Opus 4.6, Sonnet 4.6, GPT-5.4의 전체 비교 구간은 0을 포함했다. 이것은 모든 읽기가 똑같이 안전하다는 증명이 아니다. 저자들의 단계별 분석에서는 GPT-5.4가 값을 만드는 쪽의 이득과 근거를 사용하는 쪽의 손실을 함께 보였다. 전체 점수가 비슷해도 오류의 위치는 달라질 수 있다. 이 단계별 기여도 분해는 관찰된 차이를 배분한 것이며, 각 요소를 독립적으로 조작한 인과효과는 아니다.
4. ‘반올림해라’보다 ‘어느 보고서를 읽을까’가 중요했다
저자들은 TOC+Report 조건에서 정식 값이 result.out에 있고 보기의 정밀도로 출력된다는 설명을 시스템·도구 반환에 함께 넣었다. SELECTED_OUTPUT 같은 파생 파일 대신 정식 보고서의 해당 구간을 읽도록 안내한 것이다. 표 5에서 GPT-5.2는 한 번의 TOC 대조 실행 63.3%에서 안내 조건 두 실행의 평균 66.8%로, GPT-5.1은 53.8%에서 61.7%로 올라갔다. 각각 +3.5, +7.9퍼센트포인트다. 초록의 전체 TOC 실행 대비 개선치와 이 단일 대조 실행 대비 개선치를 섞으면 안 된다. 본문 §5, 표 5
반면 파일을 지목하지 않고 반올림 규칙만 설명한 조건에서는 값을 보고 정답을 마무리하는 단계의 손실이 회복되지 않았다. 한도에 들어오는 보고서를 직접 전달하는 Hybrid도 시험한 GPT-5.1·5.2 조건에서는 이 단계의 손실을 줄였다. 그렇다고 모든 종류의 실패가 없어졌거나, 프롬프트 한 줄을 추가하면 어디서나 같은 점수가 오른다는 뜻은 아니다. 정식 파일의 이름과 정밀도 이유를 함께 준 개입이므로 둘 중 어느 부분만의 효과라고도 단정하기 어렵다.
5. 내 도구 출력에서 해 볼 진단: 파일을 없애기 전에 근거를 기록한다
아래 절차는 도구 호출을 감싸는 실행기, 즉 하네스를 설계하는 팀을 위한 편집 제안이다. 정답이 있는 작은 평가 묶음에서 먼저 정식 출력과 파생 출력의 역할을 지정한다. 같은 모델·버전·턴 예산을 유지하고, 가능하다면 같은 계산 이후 지점에서 반환 방식만 바꾼다. 시뮬레이션 입력까지 함께 바꾸면 차이가 근거 선택 때문인지 계산 때문인지 구별하기 어려워진다.
정답 값이 생성되지 않았다면 입력과 계산을, 생성됐지만 전달되지 않았다면 읽기 경로를, 전달됐는데도 오답이라면 선택한 근거와 정밀도를 먼저 점검한다.
| 실제로 확인할 상태 | 다음에 남길 증거 | 먼저 비교할 변경 | 이 증거로 말할 수 없는 것 |
|---|---|---|---|
| 정답 값이 어느 출력에도 없다 | 입력·도구 버전·전체 출력의 해시 | 입력 생성과 계산 조건 | 파일 검색만 고치면 해결된다는 결론 |
| 값은 있지만 에이전트에게 전달되지 않았다 | 반환 본문과 읽은 줄 범위 | 짧은 정식 출력 직접 전달 대 목차·범위 읽기 | 정상 종료만으로 정답을 봤다는 주장 |
| 값을 봤지만 다른 답을 냈다 | 최종 근거 파일·줄·값·단위·자릿수 | 정식 출처 명시 유무와 파생 출력 선택 | 소수 자릿수가 많다는 이유만으로 파일 배제 |
| 전체 점수는 비슷한데 오류가 바뀌었다 | 같은 문항별 생성·노출·최종 선택 기록 | 모델별 단계 변화 | 최종 평균이 같으니 전달 방식도 동등하다는 주장 |
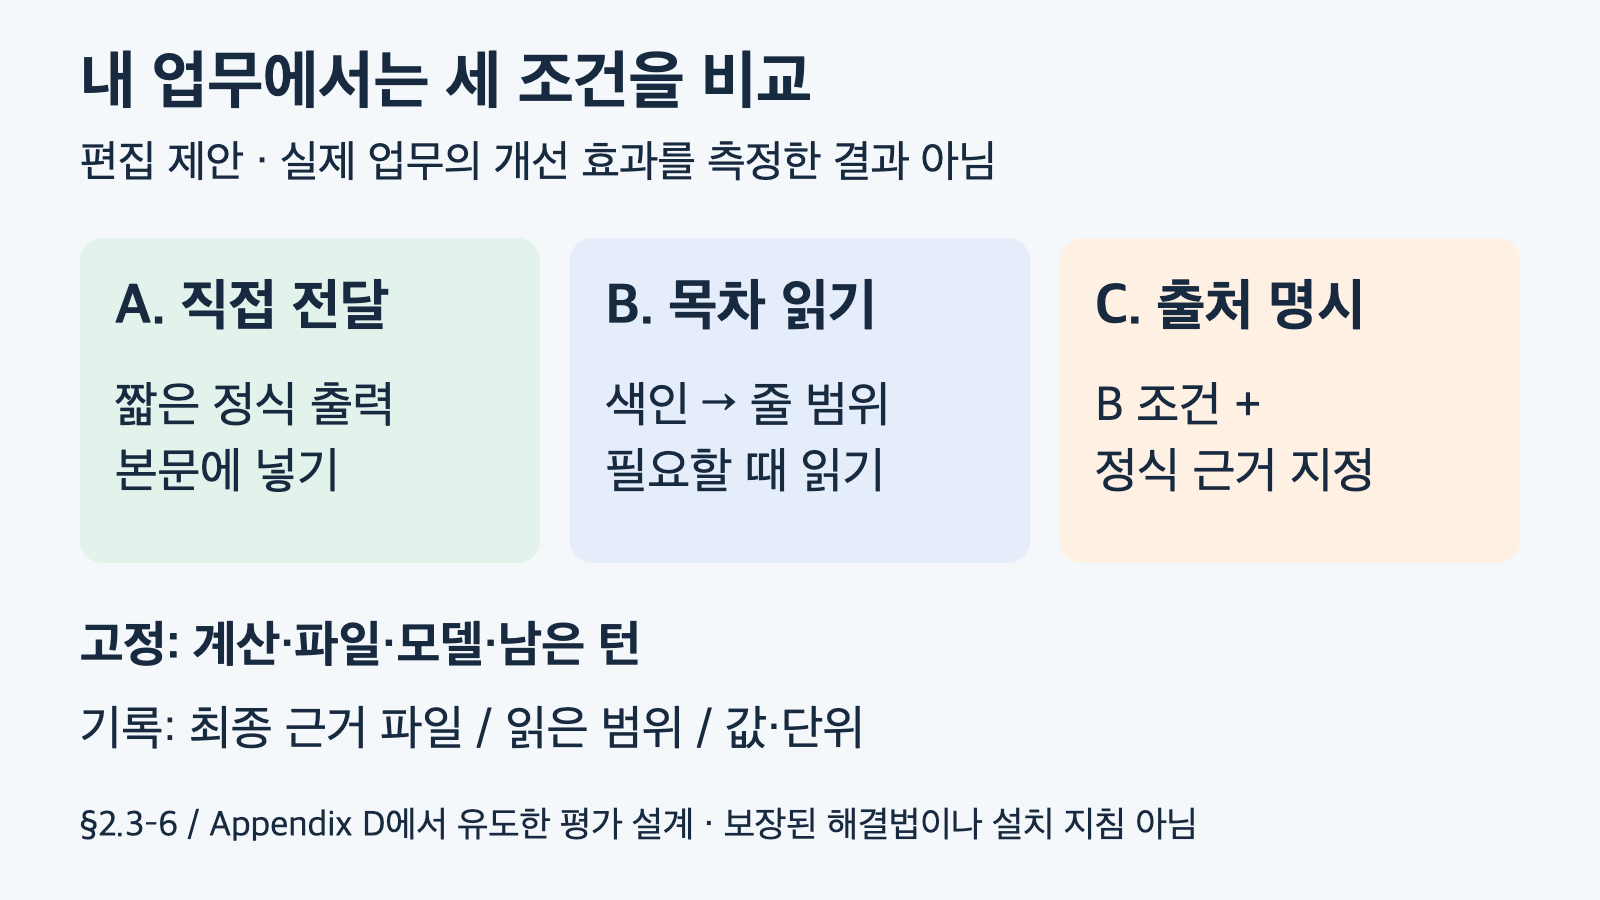
그림 4. 원문에서 유도한 편집 제안이다. 실제 업무의 성능 개선이나 비용 절감을 측정한 도표가 아니며, 최종 근거 파일과 읽은 범위·단위까지 기록하는 비교 설계다. 출처: arxiv.org/html/2610.26836v1.
실험 기록에는 최종 답만이 아니라 선택한 파일 / 읽은 줄 범위 / 원래 표시 값 / 단위 / 보기 변환 규칙을 함께 남기는 편이 좋다. 원본을 읽지 않은 경우도 빈칸으로 숨기지 말고 별도 상태로 기록한다. 파생 파일에 업무상 더 적합한 값이 들어 있다면 그것을 정식 근거로 정의할 수도 있다. 중요한 것은 모델이 편한 파일을 우연히 골랐는지, 평가가 정한 근거를 실제로 읽었는지 구별하는 일이다.
시작할 비교는 세 가지면 충분하다. 정식 보고서의 짧은 본문 직접 전달, 목차를 통한 범위 읽기, 그리고 목차에 정식 근거 파일을 명시한 조건이다. 이것은 성능이 보장된 설치법이 아니라 실패 원인을 나누기 위한 비교 설계다. 토큰 수를 기록하더라도 금전 비용이나 실제 지연 시간을 측정하지 않았다면 절감 효과로 환산하지 않는다. 정답률이 오르더라도 다른 조건의 실패가 늘었다면 그 변화도 함께 남겨야 한다.
이 진단표는 논문의 구분을 실무 평가로 옮긴 편집 제안이며, 실제 업무에서 개선 효과를 측정한 결과가 아니다.
6. 이 연구를 적용하기 전에 남겨 둘 경계
원래 200문항 중 저자들의 실행·정답키·수치 안정성 검사를 거쳐 19개 설정의 158문항이 남았다. 단계별 수치 분석은 그중 숫자 정답 137문항을 쓴다. 일부 문항은 설정을 공유하므로 158개가 모두 독립 시나리오는 아니다. 남은 문항 중에도 기준 입력 설명이 충분하지 않은 24개가 있으며, 이를 뺀 134문항 민감도 분석은 별도로 제시된다. 본문 §2.1, §9; 부록 A
실험은 PHREEQC 3.8.6과 고정 데이터베이스를 쓰고, 숫자 보기의 마지막 자릿수가 답을 가르는 특수한 과제를 다룬다. 모델별 API 설정도 같지 않다. Claude는 온도 0·확장 사고 비활성화, GPT 계열은 API 기본값·별도 추론 강도 미지정이다. 전체 에이전트 조건은 실행 시점도 달랐고, 모든 모델·조건에 동일한 반복 수와 로그가 있는 것은 아니다. 따라서 특정 회사 모델 전체의 일반적 우열로 확대하면 안 된다.
이번 글에서 직접 확인한 범위는 보존된 원문 전체와 표·부록, 이미 고정된 주장 근거, 공개 건수의 산술 검산이다. 에이전트나 PHREEQC를 다시 실행하지 않았다. 원문의 전체 로그 재실행 수 11,007회와 고정 재개 실험의 786회는 서로 다른 집계이며, 이 글에서 수행한 작업 수도 아니다.
결론은 검색을 없애자는 것이 아니다. 긴 도구 결과를 파일로 넘기면 ‘어떻게 찾을까’에 더해 ‘무엇을 정식 근거로 삼을까’라는 선택이 생긴다. 계산의 정상 종료, 정답 값의 생성, 값의 전달, 최종 선택을 구분해야 그 선택의 비용이 보인다.
함께 읽으면 구별되는 문제
- RunningTab: 읽은 근거가 최종 보고서에서 빠지는 이유와 요구사항 장부는 이미 읽은 자료가 긴 보고서에서 빠지는 문제다. 이번 글의 정식·파생 출력 간 근거 선택과는 실패 지점이 다르다.
- OntoAct: 조건부 지식과 고장 가설 갱신은 검색한 수리 지식을 현재 고장 조건에 맞게 적용하는 문제를 다룬다. 파일을 찾았다는 사실만으로 올바른 의사결정이 끝나지 않는다는 관점에서 연결된다.
출처와 검증 범위
- Ke Zhang 외, Same Simulation, Different Evidence: Where Retrieved Tool Output Costs LLM Agents Accuracy — arXiv:2610.26836v1. 최초 제출 2026-10-19 17:57:41 UTC. 이 글은 버전 v1에 고정했다.
- 원문 전체 HTML: §2의 과제·인터페이스·단계 정의, 표 1의 모델별 통합 비교, §4와 부록 D/표 10의 고정 재개, §5/표 5의 개입, §9 및 부록 A–C의 한계·진단 근거.
- 원문 PDF: 그림 1·4의 문항 121 및 14–15쪽의 고정 재개 설계·표 10을 텍스트 추출본과 대조했다. 논문 그림을 복제하지 않고 수치·관계를 바탕으로 설명용 도식을 새로 제작했다.
AI를 활용해 공개 자료를 분석한 해설이다. 본문 진단표와 도식은 편집 분석이며, 논문 저자의 실험 결과와 독립 재현 결과를 혼동하지 않도록 구분했다.


댓글
댓글 쓰기