실패를 지침으로 바꾸기 전: GEPA-Curator의 같은 과제 성공 대조와 학습 보류
쇼핑 에이전트가 구매에 실패했다. 필수 옵션을 선택하지 않았다면 “장바구니에 넣기 전에 필수 항목을 확인하라”는 지침이 도움이 될 수 있다. 그런데 구매 버튼 자체가 잠시 고장 났다면 어떨까. 같은 실패 표시만 보고 “다른 경로로 구매하라”는 규칙을 추가하면, 정상으로 돌아온 환경에서도 불필요한 우회를 하게 만들 수 있다. 논문 도입부가 든 두 상황은 실패 여부와 실패 원인이 다르다는 점을 보여준다.
GEPA-Curator가 던지는 질문은 “실패를 얼마나 많이 모았나”보다 좁다. 지금 이 과제를 다시 실행하면 프롬프트를 개선할 만한 정보를 얻을 수 있는가? 실패를 해석할 때 같은 과제에서 과거에 실제로 성공했던 실행을 믿을 만한 대조군으로 쓸 수 있는가? 이 글은 그 두 판단을 분리하고, 성공 기록이 없을 때 무엇을 보류하는지까지 정리한다.
대상은 2026년 10월 27일자 arXiv v1 사전 논문이다. PDF에는 Under Review라고 적혀 있다. 여기서 ‘학습’은 모델 가중치를 다시 훈련한다는 뜻이 아니라, 실행 경험으로 텍스트 프롬프트를 바꾸는 최적화를 가리킨다. 아래 수치는 저자 보고값이며 독립 재현 결과가 아니다.
1. 과제 선별과 성공 대조는 서로 다른 스위치다
Curator는 과제별 실행 궤적과 평가 결과를 이력으로 유지한다. 첫 번째 역할인 task curation은 다음 최적화 미니배치에 넣을 과제를 고르는 것이다. 이력이 부족한 과제는 탐색을 우선하고, 반복해서 안정적으로 성공하거나 프롬프트 밖의 원인으로 계속 실패하거나 비슷한 결과에 평가가 엇갈리는 과제는 추가 실행의 정보 가치가 낮다고 판단해 잠시 건너뛸 수 있다. 이는 환경 장애를 고치는 기능도, 실행 권한을 새로 주는 기능도 아니다. (§3.1)
두 번째 역할인 prior success retrieval은 Reflector에게 줄 보조 자료를 고른다. 현재 실패와 비교할 대상은 ‘비슷한 다른 과제’가 아니라 같은 과제의 과거 성공이다. Curator는 평가 근거가 일관된 성공 궤적 하나를 고르도록 지시받는다. 성공처럼 보이지만 다른 관찰과 충돌하거나 애매한 결과는 피한다. 적절한 성공이 없으면 이 메타데이터를 제공하지 않는다. (§3.2)
같은 과제의 성공이 없거나 판정이 의심스러우면 성공 예시 제공만 포기한다. 이것이 곧 과제 실행 전체를 중단한다는 뜻은 아니다. ‘과제 건너뛰기’와 ‘성공 대조 자료 제공 보류’를 하나의 차단 조건으로 합치면 논문의 메커니즘을 잘못 옮기게 된다. 두 판단은 하나의 Curator 호출에서 함께 이뤄지지만 출력의 역할은 다르다.
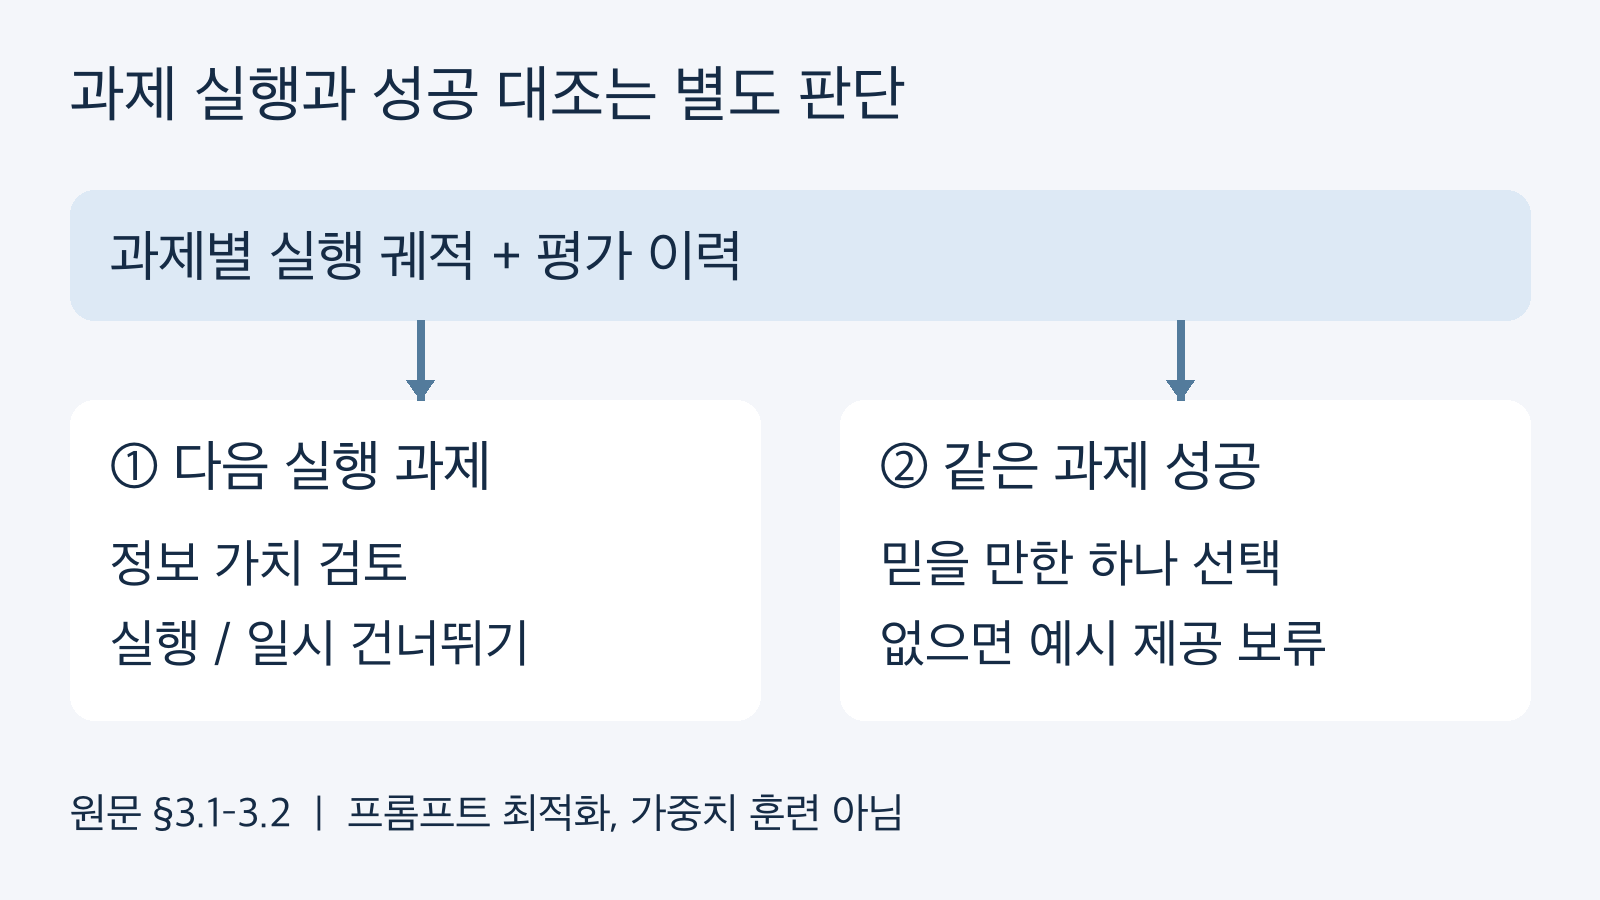
같은 이력을 보지만 출력은 둘이다. 성공 예시가 없어도 과제 실행 후보에서 반드시 빠지는 것은 아니다. §3.1–3.2를 직접 재구성했다. 출처: arxiv.org/abs/2610.37651v1.
예를 들어 같은 구매 과제에서 이전 성공은 옵션 선택 후 구매했고, 현재 실패는 옵션을 빠뜨렸다면 Reflector에게 구체적인 비교 근거가 생긴다. 반대로 성공 판정만 있고 주문 완료를 뒷받침하는 관찰이 서로 충돌한다면, 그것을 정답 경로처럼 전달하지 않는 쪽이 논문의 취지에 맞다. 후자의 주문 완료 확인 예시는 편집 설명이며, 별도 서비스 실험을 수행했다는 뜻은 아니다.
2. 운영 로그를 읽을 때 쓸 수 있는 판단표
아래 판단표는 논문의 메커니즘을 운영 상황에 옮긴 편집 분석이며, 실제 서비스에서 측정한 개선 효과나 자동 복구 기능이 아니다. 특히 ‘보류’는 운영 중 장애를 방치하라는 지시가 아니다. 장애 대응과, 그 장애를 새 프롬프트 규칙의 근거로 삼는 일은 따로 다뤄야 한다.
| 관찰한 이력 | 과제 실행 후보 판단 | 성공 대조 자료 판단 | 다음에 남길 근거 |
|---|---|---|---|
| 같은 과제에 믿을 만한 성공과 현재 실패가 함께 있음 | 재실행이 유익한지 이력을 검토 | 신뢰할 성공 하나를 대조 자료로 선택 가능 | 성공·실패 궤적과 평가 차이 |
| 실행 이력이 아직 적음 | 탐색 우선 후보 | 적절한 성공이 없으면 제공 보류 | 과제별 실행·평가 이력 |
| 같은 외부 장애로 반복 실패함 | 정보 가치가 낮으면 일시 건너뛰기 후보 | 장애를 정상 성공처럼 포장하지 않음 | 장애 관찰과 판정 이유 |
| 비슷한 결과에 성공·실패 평가가 엇갈림 | 잡음 가능성을 검토 | 모순된 성공을 신뢰 기준으로 쓰지 않음 | 결과와 평가의 불일치 |
| 여러 번 안정적으로 성공함 | 추가 실행의 효용이 낮으면 잠시 제외 가능 | 성공 자료가 있어도 실행 선별과 별도 판단 | 다음 epoch 재검토 대상 |
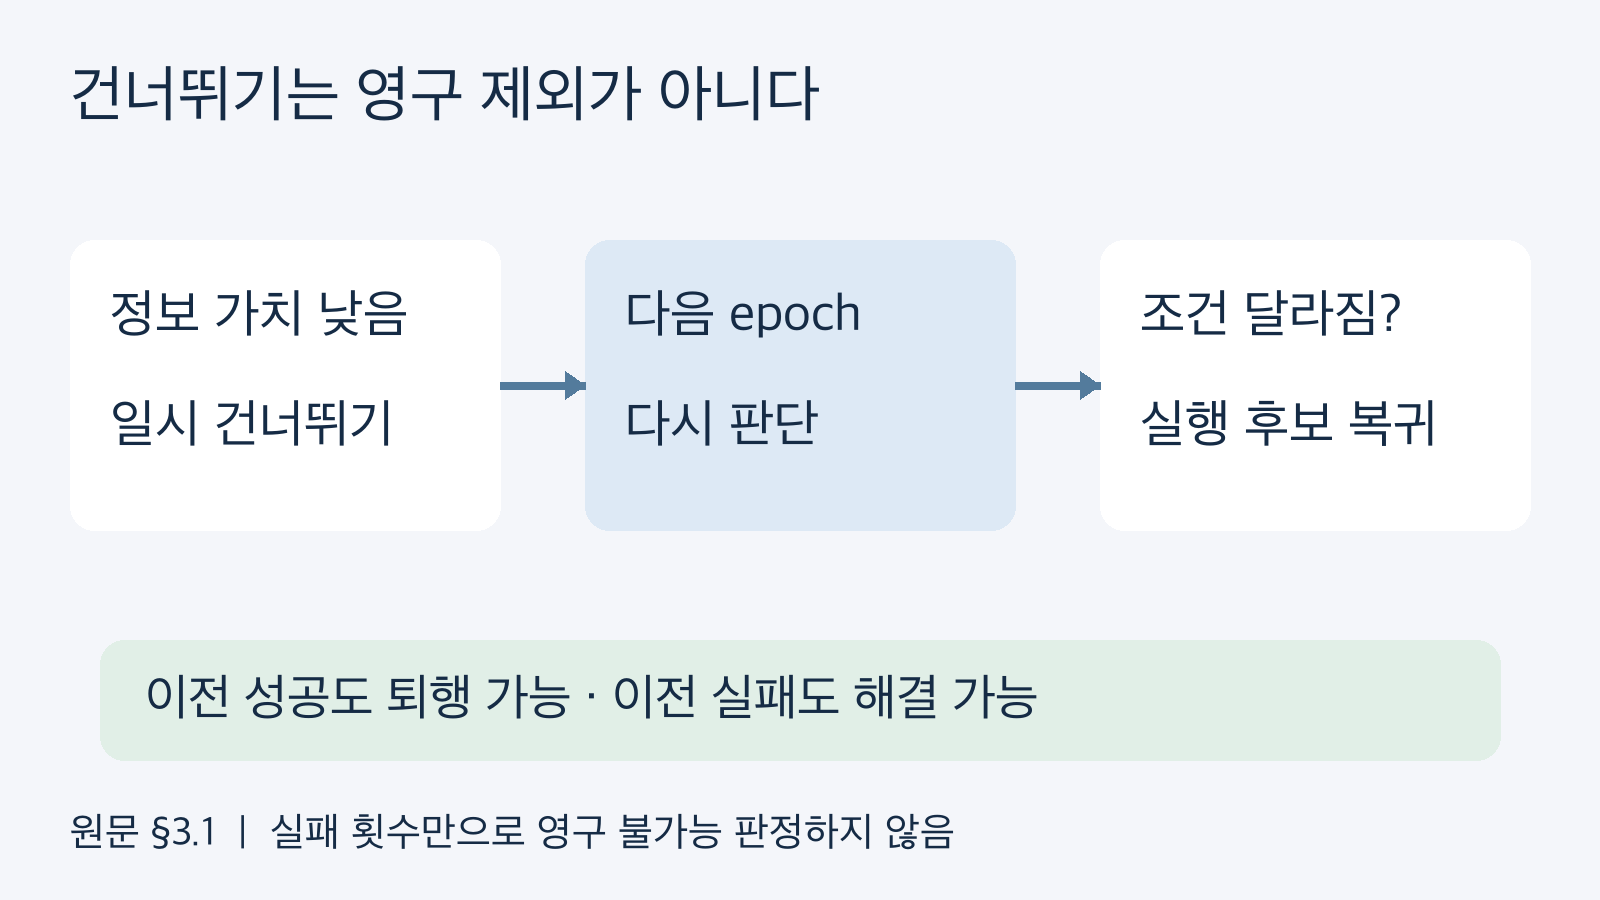
다른 과제에 맞춘 프롬프트 수정으로 성공 과제가 퇴행하거나 어려운 과제가 풀릴 수 있어 매 epoch 재검토한다. §3.1의 흐름을 직접 구성했다. 출처: arxiv.org/abs/2610.37651v1.
중요한 안전장치는 영구 제외가 아니라 재방문이다. 논문은 건너뛴 과제를 매 epoch마다 다시 고려한다고 명시한다. 다른 과제에 맞춰 프롬프트를 고치면 이미 풀던 과제가 퇴행할 수 있고, 예전에는 어렵던 과제가 새 지침으로 풀릴 수도 있기 때문이다. “한 번 실패했으니 불가능”, “한 번 성공했으니 영원히 완료”라는 고정 분류와는 다르다.
이 표를 자체 로그 검토에 적용한다면, 적어도 과제 식별자와 실행 궤적, 평가 근거, 대조 자료 제공 여부, 건너뛴 이유를 분리해 남기는 편이 낫다. 이는 편집 제안이지 논문이 입증한 필수 운영 스키마가 아니다. 단순 성공률 하나로는 ‘실행은 다시 하되 성공 예시는 붙이지 않는’ 상태를 표현하기 어렵다는 것이 핵심이다.
3. 성과는 좋아졌지만, 분모와 설정을 함께 봐야 한다
ALFWorld에서 Gemini 3.1 Pro Preview를 최적화 모델로 쓴 결과는 GEPA 82.4±2.9%, GEPA-Curator 91.8±1.4%였다. 실행 에이전트는 gpt-oss-120b이며, 학습 과제 150개와 검증 과제 50개, 학습 rollout 예산 2,000회, valid_unseen 평가 과제 134개라는 설정이다. 값은 5회 반복의 평균과 표준편차다. 134는 서로 다른 평가 과제 수이지 성공 횟수가 아니며, 평균 성공률에서 정수 성공 건수를 역산하면 안 된다. ±는 신뢰구간이 아니다. (§4.1, Table 2)
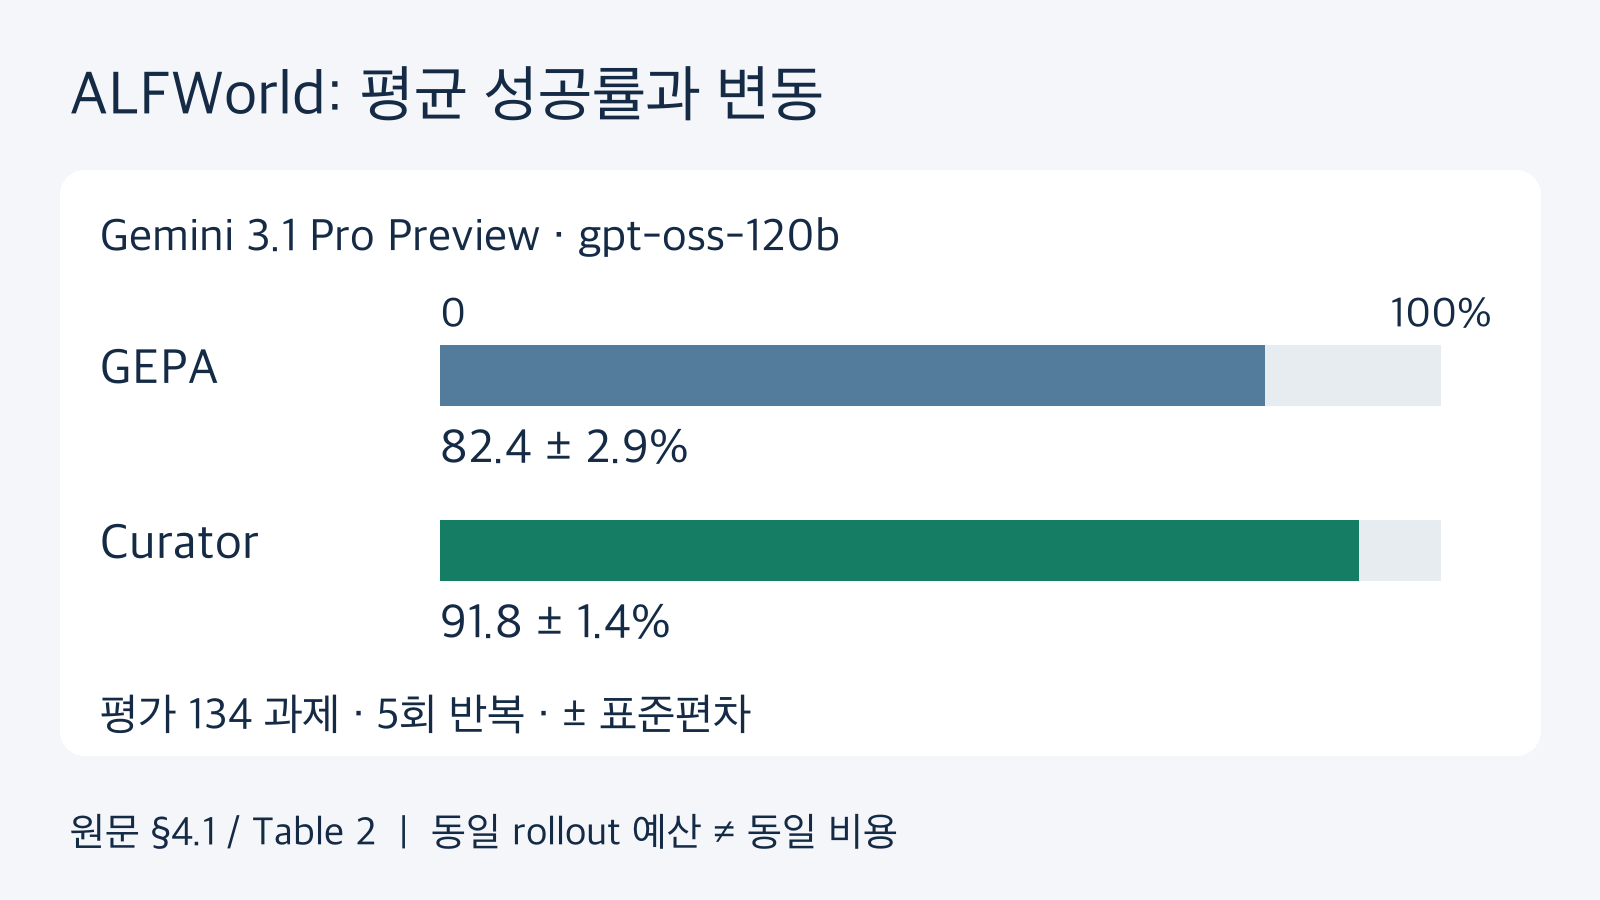
Table 2의 ALFWorld Gemini 설정. 5회 평균±표준편차이며 신뢰구간이 아니다. 평가 과제는 134개, 실행 에이전트는 gpt-oss-120b다. 막대는 0–100% 공통 축을 사용한다. 출처: arxiv.org/abs/2610.37651v1.
GoBrowse의 네 사이트를 합친 저자 보고 집계도 Gemini 설정에서 GEPA 78.7% 대 Curator 82.1%, Opus 5 설정에서 79.5% 대 84.5%였다. 사이트별 원래 과제 풀은 GitLab 720개, Shopping 585개, Shopping Admin 750개, Reddit 585개이며 각각 3:1:1로 분할했다. 사이트·방법별 rollout은 5,000회, 결과는 5회 반복 평균이다. 정확한 분할 행 목록을 확보한 것은 아니므로 여기서 새 평가 건수나 통합 성공 건수를 만들어내지는 않는다. 서로 다른 최적화 모델의 값을 하나의 실험처럼 평균내지도 않는다. (Table 1)
“Curator만 붙이면 그만큼 오른다”는 인과 해석도 과하다. 본 실험의 GEPA-Curator는 GEPA의 Pareto 기반 후보 선택을 없앤 단일 계보의 greedy 변형을 사용한다. 별도 GitLab ablation은 학습 520개와 검증 200개, 5회 평가에서 GEPA 82.8%, 과제 선별만 84.2%, 과거 성공 대조만 84.7%, 전체 구성 88.6%를 보고했다. 두 구성 요소의 기여를 살펴보는 자료지만, 본 실험의 held-out test와 같은 분모가 아니며 전체 구성과 기준선의 차이를 모두 Curator 하나의 순수 효과로 돌릴 수 없다. (§4.3, Table 3)
4. 성공 대조가 없는 설정에서는 내려간 결과도 있다
Appendix E의 HotpotQA에서는 GEPA 66.3%, Curator 65.0%로 오히려 낮았다. 이 실험은 실행 에이전트가 Qwen3-8B이고, 최적화 모델은 Gemini 3.1 Pro Preview다. 학습 150개, 검증 300개, 테스트 300개이며, 과제 선별만 적용하고 선택한 성공 자료는 사용하지 않았다. 과제별 이력도 최근 10개만 유지했다. 따라서 앞의 ALFWorld 전체 구성과 같은 방법·모델 조합이라고 해석할 수 없다. 동시에 ‘어떤 벤치마크에서도 개선된다’는 주장에 반례가 된다는 점은 남는다. (Table 16)
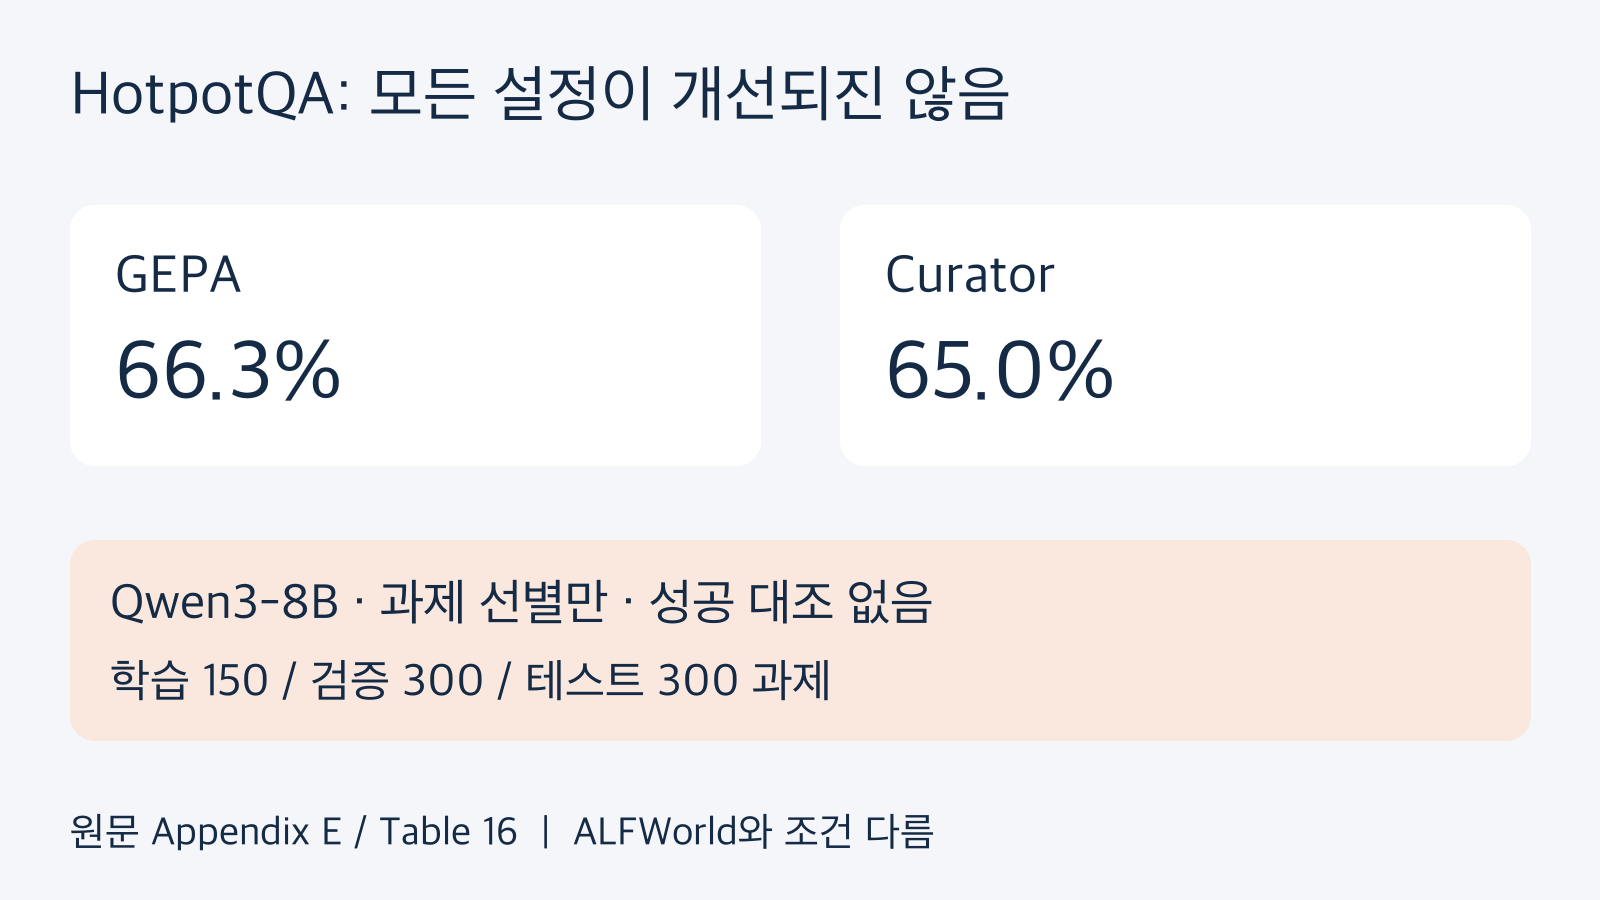
Appendix E Table 16의 반례. Qwen3-8B와 Gemini 3.1 Pro Preview를 사용하고 성공 대조 없이 과제 선별만 적용했다. ALFWorld 전체 구성과 동일 조건이 아니다. 출처: arxiv.org/abs/2610.37651v1.
비용도 별도다. 같은 rollout 수를 썼다는 것은 같은 토큰·시간·금액을 썼다는 뜻이 아니다. Curator 판단과 반성 작업이 추가된다. Appendix D Table 15의 비용 추정은 효율 최적화 변형을 대상으로 하므로, 기본 Table 1–2의 성능과 이어 붙여 하나의 비용 대비 성능 비교로 만들지 않았다. 이 글은 최신 API 요금이나 보편적인 비용 절감을 주장하지 않는다.
재현·도입 측면에서도 선을 그어야 한다. 이번 근거 묶음에서 GEPA-Curator 전용 실행 패키지와 원시 결과 번들을 확보한 것은 아니다. 실제 서비스를 설치해 검증했다거나, 그대로 붙이면 장애 원인을 자동 판별한다고 소개할 근거는 없다. Curator의 판단 자체도 틀릴 수 있다.
5. 적용할 원칙은 ‘실패 삭제’가 아니라 ‘근거 분리’다
이 논문에서 가져올 실용적인 관점은 실패를 지우는 일이 아니다. 같은 과제의 과거 성공을 믿을 만한 비교 대상으로 줄 수 있는지, 지금 한 번 더 실행하는 것이 프롬프트 수정에 유익한지를 별도로 판단하는 일이다. 성공 근거가 없으면 비교 예시를 비워 두고, 현재 학습 가치가 낮으면 잠시 건너뛰되 다음 epoch에서 다시 본다. 환경 장애에 대한 운영 조치는 그와 별도다.
관련 글과의 차이도 여기에 있다. Ecdysis의 실패 묶음과 하네스 수정은 여러 과제의 실패 패턴을 모아 코드를 바꾸는 관점이다. WikiSkill의 기억 계층 분리는 기록과 스킬 반영 사이를 나누는 관점이다. 이번 글의 초점은 그보다 앞에서, 같은 과제의 성공 대조를 제공할지와 어떤 과제를 다시 최적화에 넣을지를 가르는 데 있다.
실패에서 배운다는 말은 실패를 곧바로 지침으로 바꾼다는 뜻이 아니다. 믿을 만한 같은 과제의 성공이 있으면 대조하고, 없으면 성공 근거를 지어내지 않는 것. 그리고 보류한 과제를 영구 포기하지 않는 것. 이것이 보고된 성능 수치보다 먼저 이해해야 할 GEPA-Curator의 설계다.
출처와 검토 범위
- GEPA-Curator: Curated Learning for Self Improving Agents, arXiv:2610.37651v1: §1의 구매 실패 예시, §3.1–3.2의 선별·성공 대조·보류, §4.1–4.3의 실험 설정과 Tables 1–3.
- 같은 버전 PDF: Appendix D Table 15의 효율 변형 비용 경계, Appendix E Table 16의 HotpotQA 반례.
- 검토는 고정 버전 원문과 보존된 추출문을 대조한 출처 기반 편집 분석이다. 자체 모델 실행, 독립 재현, 실제 서비스 개선 측정은 수행하지 않았다. 그림은 논문의 도판을 복사한 것이 아니라 해당 설명과 수치를 바탕으로 직접 구성했다.


댓글
댓글 쓰기