ScholarCatalyst: 비슷한 논문보다 연구를 바꿀 논문을 찾으려면
논문 검색 도구가 익숙한 키워드를 가진 문헌을 수십 편 내놓았는데도 연구 방향은 그대로인 경우가 있다. 결과 목록이 주제에 맞는다는 것과, 그중에 다음 실험을 바꿀 아이디어가 있다는 것은 다른 조건이다. 연구 에이전트에 검색 반복과 요약 단계를 더 붙이기 전에 이 차이를 측정할 필요가 있다.
ScholarCatalyst는 바로 이 차이를 평가하려는 벤치마크다. 완성된 프로젝트의 저자에게 당시 질문과 도움이 되었거나 될 수 있었던 선행 논문을 확인받고, 시스템이 그 논문을 찾아오는지 본다. 논문 작성이나 연구 프로젝트 완주 능력을 평가하는 과제가 아니다. 이 글은 2026년 10월 1일 제출된 arXiv v1 프리프린트의 본문·표·부록과 고정된 공개 평가 코드를 읽은 해설이다. 이 연구 자체의 동료심사 통과는 확인하지 않았다.
핵심 메시지는 “에이전트는 쓸모없다”가 아니다. 검색 과정에 필요한 논문이 한 번도 들어오지 않았다면, 최종 답변을 더 그럴듯하게 쓰는 것만으로는 그 논문을 선택할 수 없다는 점이다. 아래에서는 결과 수치와 그 경계를 먼저 읽고, 내 검색 도구의 실패를 나눠 보는 진단표를 제안한다.
평가 정답을 바꾸면 검색의 의미도 달라진다
일반적인 문헌 검색에서 우리는 주제 유사성, 인용 관계, 질문에 대한 직접적인 답을 단서로 삼는다. ScholarCatalyst의 정답은 더 좁고 개인적인 판단이다. 해당 프로젝트의 저자가 그 논문의 아이디어를 연구 진전에 도움이 된다고 보았는지다. 같은 분야의 논문이라도 저자가 도움이 되지 않는다고 판단하면 어려운 음성 사례인 hard negative가 된다. 반대로 표면적 주제가 달라도 방법을 옮기거나, 한계를 발견하거나, 새로운 관점을 얻는 데 도움이 될 수 있다.
저자들은 이를 회고적으로 수집한다. 자동 생성된 질문과 후보 목록을 연구자가 검토하고 수정하며, 각 후보의 관련성과 이유를 확인한다. 따라서 “연구가 시작될 때의 질문”은 실제 당시의 일지를 그대로 가져온 것이라고 단정하면 안 된다. 완료된 프로젝트를 아는 저자의 회고가 개입하며, 논문도 hindsight를 한계로 인정한다.
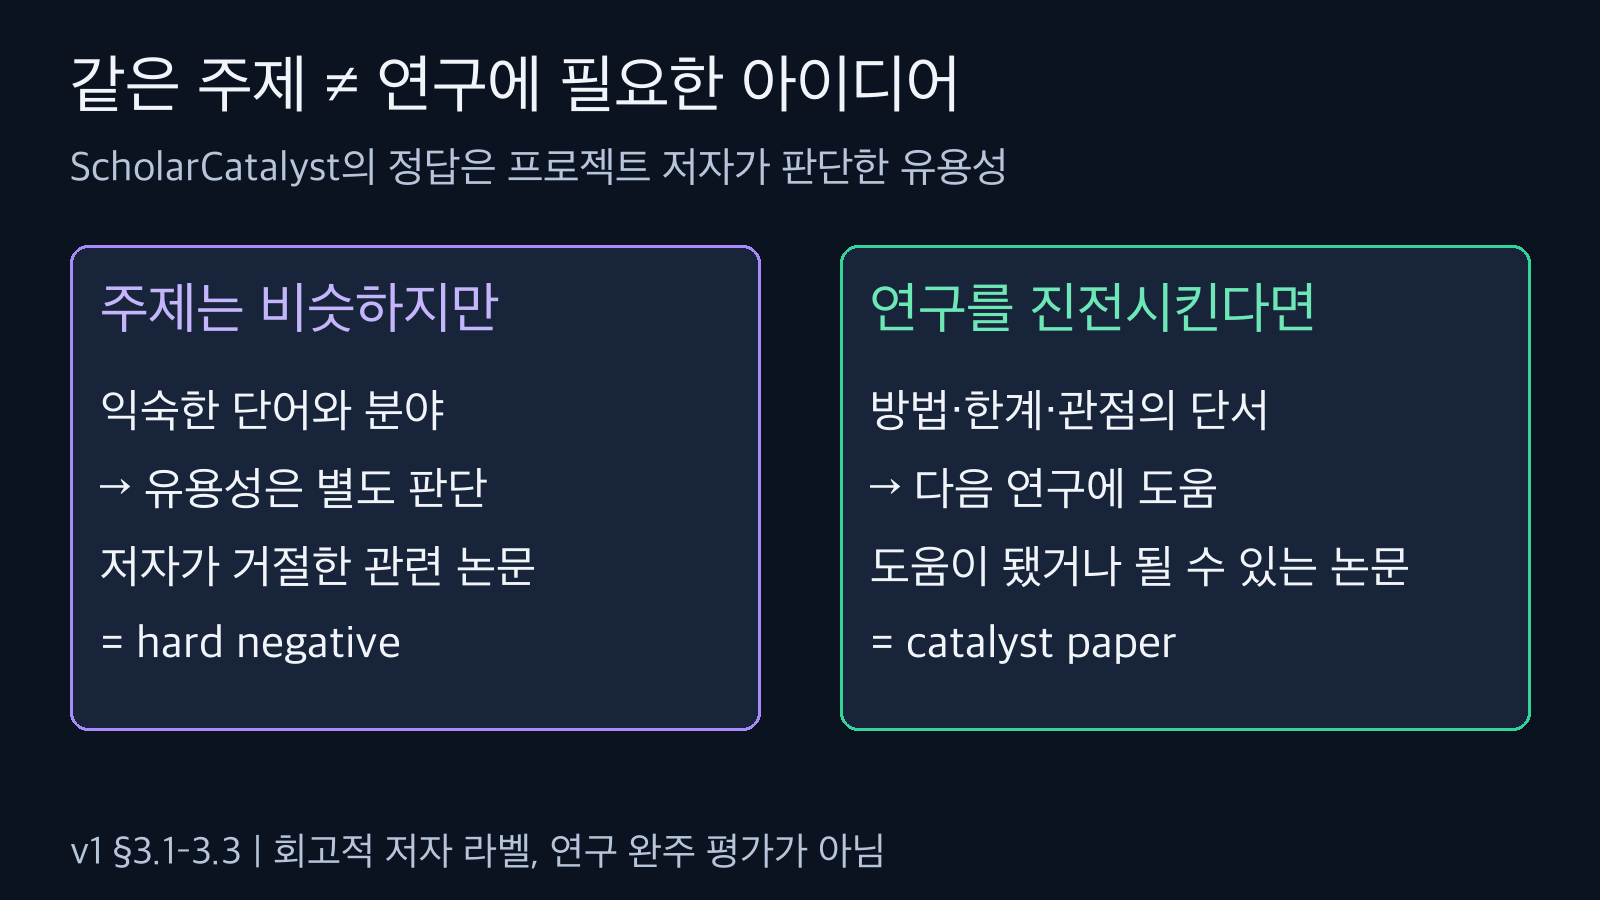
그림 1. 주제가 비슷한 것과 프로젝트에 유용한 것은 별도 판단이다. 정답은 저자의 회고적 검토에 근거하며 연구 완주 능력을 뜻하지 않는다. 출처: arxiv.org/html/2610.02202v1#S3.SS1.
표본 단위도 구분해야 한다. 연구자 184명이 제공한 프로젝트는 207개이고, 질의는 894개다. 프로젝트의 중심 질문인 CoreQ가 207개, 특정 하위 분야 관점의 질문인 SubQ가 687개다. 프로젝트 하나에서 여러 SubQ가 나온다. 894개의 서로 독립적인 연구 프로젝트를 실험했다고 읽으면 잘못이다. 고정 공개 질의 파일의 개수는 소스 수집 단계에서 대조했으며, 184명이라는 인원은 저자 보고 수치다.
전체 검색 코퍼스는 190,896편이다. 각 질의에는 원 프로젝트 논문의 출판 시점을 기준으로 이후 논문을 제외한 코퍼스를 사용한다. 이 필터는 선행 문헌을 근사하려는 장치이지 실제 프로젝트 시작일을 정확히 복원한 것은 아니다. 또한 코퍼스 전체 수와 각 질의가 검색한 문헌 수를 같은 숫자로 취급해서는 안 된다.
0.51은 정답률도, 상위 20편의 정확도도 아니다
주요 지표인 Recall@20은 한 질의의 정답 논문 중 상위 20개 결과에 들어온 논문의 비율이다. 이를 질의별로 계산하고 해당 유형의 질의에 대해 평균낸다. 분모는 반환한 20편이 아니라 저자가 지정한 정답 논문 수다. 그러므로 0.51을 “질문의 51%를 해결했다”거나 “추천한 20편 중 51%가 유용했다”라고 바꾸면 안 된다. 공개 코드의 recall_at_k 함수와 평가 평균 처리도 이 구분을 확인해 준다.
아래는 Table 3의 동일 지표를 질의 유형별로 옮긴 것이다. 모두 논문이 보고한 결과이며 이 글에서 모델을 재실행하지 않았다.
| 시스템 | CoreQ Recall@20 (207질의) | SubQ Recall@20 (687질의) |
|---|---|---|
| Qwen3-Embedding-8B | 0.37 | 0.51 |
| GPT-4.1 도구 호출 에이전트 | 0.37 | 0.43 |
| o3 딥 리서치 에이전트 | 0.33 | 0.38 |
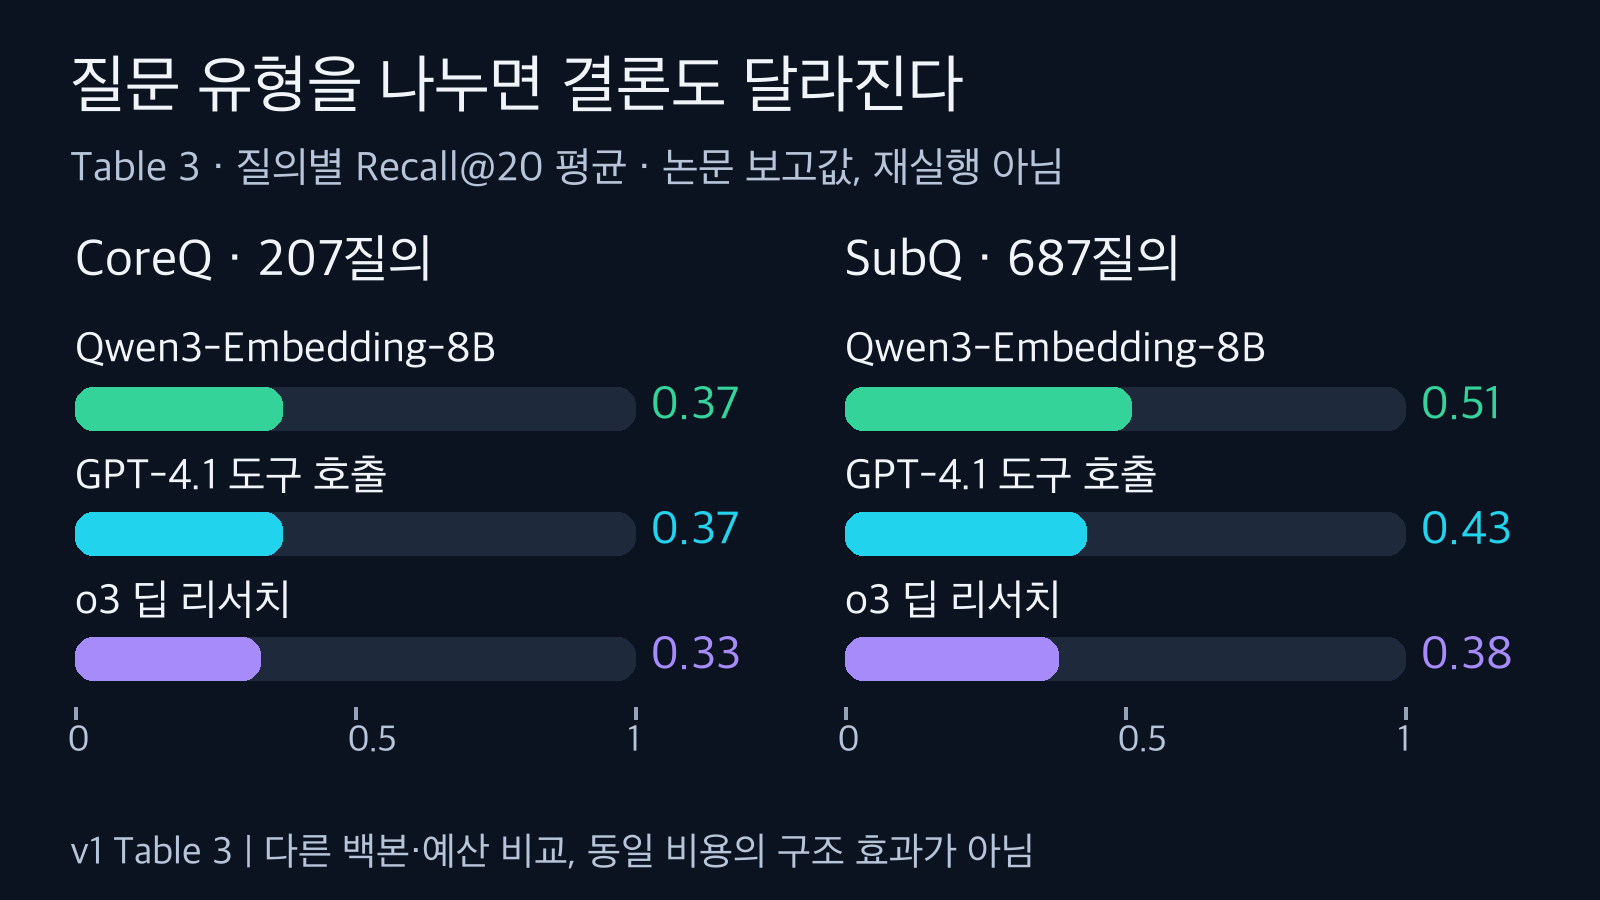
그림 2. Table 3의 질의별 Recall@20 평균을 다시 그렸다. CoreQ는 207질의, SubQ는 687질의다. 논문 보고값이며 독립 재실행이나 동일 비용의 구조 효과 측정이 아니다. 출처: arxiv.org/html/2610.02202v1#S4.T3.
SubQ에서는 이 임베딩 모델의 보고값이 비교한 두 에이전트보다 높다. 그러나 CoreQ에서는 Qwen3-Embedding-8B와 GPT-4.1 도구 호출 에이전트가 같은 0.37이다. 질문 유형을 지우고 “임베딩이 언제나 더 낫다”고 결론내릴 수 없다. 두 유형을 한데 모은 초록의 요약값을 특정 모델·유형의 결과인 것처럼 쓰는 것도 피해야 한다.
에이전트가 사용하는 검색 도구의 임베딩 모델은 Gemini Embedding 2다. 따라서 위 비교는 Qwen 모델에 반복 루프만 붙여 얻은 변화량이 아니다. 백본과 검색 모델, 예산이 함께 달라진 시스템 비교이며, 동일 비용으로 에이전트 구조 하나의 효과를 분리한 실험도 아니다. 표시값은 소수 둘째 자리까지 반올림되어 있으므로 정확한 회수 논문 총수를 역산하지 않았다.
이름이 같은 딥 리서치라도 실행 조건을 확인한다
주 실험은 시점 필터를 적용한 로컬 코퍼스 검색이다. 웹 검색을 금지하고 원 프로젝트 논문을 제공하지 않으며, 에이전트가 읽는 정보는 후보 논문의 제목과 초록이다. 현재 상용 웹 기반 딥 리서치 서비스 전체의 성능이나 논문 전문을 읽는 작업까지 평가한 결과가 아니다. 이후 지식 컷오프 모델의 행은 별도 비교용이므로 주 실험과 섞어 최고 성능을 홍보해서도 안 된다.
부록 C.3에 따르면 도구 호출 에이전트는 원 질의를 먼저 검색한 뒤 최대 5라운드를 수행하고 후보 풀은 최대 60편이다. 한 라운드 안에 여러 검색 호출이 가능하므로 “검색을 최대 5번 한다”는 설명은 틀리다. 딥 리서치 에이전트는 최대 6개 하위 질문, 20회 검색, 10회 읽기, 후보 풀 최대 150편이라는 상한을 갖는다. 여기서 읽기도 제목과 초록을 반환하는 동작이다. 이 숫자는 구성상 상한이지 평균 호출 횟수나 실제 비용이 아니다.
순위 목록을 채우는 규칙도 점수의 일부다. 연구진은 에이전트의 자체 순위 뒤에 검색 중 보았지만 순위에 넣지 않은 논문을 최대 25편 추가하고, 이후 원 질의 검색 결과로 깊이 100까지 채운다. 자체 순위가 20편보다 짧은 사례는 도구 호출 10개, 딥 리서치 95개 질의이며, 각각의 분모는 CoreQ와 SubQ를 합친 894개다. 이런 경우에는 Recall@20에도 보충 결과가 영향을 줄 수 있다. 이 횟수를 실패율로 부르거나 SubQ만의 개수로 바꾸지 않는다.
후보 회수와 최종 선택을 분리하는 진단 절차
연구진의 후보 회수 분석을 실제 도구 점검에 옮겨 보면 두 지점을 나눌 수 있다. 하나는 정답 논문이 검색 도중 후보 풀에 들어왔는지이고, 다른 하나는 그중 무엇을 최종 목록에 남겼는지다. 정답 논문이 후보 풀에 없으면 검색 경로를, 후보 풀에는 있는데 최종 목록에 없으면 선택 기준을 먼저 점검한다.
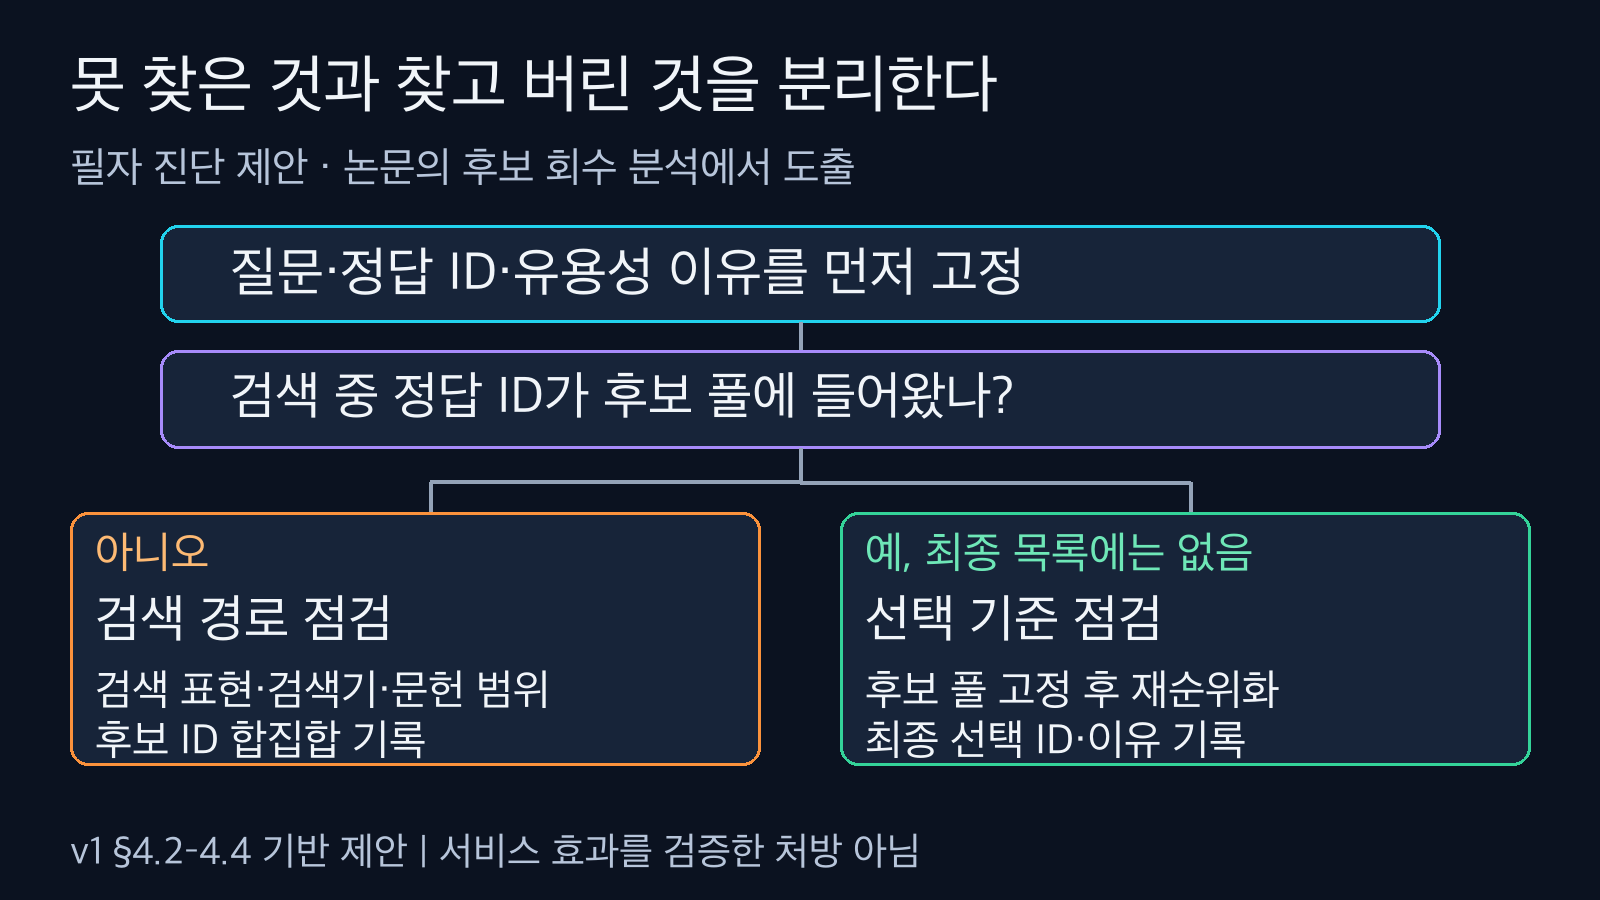
그림 3. 후보 회수 실패와 후보 선택 실패를 분리하는 필자의 운영 제안이다. 최종 목록에서 빠진 정답을 진단하는 흐름이며 실제 서비스 개선 효과를 측정한 절차는 아니다. 출처: arxiv.org/html/2610.02202v1#S4.SS4.
내 도구를 점검할 때는 이미 유용한 선행 문헌을 알고 있는 프로젝트에서 시작할 수 있다. 질문과 정답 논문의 ID, 도움이 된 이유를 먼저 고정한다. 예컨대 이유를 “같은 키워드가 있다” 대신 “내 실험에서 바꿔 볼 수 있는 가정을 제시한다”로 적으면, 단순 유사성과 행동 가능한 아이디어를 구분하기 쉽다. 가능하다면 초기 질문을 작성한 사람과 최종 유용성 평가자를 나눠 회고적 편향도 드러낸다.
실행 로그에는 최종 답변만 남기지 말고 각 검색의 질의, 반환한 논문 ID, 읽은 후보, 최종 선택 ID를 남긴다. 제목만으로 묶으면 동명이거나 버전이 다른 문헌을 혼동할 수 있다. 검색 중 만난 ID의 합집합과 최종 목록을 분리하면 “찾았지만 버렸다”와 “아예 못 찾았다”를 같은 실패로 뭉뚱그리지 않게 된다.
| 관찰한 증상 | 먼저 확인할 기록 | 다음에 비교할 변경 |
|---|---|---|
| 유용한 논문이 후보 풀에 없다 | 검색 질의별 후보 ID와 시점 필터 | 같은 예산에서 검색 표현·검색기·문헌 범위를 하나씩 변경 |
| 후보 풀에는 있지만 최종 목록에 없다 | 후보의 유용성 이유와 최종 선택 ID | 후보 풀을 고정하고 선택 기준 또는 재순위화만 변경 |
| 최종 목록에는 있지만 근거가 빈약하다 | 선택 이유가 가리키는 본문·초록 구절 | 검색 개선으로 오인하지 말고 설명의 근거를 별도 평가 |
| 반복해도 새 유용 후보가 들어오지 않는다 | 라운드별 새로운 후보 ID | 반복 횟수만 늘리는 대신 검색 경로 변화의 이득을 비교 |
이 진단표는 논문의 후보 회수 분석에서 도출한 운영 제안이며, 실제 검색 서비스에서 효과를 검증한 배포 처방은 아니다. 정답 집합 자체가 불완전할 수 있으므로 목록 밖의 새 발견을 곧바로 오답으로 버리지 말고 별도의 전문가 검토 대상으로 보존해야 한다. 후보 회수율을 올렸다고 연구 성과가 자동으로 향상되는 것도 아니다.
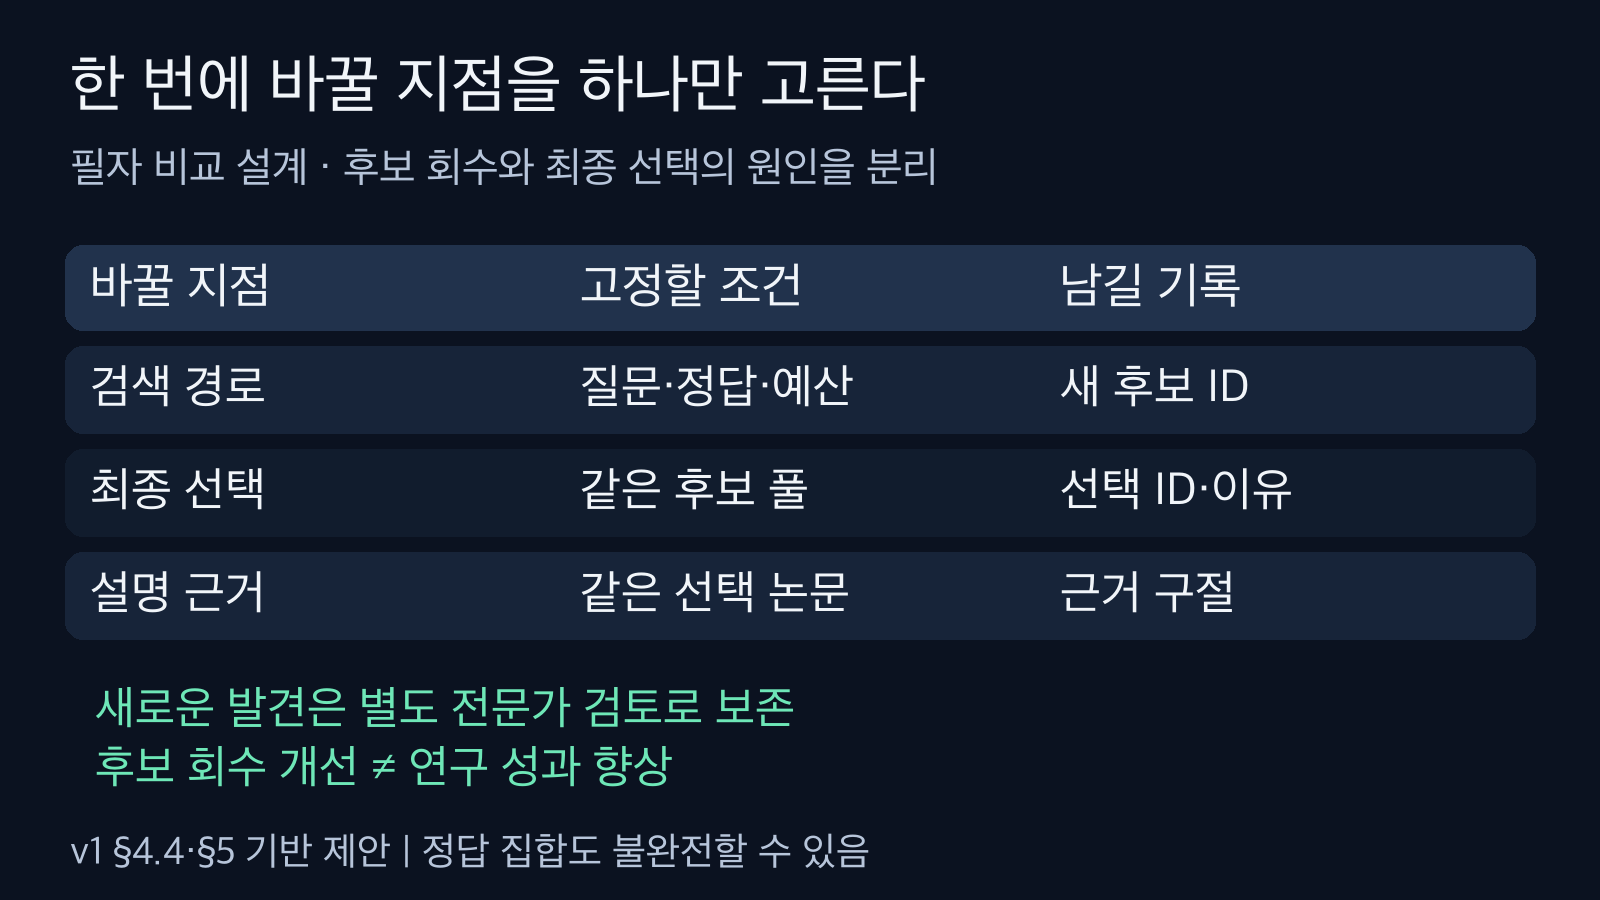
그림 4. 한 번에 변경할 지점을 나누기 위한 필자의 비교 설계다. 정답 집합 밖의 발견은 전문가 검토로 남기며 후보 회수 개선을 연구 성과 향상으로 해석하지 않는다. 출처: arxiv.org/html/2610.02202v1#S5.
이 구분은 비용 통제에도 도움이 된다. 후보 풀을 고정한 재순위화 실험과 검색 경로를 바꾼 실험을 동시에 섞으면 무엇이 개선됐는지 알기 어렵다. 같은 질의 집합과 예산을 유지하고 한 지점씩 바꾸는 것이 우선이다. 실제 비용과 호출 횟수는 내 로그에서 측정해야 하며, 논문의 최대 호출 상한을 비용 절감 효과로 변환할 수는 없다.
가져갈 결론과 남겨 둘 한계
ScholarCatalyst가 던지는 질문은 문헌을 얼마나 많이 읽었는지가 아니라, 다음 연구를 움직일 문헌이 검색 목록에 들어왔는지다. 연구용 검색 도구를 만들고 있다면 에이전트 단계를 추가하기 전에 평가 정답의 의미, 검색 후보의 회수, 최종 선택의 근거를 각각 기록해 보는 편이 낫다. 이것은 새로운 검색 모델을 선택하라는 만능 처방이 아니라 어디에서 실패했는지 구분하자는 제안이다.
한계는 결과 해석에 직접 영향을 준다. 데이터는 2025–2026년의 컴퓨터과학·AI 프로젝트에 집중되고 분야별 대표성도 고르지 않다. 저자 라벨에는 회고적 판단이 들어가며, 모든 사람이 합의할 수 있는 인간 성능 상한은 확립되지 않았다. 공동저자 일치도에 관한 예비 관찰도 논문 하나와 주석자 세 명에 한정된다. 이를 보편적인 인간 최고점으로 제시할 수 없다.
공개 코드와 데이터가 있다고 보고 성능의 독립 재현이 끝난 것도 아니다. 이 글은 소스 수집 단계의 질의 개수 대조를 재사용하고, 본문과 평가 코드의 정의를 확인했지만, Table 3의 모델 실행이나 전체 코퍼스 행 수 재집계를 하지 않았다. 공개 저장소와 데이터 카드의 CC BY-NC 4.0 표기는 상업적 이용의 일괄 허가가 아니다. 이 글의 그림은 데이터셋 예시나 원 논문의 도판을 복사하지 않고, 인용한 사실·보고값과 별도로 표시한 운영 제안을 자체 구성한 도식이다.
함께 읽으면 좋은 글
- 6일 동안 코드는 다 썼는데 연구는 두 편 모두 탈락했다: CRUX가 다룬 연구 결과물의 완성도와 이번 글의 선행 문헌 검색은 서로 다른 단계다. 검색 성공을 연구 성공으로 바꾸어 읽지 않기 위해 함께 볼 만하다.
- FastE의 압축 타이밍: 문서 임베딩 계산 비용과 기존 순위 점수의 보존을 다룬다. 이번 글은 그보다 앞서 어떤 문헌을 유용하다고 평가할지의 문제를 다루므로, 속도와 검색 목표를 분리하는 데 도움이 된다.
출처와 검증 범위
- ScholarCatalyst arXiv v1 초록·버전
- v1 전체 본문: 3.1–3.3절의 과제·표본·라벨, Table 3의 질의 유형별 결과, 4.2–4.4절의 후보 회수 분석, 부록 C.3의 예산·순위 보충, 5절의 한계.
- 저자 저장소의 고정 커밋: 평가 디렉터리의
calculate_metrics.py에서recall_at_k정의를,evaluate.py에서 질의별 평균 처리를 확인했다. - 데이터의 고정 리비전: 질의 유형·프로젝트 수 대조와 데이터 카드의 범위·라이선스 확인.
AI를 활용해 소스 근거를 대조하고 한국어 해설과 진단 도식을 작성했다. 표와 그래프는 저자 보고 결과이고, 진단표는 필자의 분석이다. 새로운 모델 성능 측정이나 독립 재현을 주장하지 않는다.


댓글
댓글 쓰기