스킬을 나눴다면 언제 읽을지도 써라: SkillJuror의 구조 비교 실험
에이전트가 긴 스킬 문서를 읽고도 검증 단계에서 같은 실수를 반복한다면, 내용을 더 붙여야 할까, 파일을 나눠야 할까? 파일을 잘게 나누면 첫 화면은 깔끔해진다. 하지만 필요한 순간에 참조를 열지 않거나, 열어 놓고도 결과에 반영하지 않는다면 정리는 성능 개선이 아니다. 중요한 질문은 문서 길이가 아니라 어떤 상황에서 어떤 자료를 읽고, 그 자료로 무엇을 할 것인가다.
2026년 6월 10일 제출된 arXiv 프리프린트 SkillJuror: Measuring How Agent Skill Organization Changes Runtime Behavior는 같은 작업 지식을 평평한 문서와 필요할 때 읽는 참조 묶음으로 배치해 비교했다. 이 글은 선정 당시 보존한 논문 v1 본문과 커밋 고정 저장소 자료에 근거한 해설이다. 모델 실행, 저자 판정의 재채점, 전체 실험의 독립 재현은 수행하지 않았다. 실용 산출물은 스킬의 내용을 어디에 둘지 정하는 판단표와, 파일 접근을 실제 활용으로 바꾸는 문장 예시다.
1. 410회는 과제 수가 아니라 조건별 반복 실행 수다
주 비교는 SkillsBench의 82개 과제다. 각 과제를 조건마다 다섯 번 실행했으므로 한 조건에 410회, 스킬 없음·평평한 Baseline·Progressive Disclosure(PD)의 세 조건 전체에 1,230회가 있다. 410개의 독립 과제를 평가한 것이 아니다. 실행 모델은 GPT-5.4 high reasoning, 하네스는 Codex, 작업 환경은 Harbor 기반 샌드박스로 조건 간 고정했다. 구성 검사를 통과한 88개 과제와 실제 실행한 82개도 구분해야 한다. 실행 전 외부 자격 증명이 필요한 과제와 극단적인 토큰 꼬리 사례 등을 제외했다.
Baseline은 지식을 단일 진입 문서로 모으고, PD는 간결한 SKILL.md에서 필요할 때 지원 파일로 이동하도록 한다. 연구진은 명령, 제약, 보조 도구와 출력 계약이 보존되는지 결정적 검사와 의미 루브릭, 증거 기반 판정으로 점검했다. 따라서 서로 다른 스킬의 내용이 우연히 좋았던 비교보다 구조 효과를 따져 보기 좋은 설계다. 다만 이 점검이 의미 동등성의 수학적 증명은 아니다. 표현의 강조나 조건을 다시 찾기 쉬운 정도는 달라질 수 있다. 내용을 고정하려는 비교이지, 구조가 내용보다 중요하다는 비교가 아니다.
2. 성공률은 조금 올랐지만 확실한 보편 효과는 아니다
논문 표 3의 엄격한 통과는 검증기 보상이 정확히 1인 실행만 센다. 스킬 없음은 119/410회, 29.0%다. Baseline은 172/410회, 42.0%이고 PD는 189/410회, 46.1%다. 두 구조의 차이는 통과 17회, 약 4.15%포인트다. 상대 개선율 4.15%로 바꿔 말해서는 안 된다.
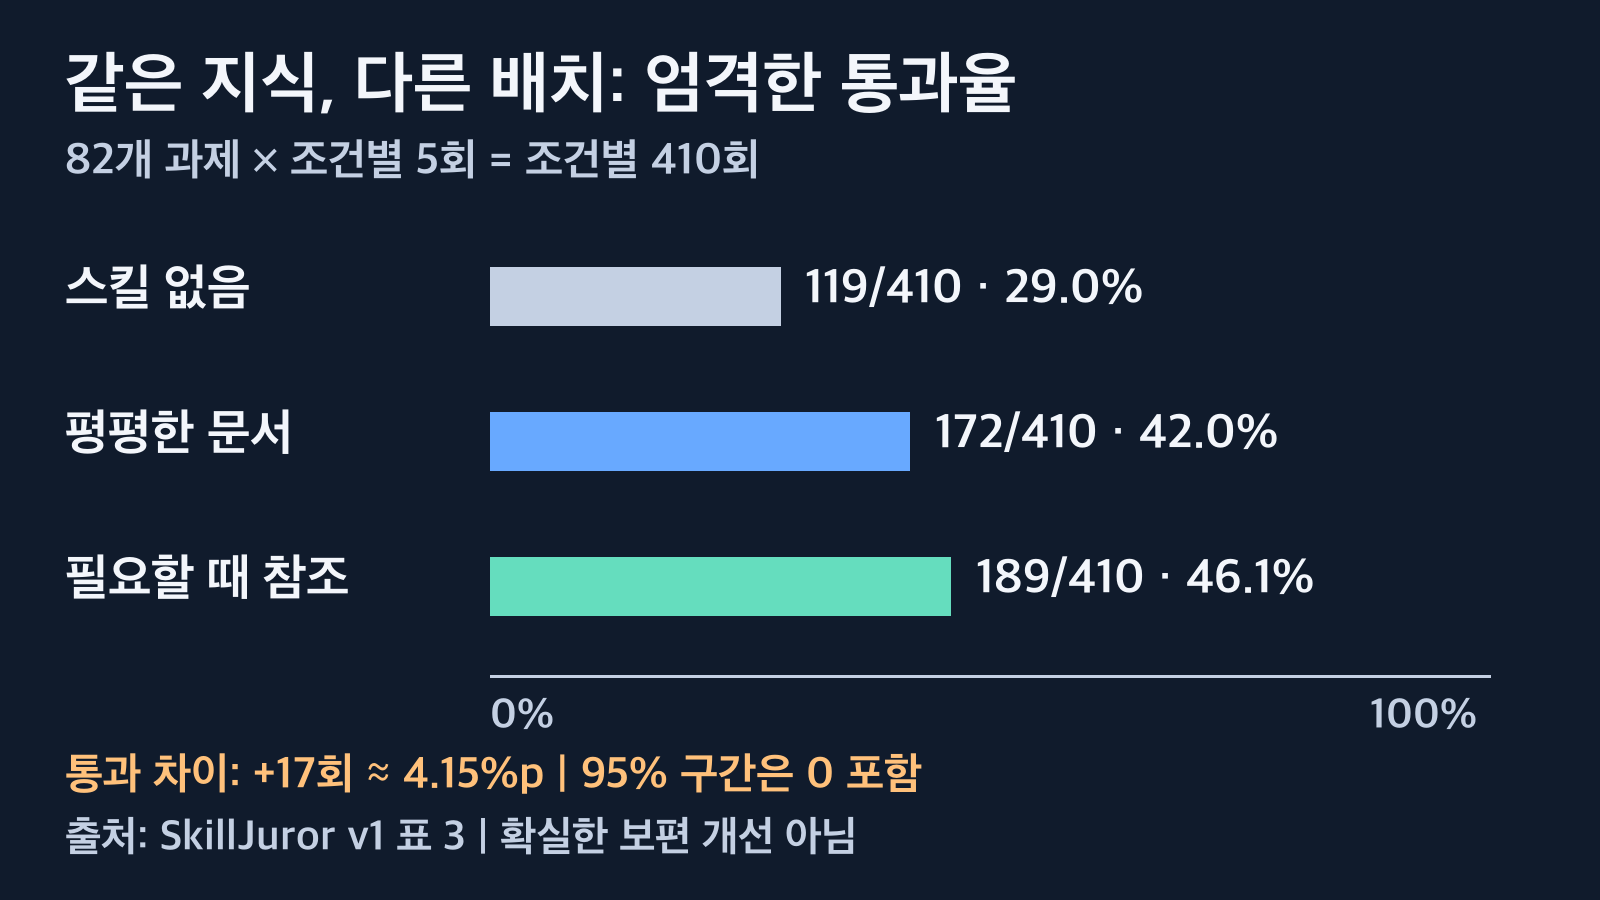
엄격한 통과는 PD가 17회 많지만, 약 4.15%포인트의 차이에 대한 저자 보고 신뢰구간은 0을 포함한다. 410은 과제 수가 아니라 조건별 반복 실행 수다. 출처: arxiv.org/html/2606.11543v1.
저자가 보고한 과제 단위 짝지은 95% 신뢰구간의 반폭은 ±6.0%포인트다. 관찰된 차이보다 반폭이 크므로 구간은 0을 가로지른다. 이 묶음에서 평균 차이는 양수지만, “구조를 나누면 통계적으로 확실하게 좋아진다”는 결론은 나오지 않는다. 과제별로도 PD가 나아진 것은 23개, 같았던 것은 44개, 나빠진 것은 15개다. 전체 성공률만 보고 조직의 모든 스킬을 한꺼번에 분리하기에는 근거가 좁다.
더구나 실행이 끝났다는 것과 검증기가 정답으로 인정했다는 것은 다르다. video-tutorial-indexer 사례는 양쪽 모두 런타임 완료가 5/5였지만 엄격한 통과는 5/5에서 2/5로 줄었다. 연구진의 사례 설명에서는 경로 수리와 느린 ASR 처리에 작업이 늘어났고, 정확한 결과물 구조를 맞추는 문제가 남았다. 이는 선택된 궤적의 설명이며 모든 미디어 작업에 적용되는 인과 법칙은 아니다.
3. 읽은 파일 수와 실제 활용을 분리해서 보자
구조 변화가 가장 크게 드러난 곳은 작업 중 행동이다. 궤적당 서로 다른 스킬 자원 접근 수인 fanout은 1.18에서 3.85로 늘었다. 실제 활용으로 판정된 ERU-positive 사건의 평균도 궤적당 1.33에서 3.92로 늘었다. 이 두 지표는 서로 다른 분모와 의미를 갖는다. 파일 접근 수가 늘었다는 이유만으로 구현이 좋아졌다고 볼 수 없다.
ERU(Effective Resource Uptake)는 자료의 내용, 보조 도구 출력, 진단 신호가 관찰 가능한 구현·검증·수정·타당한 막힘 진단으로 이어졌는지를 본다. 단순히 디렉터리를 훑거나 파일을 여는 것만으로 인정하지 않는다. 예를 들어 참조를 읽은 뒤 거기에 적힌 검사를 실행하고, 검사 결과에 따라 구현을 고쳤다면 활용의 연결고리가 있다. “참조를 확인했다”는 최종 보고만 있고 뒤따르는 행동이 없다면 접근과 활용을 같은 것으로 기록해서는 안 된다.
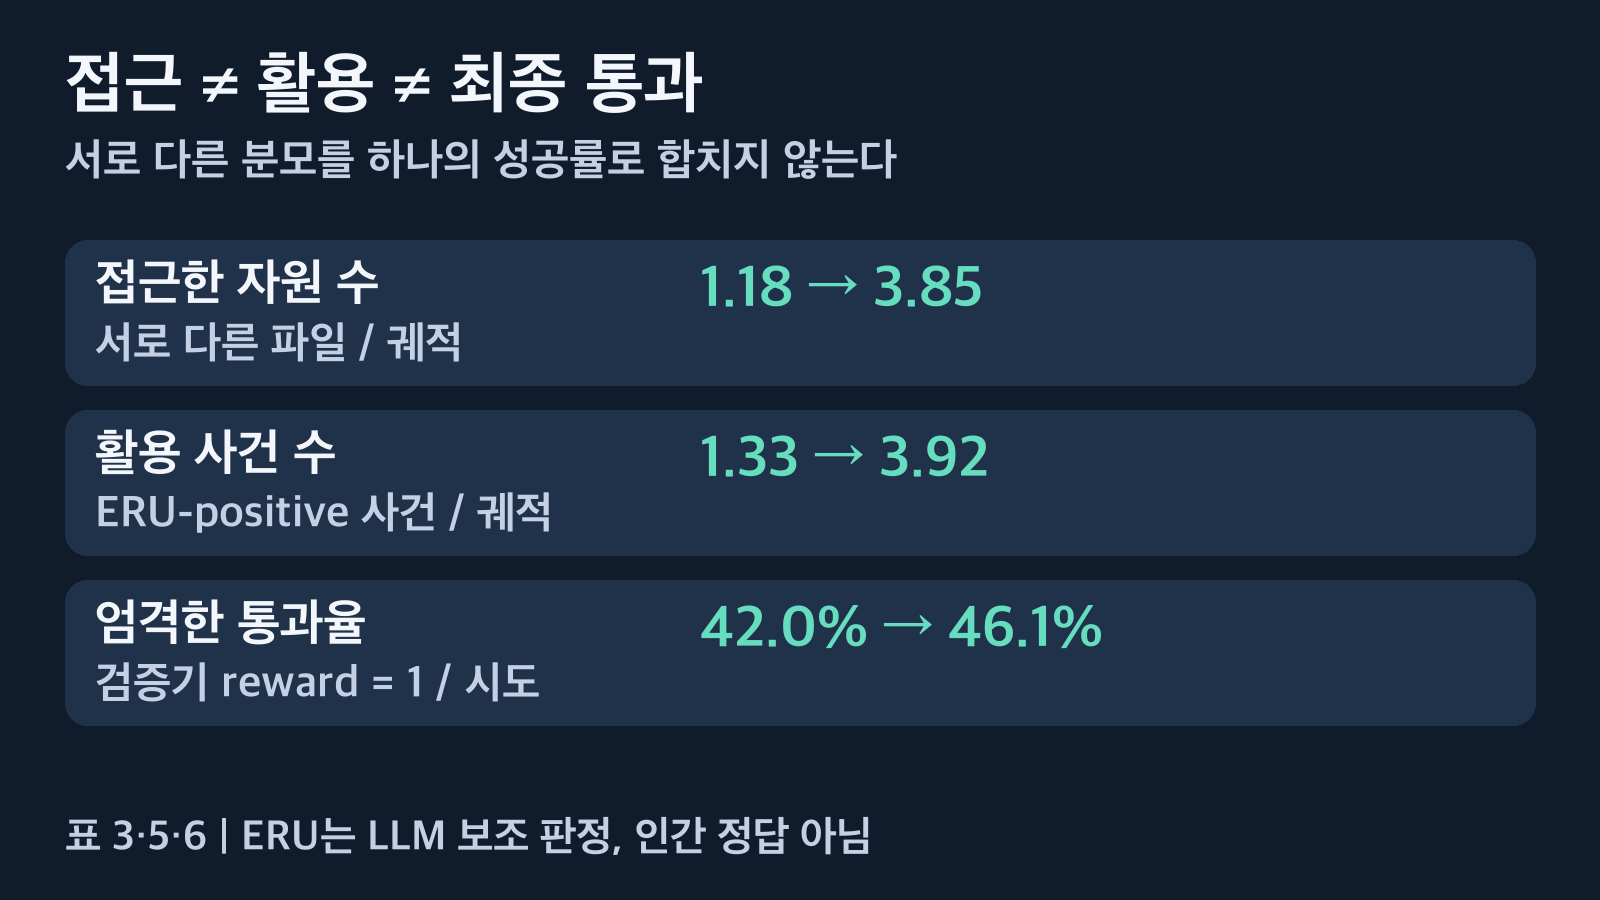
Baseline에서 PD로 바뀔 때 접근과 활용은 늘지만 최종 통과와 같은 지표가 아니다. ERU는 LLM 보조 판정이며 사람의 정답 정확도가 아니다. 출처: arxiv.org/html/2606.11543v1.
표 6의 ERU 비율은 76.0%에서 84.6%로 변했다. 이것은 성공률도 사람의 정답 판정 정확도도 아니다. 이벤트 수준의 LLM 보조 판정이며, PD에는 판정 불명 사건 하나가 있어 비율 계산에서 제외된다. 이 연구가 보여주는 것은 접근과 활용의 행동 변화이지, 활용 증가가 성공률 증가를 얼마나 매개했는지의 확정적 인과 추정이 아니다. 자체 운영에서는 파일을 연 기록과 그 자료를 사용한 행동, 마지막 검증 결과를 서로 다른 칸에 남기는 편이 유용하다.
4. 시간은 줄어도 비용까지 줄었다고 하면 틀린다
표 3의 통과당 시간은 Baseline 20.1분에서 PD 17.8분으로 줄었다. 그러나 같은 표의 추정 비용은 통과당 1.28달러에서 1.31달러로 조금 늘었다. 시도당 추정 비용도 표 4에서 0.54달러에서 0.61달러로 늘었다. 따라서 이 논문을 “PD로 비용을 절감했다”는 사례로 소개하면 서로 다른 지표를 섞게 된다.
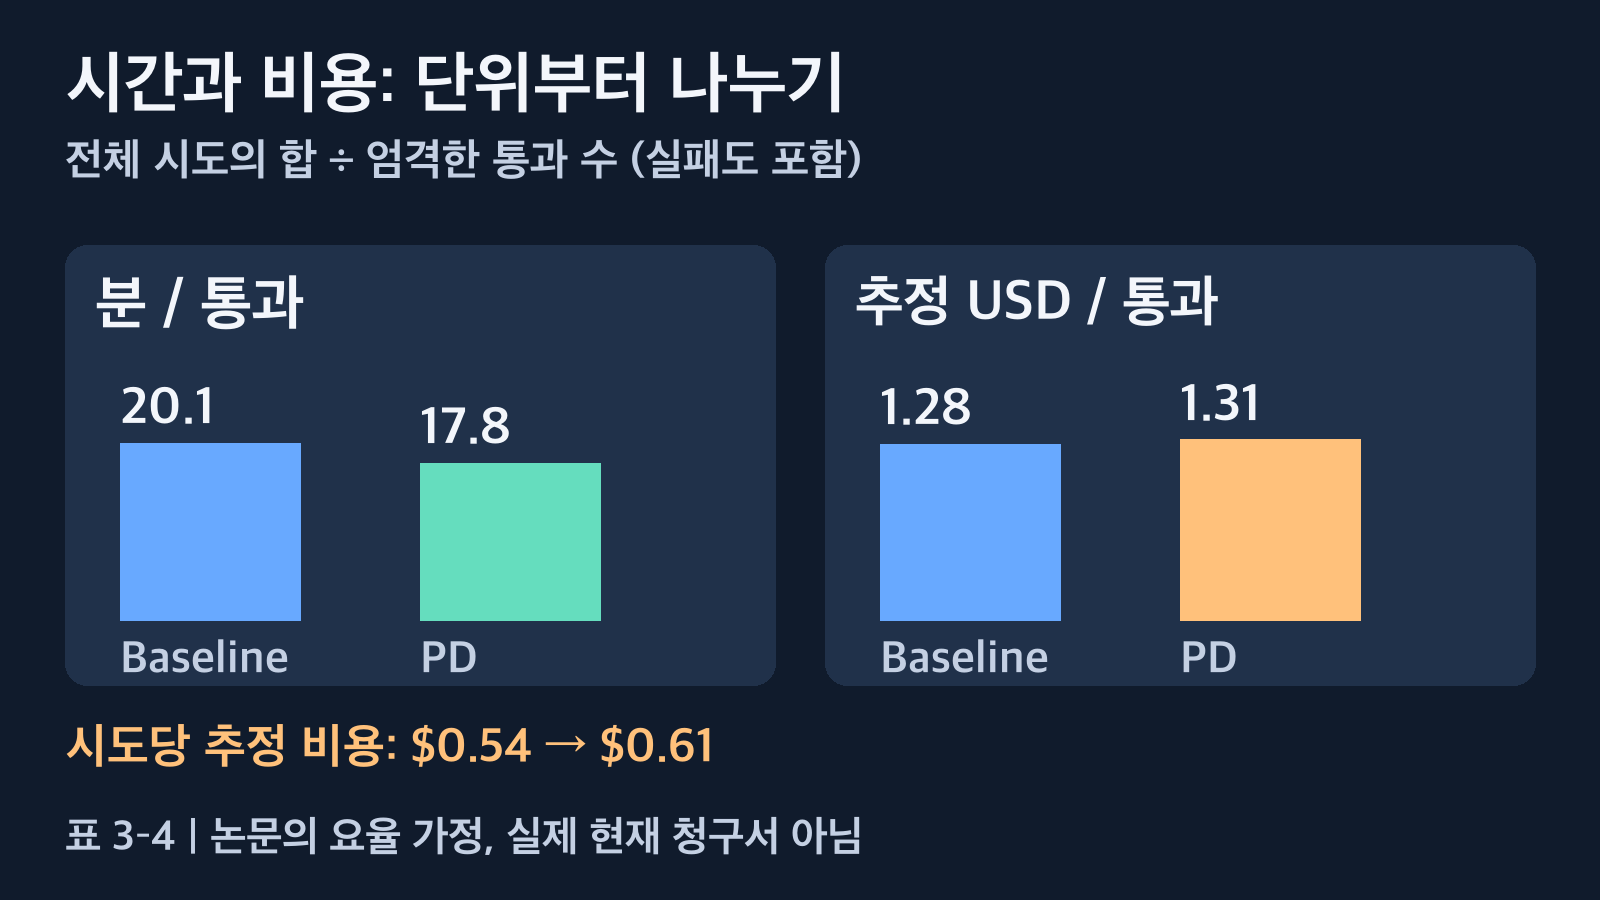
통과당 지표는 실패를 포함한 모든 시도의 합을 엄격한 통과 수로 나눈다. 시간과 달러 패널은 독립 축이며 추정 비용은 논문의 요율 가정이지 실제 현재 청구서가 아니다. 출처: arxiv.org/html/2606.11543v1.
통과당 지표의 분자는 성공 실행만의 시간이나 비용이 아니라 실패를 포함한 모든 시도의 합이다. 이를 엄격한 통과 수로 나눈 값이다. 성공한 실행만의 평균, 모든 시도의 평균과 구분해야 한다. 실패가 줄면 이 분모 정규화 지표가 좋아질 수 있어도, 시도 하나의 가격은 더 높아질 수 있다. 시간과 달러를 한 축으로 비교하거나 하나의 “효율 점수”로 섞지 않는 이유다.
비용 역시 실제 현재 청구서가 아니다. 논문 부록 C의 GPT-5.4 표준 요율 가정에 따른 추정이며, 가격 자료의 접근 날짜는 2026년 6월 4일이다. 표시 토큰 합계는 캐시 읽기를 제외하지만 비용 계산은 캐시 읽기를 분리해서 반영한다. 자체 환경에서 도입을 판단할 때는 현재 요금과 캐시, 실패·재시도까지 포함한 비용을 따로 측정해야 한다.
5. 배치 판단표: 줄 수가 아니라 탈락 조건과 읽을 시점
PD 구성 루브릭은 루트를 최대 300줄로 두고, 독립적인 비코드 지원 자료와 명시적인 언제·왜 라우팅을 요구한다. 이것은 해당 실험의 구성 조건이지 모든 스킬의 최적 길이 기준은 아니다. “300줄 이하”만 맞추고 중요한 조건을 숨기면 연구가 겨냥한 구조와는 멀어진다.
최종 결과를 탈락시키는 조건은 루트에서 보이게 하고, 자세한 절차에는 읽을 시점과 읽은 뒤 할 행동을 붙인다. 아래 배치 판단표와 예시는 논문에 근거한 편집자의 제안이며, 효과를 측정한 독립 실험이 아니다.
| 넣을 내용 | 배치 후보 | 루트에서 보일 안내 | 확인할 행동 증거 |
|---|---|---|---|
| 결과 파일명·필수 키·정확한 허용 오차 | 핵심 조건은 루트, 세부 계약은 참조 | 결과를 제출하기 전 계약을 확인하라 | 최종 파일에 실제 검증을 실행했는가 |
| 긴 설치·환경 진단 절차 | 환경 참조 파일 | 환경 오류가 발생하면 읽어라 | 오류 신호와 적용한 진단이 연결되는가 |
| 구현 중 사용할 예제·테스트 절차 | 작업별 참조 파일 | 해당 구현을 시작하거나 수정할 때 읽어라 | 참조 이후 구현·검사·수정이 있는가 |
| 고정된 출력 형식만 요구하는 짧은 작업 | 일단 평평한 문서 유지도 후보 | 필수 계약을 한눈에 제시하라 | 분리 후 조건 누락이나 경로 수리가 늘었는가 |
가령 루트의 “자세한 내용은 references/output-contract.md 참고”는 위치만 알려 준다. 이를 “결과 파일을 만들기 전 references/output-contract.md를 읽어 필수 키와 정렬 규칙을 확인하고, 제출 직전 같은 계약으로 결과 파일을 검사하라”로 바꾸면 시점·목적·행동이 드러난다. 이 파일명은 설명을 위해 만든 예시이며 저자 저장소의 실제 파일을 실행했다는 뜻이 아니다. 참조로 옮긴 규칙은 이전 버전과 같은 값과 의무를 유지해야 한다. 구조를 바꾸면서 규칙까지 고치면 어떤 변경이 결과에 영향을 줬는지 분리하기 어렵다.
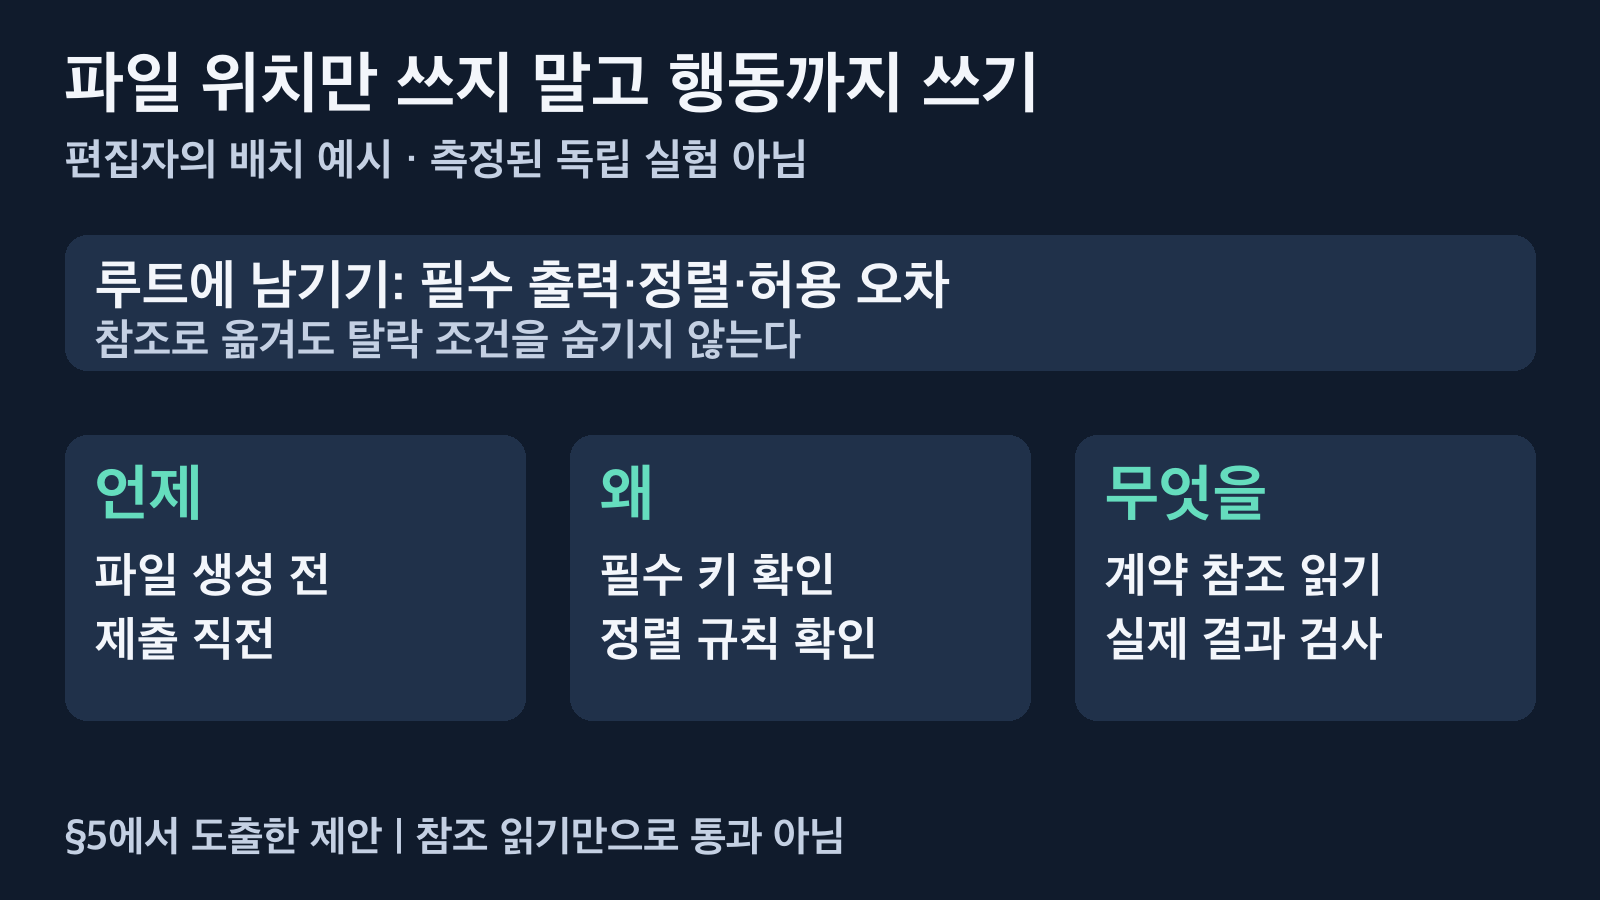
루트에서 탈락 조건을 숨기지 않고 참조의 언제·왜·행동을 명시하는 편집자의 제안이다. 논문이 이 예시의 효과를 독립 측정한 것은 아니다. 출처: arxiv.org/html/2606.11543v1.
단순히 전부 분리하는 것도 답은 아니다. 논문의 exoplanet-detection-period 사례에서는 여러 참조를 활용해도 엄격한 수치 계약을 충족하지 못해 통과가 5/5에서 3/5로 줄었다. 반대로 simpo-code-reproduction에서는 참조를 구현과 단위 검사에 연결한 사례가 0/5에서 5/5로 바뀌었다. 이 두 사례는 “과학은 평평하게, 코드는 분리하라”는 검증된 분류 규칙이 아니다. 독자가 확인할 지점은 자기 작업에서 참조가 정답 판정과 연결되는지, 분산된 조건이 누락되는지다.
6. 도입 여부는 네 기록으로 판단한다
파일 배치를 바꿀 때는 기존 지식을 보존한 비교본을 남기고, 같은 모델·하네스·작업 조건에서 반복 결과를 보아야 한다. 운영상 제안으로는 접근, 활용, 최종 계약 통과, 전체 시도 비용의 네 기록을 나눌 수 있다. 접근이 늘고 활용이 늘어도 마지막 계약 통과가 줄었다면, 더 많은 참조를 추가하기보다 탈락한 조건이 어느 파일에 있었는지 먼저 찾는다. 반대로 필요한 참조를 읽고 바로 테스트를 실행했다면, 다음 수정에서는 그 연결을 유지할 이유가 생긴다.
특히 경로 오류를 고치느라 지원 파일을 계속 왕복하는 경우에는 탐색의 증가를 성과로 세지 않는다. 참조를 열지 못했는지, 열었지만 행동에 쓰지 않았는지, 행동에 썼지만 최종 수치·형식이 틀렸는지는 서로 다른 실패다. 이 구분은 어떤 자료를 루트로 되돌릴지 판단하게 해준다. 다만 이러한 관찰 설계 자체의 효과를 이 글에서 시험한 것은 아니다.
관련해서 하네스를 고치는 모델과 실제로 이득을 보는 모델은 다르다는 좋은 지침을 작성하는 능력과 이를 불러와 따르는 능력을 분리한다. 이번 글은 작성자와 수행자 모델의 비교가 아니라 같은 지식의 배치를 바꾼 비교라는 점에서 다르다. 변경 후 A/B 검사를 계획한다면 코딩 에이전트 A/B 테스트, 113개 중 22개만 한 번 실행에 버텼다도 참고할 만하다. 그 글은 평가 표본 선택 문제이며, 이번 논문의 구조 효과를 추가로 검증한 자료는 아니다.
7. 공개 코드의 범위와 이 글의 검증 경계
논문에 연결된 공개 저장소는 커밋 d744917d4fef694f1e5b7bece80f87aacfb51a96의 README를 확인했다. 공개 범위는 스킬 변형을 준비하고 런타임을 실행해 trajectory.json을 남기는 도구다. 사용자가 원본 과제와 스킬 묶음을 공급해야 하며 평가·판정·집계 보고·결과 뷰어는 현재 공개 범위 밖이다. 코드를 볼 수 있다는 사실을 전체 수치가 바로 재현 가능하다는 뜻으로 바꾸지 않았다.
연구의 한계도 남는다. 한 가지 주 모델·하네스 구성과 과제 조건당 다섯 번의 실행, 형식적 동등성 증명이 아닌 의미 보존 감사, LLM 보조 활용 판정에 묶여 있다. 사내 스킬, 실시간 API, 사람 평가 업무, 다른 플랫폼으로의 일반화는 별도 문제다. 뉴스처럼 새로 나온 논문이라고 소개하는 것도 피한다. 이 글은 보존된 6월 프리프린트를 다시 읽는 적용 해설이다.
결론은 “스킬을 잘게 쪼개라”가 아니다. 읽을 시점과 이유를 쓰고, 그 읽기가 구현·검사·수정으로 이어졌는지 보라. 구조가 만든 행동 변화와 최종 통과, 비용을 나누면 깔끔해진 문서가 정말 도움이 됐는지 더 정직하게 판단할 수 있다.
출처
- SkillJuror 논문 v1 전문: §3.2–3.4의 구성·지표, §4.1의 실행 조건, 표 3–6의 결과·시간·비용·활용, §4.5.2의 사례, §6의 한계, 부록 C–D의 계산·판정 범위.
- SkillJuror 논문 v1 서지: Zhiyu Chen 외, 2026-06-10 최초 제출.
- 커밋 고정 Runtime Toolkit README: Included Modules, Runtime Capture, 공개 평가 모듈 제외 안내.
이 글의 도식은 논문의 수치와 본문 해석을 바탕으로 직접 구성했다. 논문 그림이나 제품 화면의 복제물이 아니다. 원고 구성과 표현 정리에 AI 도구를 사용했다.


댓글
댓글 쓰기